在 Gemini Omni 1.1 Flash 上做照片级的人:先把「beautiful」这个词删掉
让一个生成出来的人看起来最假的最快办法,就是要求他好看。
写下 beautiful woman, perfect skin, flawless, stunning,模型会照办——它去够的是训练数据里这些说明文字所在的那片区域,也就是修过的商业摄影。毛孔没了,不对称没了,那些让一张脸读起来像被某个人住着的细微张力也跟着没了。输出里没有一处是错的。这条 prompt 要的是一支美妆广告,它拿到了。
Google 自己的 prompt 建议用一句话指向了相反的方向——*「在描述角色和环境时要极其详细。」*是详细,不是恭维。这是两条不同的指令,产出的也是两张不同的脸。下面讲的就是这个差别:脸、手、您关不掉的音频,以及 Google 已经决定您不能去的地方。
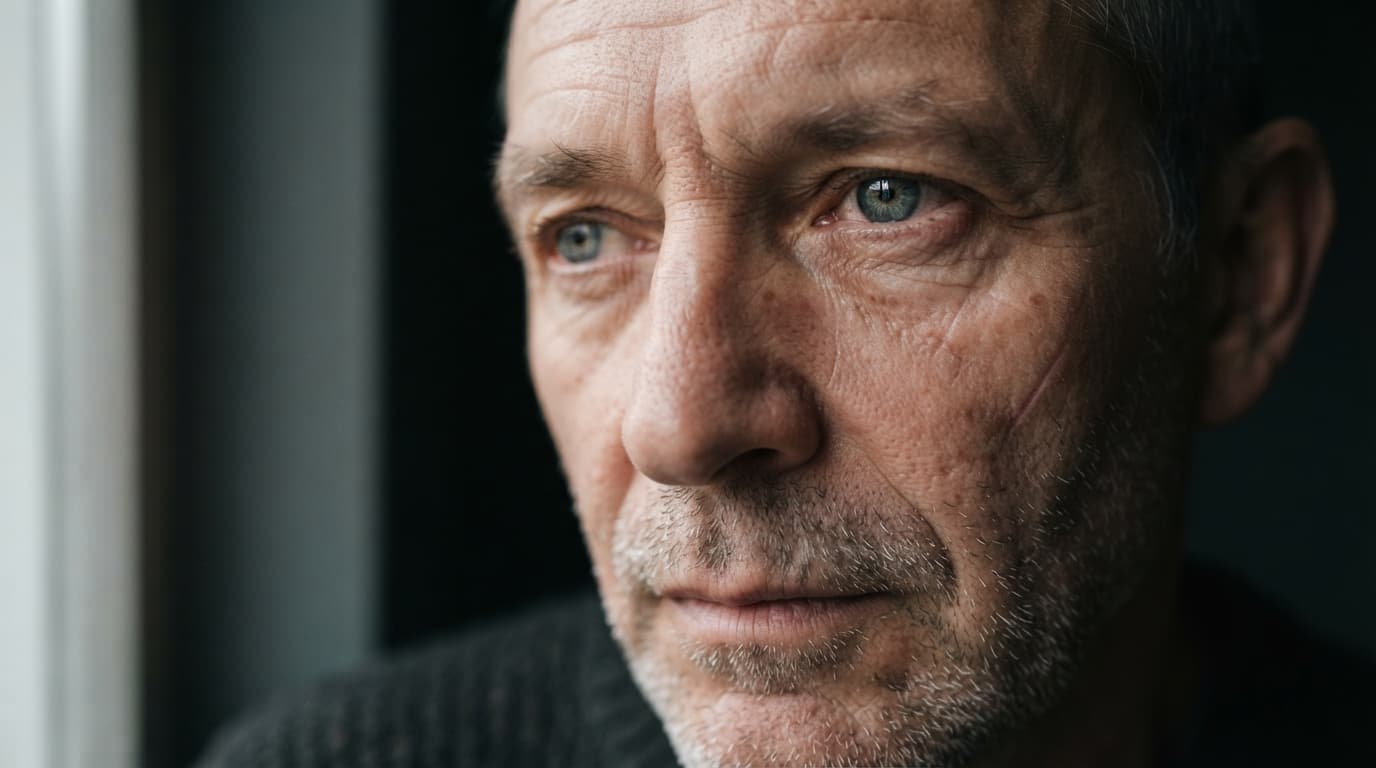
一张脸是一份事实清单,不是一份恭维清单
每一个形容词都是投给某个说明文字聚类的一票,而 gorgeous 投的是图库照。8k、hyperrealistic、masterpiece 来自图像模型的民间传说,在那里它们充当质量 token;而在一个没有采样参数的视频模型上,它们只会跟描述您这个镜头的那些词抢位置。替代品既具体又无聊,而这正是重点:
年龄写成一个数字或一个年代。「A woman in her late forties」是一条约束;「a young woman」是一张彩票。
**一处被点名的不完美。**一道凸起的疤,一颗磕缺的门牙,一个断过一次、接得略微歪掉的鼻子。一处就够了;三处读起来就成了角色设定表。
**把皮肤当成一个表面。**鼻子和脸颊上看得见的毛孔,额头上的油光,鼻翼处破裂的毛细血管。这是整条 prompt 里收益最高的一次替换:「perfect skin」和「visible pores across the nose」坐在说明文字空间的两个极端。
**给视线一个方向和一次变化。**不是「looking at the camera」,而是「reads something off frame to the right, then her eyes flick to the lens for about a second and away again」。整条片子里不间断的目光接触是几乎没有人会做的事,所以一条没写清楚的视线,会让模型在观众最先读到的那件事上瞎猜。
一个有时间点的微表情。「The corner of her mouth tightens once.」一个被安排好的事件胜过「emotional」,因为模型能安排一个事件,安排不了一个抽象概念。
**除了皮肤以外的一切都要有磨损。**一条洗过两百次的领子,一根软掉的表带,文件上的一圈咖啡渍。服装比脸更可靠地把一个人卖出去。
把这笔交易写实。先看那个像图库照学会了眨眼的版本:
A beautiful young woman with perfect flawless skin sits by a window,
looking at the camera. Cinematic, photorealistic, 8k, ultra detailed,
masterpiece, stunning gorgeous eyes, professional studio lighting, sharp
focus, high quality, award winning photography, perfect symmetry, smooth
glowing complexion, elegant, breathtaking, hyperrealistic render,
trending, best quality, dramatic mood, beautiful composition.
那些词里大多数描述的是一张照片;没有一个描述一个人。改写版保住了镜头,把每一句恭维换成了一个事实:
In a single continuous shot, no scene cuts. Close-up of a woman in her
late forties sitting at a kitchen table beside a north-facing window.
Faint vertical lines between her brows, a small raised scar on the left
side of her chin, uneven eyebrows, a few grey hairs escaping a loose tie.
Skin carries visible pores across the nose and cheeks and a slight shine
on the forehead, no makeup on the jawline. She reads something off frame
to the right, then her eyes flick to the lens for about a second and away
again. The corner of her mouth tightens once. Soft window light from
camera left, one dim practical behind her. Shallow depth of field, 50mm.
Sound design: a kettle settling in the next room, distant traffic.
No dialogue.
第二个版本里没有一处在要求质量。它提供了一种可渲染的质感、一个视线的理由和一个有时间点的事件——三样模型能照做的东西,而「stunning」是三样它做不了的东西。也请注意开头那条镜头数量的从句:Omni 默认会搭出好几个镜头,这一点我们在prompt 指南里讲过,而一个六秒里切两刀的人物镜头是保不住一张脸的。
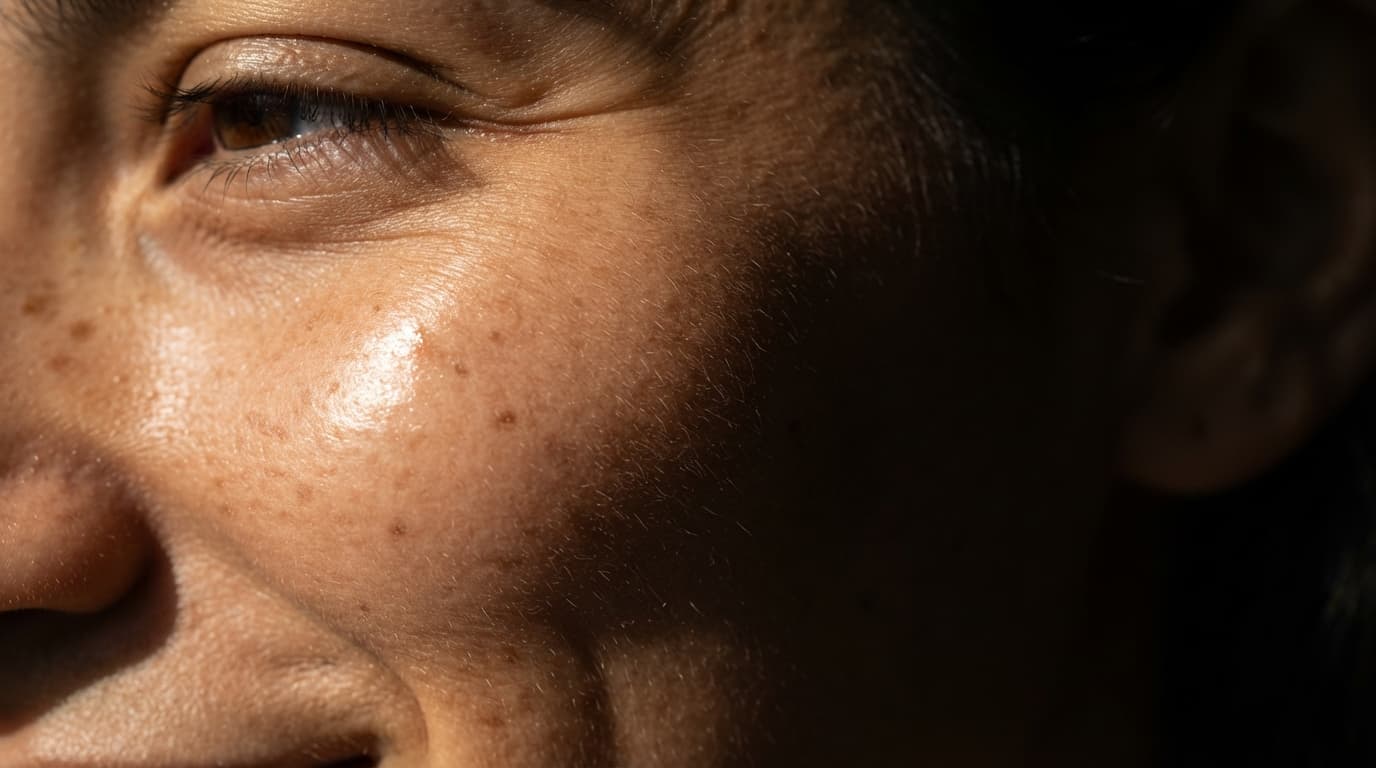
关于眼睛有一条提醒:「wet eyes」和「glossy tear film」是穿着技术外衣的质量词,它们点的是一处高光而不是它的成因。给眼睛一件事做,让高光从您已经指定过的光里自然生出来。
手:给它们派个活儿
手是生成式视频的传统尴尬,至今仍是最容易毁掉一条片子的东西。DeepMind 的模型卡没有单独点它们的名,但它点了它们所属的那个类别:*「在编辑全程保持完全的一致性、生成带有复杂运动的场景,或者渲染完全准确的文字,仍然是一项挑战。」*手指就是画面中一小块区域里的复杂运动,关节方式多样,而且不断自我遮挡。
解法是反直觉的。别去描述手——给它们派一个任务。一只以某种明确握法拿着某个具体物件的手,有一个形状和一个接触点可以锚定。「Beautiful, elegant hands」两样都不提供,还把手指数量留给了模型去发明。
对比一下:
- 弱:her hands rest naturally at her sides
- 更好:she holds a chipped enamel mug in both hands, thumbs overlapping on the near side
- 弱:he gestures while speaking
- 更好:he turns a pen over in his right hand twice, then sets it down on the papers
每一对里的第二种写法都隐含地固定了手指数量,给了动作一个开始和一个结束,还产出了一个您可以在上面剪的节拍。
有一条限定说明管着本文里每一个第三方数字。我们能找到的两篇已发表的上手评测——invideo 那篇和 JXP 团队的多轮测试,署期 2026 年 5 月 21 日——都把被测模型写成 Gemini Omni Flash,两篇里任何地方都没有 1.1 这个后缀。两篇都不是在测本文所讲的这个模型;把它们当作关于这个家族的证据来读。JXP 报告说,在一个小提琴镜头的第五轮编辑上,*「她的左手从指板上轻微滑开了。」*手先垮,而其他一切还都撑着。
还有两条不花钱的规则。把手保持在同一个焦平面上——一只朝着广角镜头伸过来的手,是您能提的最难的要求。以及让手离脸远一点,因为两个困难结构之间的遮挡会让失败叠加,而不是相互平均。
不管您是不是有意的,您都在指导一个声音
这里的音频是原生的:与画面在同一次生成里产出,没有任何参数能关掉它,我们查过的提供商里也没有一家把它单独计费。所以一条对声音只字未提的 prompt 并不是在要求安静——它是一份没人盯着的任务书,而模型会把它填满。
所以要有意识地写音频,用它自己的句子。Google 写进文档的对白形式是一个冒号,不带引号——the man says: We lost it——而那个被反复转述的、说引号会触发 lip sync 模式的说法,在任何 Google 文档里都不存在。
有四件事决定一个说话的镜头成不成:
**台词长度。**invideo 在一篇把被测模型写成 Gemini Omni Flash 的评测里报告说,*「单人说话时,lip sync 大概能撑到 6 到 7 秒,之后就开始掉。」*这是一个方向而不是一项规格,但它指向同一处:一句四到十二个词、放在前面的台词,接着是沉默和一个反应,胜过一句拖满整条片子的话。
**画面里只放一个说话的人。**同一篇评测说得很直接:*「一个画面里两个说话的人仍然是弱项,因为 Omni 经常掉 sync 或者把对白安错人,所以今天单人镜头才是稳妥的选择。」*把第二个人做成画面边缘一个失焦的肩膀,他那句台词单独生成一条。
**用散文来指导声音。**这里没有声音参数,所以口音、年龄、音区和节奏都作为普通英文写进去:tired, quiet, American accent, no rise at the end。
**明确要求安静。**写 No dialogue. 或者 No music.
一个对白镜头的前后对照。弱的那版把上面每一处错误一次犯全了——画面里两个说话的人、引号、一人一句、用形容词顶替指导:
A man in an office says "We lost the contract" to his colleague and she
replies "I know" while they talk to each other, both very emotional,
dramatic scene, cinematic dialogue, photorealistic, perfect lip sync,
realistic voices, high quality conversation, intense acting, beautiful
faces, professional film look, 4k, detailed, award winning drama scene.
改写版把一个说话的人挪出画面,把台词砍到四个词,并且描述这个声音而不是夸它:
In a single continuous shot, no scene cuts. Medium close-up of a man in
his early fifties in a glass-walled meeting room after hours, tie
loosened, two days of stubble, a coffee ring on the papers in front of
him. He is alone in frame; a second person's shoulder sits out of focus
at the right edge. He turns a pen over in his right hand twice, sets it
down, and looks up. The man says: We lost it. Tired, quiet, American
accent, no rise at the end. He holds the look for a beat, then glances
down. Overhead fluorescents plus city light through the glass, 50mm,
shallow depth of field. Sound design: air conditioning hum and one
distant door closing. No music.
她那句回话属于第二次生成,取景对着她——两条片子而不是一条,而且仍然比把一个双人对话重跑八次、指望 sync 同时落在两张脸上要便宜。
有一条写进文档的边界:您不能拿一段上传的、有人在说话的视频,然后用新的对白把它延伸下去。这是被扣住了,不是没做出来,模型卡把话说得很白——*「作为视频编辑能力的一部分,Gemini Omni Flash 能够改变人的话语。目前我们正在限制这项能力,并努力更好地理解如何安全、负责任地把它带给用户。」*模型能给一个人重新配音;Google 决定您不可以。配音在这里不是一个您能造出来的产品。
人群、背景人物,以及不该把钱花在哪儿
背景里的人拿到的是剩下的那点注意力,而一条挤满行人的街道就是一排经不起按暂停键的脸。给一个数量——「four people at scattered tables」胜过「a crowded café」,因为含糊的数量是在邀请模型去近似。把他们放在焦平面之外,因为被浅景深的 50mm 柔化过的人形是可信的,而同样这些人形在 f/11 下清晰起来就成了一场差之毫厘的展览。再给他们每人一个动作,并且背对镜头:后脑勺是免费的。如果某张背景里的脸真的要紧,就把它提升为它自己的一个镜头。
一条片子要花多少钱,以及为什么 4K 才是要紧的那个数
脸就是您烧生成次数的地方——您为了视线重跑,然后为了手重跑,然后因为声音听着年轻了二十岁再重跑。诚实地给这项工作算价,意味着按条数算,而不是按片子算。而各家的差距在阶梯顶端最大。截至 2026 年 8 月 29 日,10 秒的 4K:
| 在哪里调用 | 10 秒 4K |
|---|---|
| E2X | 1.80 美元 |
| fal | 3.00 美元 |
| Google,直连 | 3.04 美元 |
| Runware | 3.20 美元 |
| WaveSpeed | 3.90 美元 |
Google 那个数字是从它公布的每秒 token 数推算来的,而不是一个标价,而 fal 的那个是把 Google 的清单转手过来,不是对算力的独立定价。这个差距是结构性的:从 720p 的基准往上,4K 那一档 Google 收三倍,我们收两倍。4K 上低 41% 是我们四档里差距最大的一档,而一条八秒的片子在我们这里是 1.44 美元,直连是 2.43 美元。逐家提供商的审计里有其余部分。
这道算术的另一半,是您在哪一档上做迭代。十遍 360p 的搜索加一遍 1080p 的收尾一共 1.73 美元,对着十遍直接跑 1080p 的 5.40 美元——多生成一次,省掉百分之六十八。草稿档的分辨率足够看清视线、走位,以及手有没有摸到杯子;不够看皮肤质感或 lip sync,所以在这个循环收口之后,预算里要留两条满分辨率的片子。还要问问这个镜头是不是真需要这个模型:Veo 3.1 Fast 在我们这里是每秒一美分,而对于一个不需要续接的单独人物镜头来说,那九倍的溢价买到的东西非常有限。
那些限制,直说
这不是一节免责声明。下面每一条都改变过某个人的项目计划。
**SynthID 在每一帧里,而且没有开关。**Google 的原话:*「所有生成的视频都包含 SynthID 水印,它对观看者不可见,但可以通过程序检测以验证来源。」*没有哪家提供商暴露了开关,而且因为这个水印被设计成能扛住重编码、裁剪和调色,「我们后期把它去掉」不是一个方案。如果某份交付合同禁止带水印的素材,在开渲之前就把它谈定。
**上传视频的编辑功能在欧洲经济区、瑞士和英国不可用。**Google 的原话,包括那个决定了这件事对您有多糟的括号:*「编辑或延伸上传的视频,目前对欧洲经济区(EEA)、瑞士和英国的用户不可用(编辑或延伸由模型生成的视频是支持的)。」*一个欧洲团队仍然可以生成一个镜头并延伸它自己的输出;它做不到的是把用户上传的素材接下去。这件事的后果我们在那篇讲四十秒场景的文章里讲过——这是本文里发现得太晚代价最高的一条。
**包含特定人物的上传会被拒绝。*同一节限制说明里还有两句,两句都限定在那些地区:「在欧洲经济区、瑞士和英国,不支持上传和编辑包含未成年人的图像」,以及「在欧洲经济区、瑞士和英国,不支持上传和编辑包含某些可识别人物的图像。」实际的拒绝面看起来比这个措辞更宽:JXP 在同一篇上一代模型时期的评测里报告说,一条点了某个真实品牌名字的 prompt 「在提交时就被拦下,给了一条通用的政策提示」,而一个要求「把一个通用成年角色变老十岁」*的请求同样被拦。别去搭一条依赖于「不会发生拒绝」的流水线。
**真实的人首先是一个法律问题,其次才是技术问题。**未经本人同意做出的、可识别为某个真实人物的形象,会撞上因司法辖区而异的人格权和形象权,而且并不会因为输出是合成的就被豁免。另外,欧盟 AI 法案第 50 条下的透明度义务自 2026 年 8 月 2 日起适用:部署者必须清晰地、在第一次接触时就披露内容是人工生成或经过操纵的。SynthID 回应的是一项机器可读的标记要求;它并不回应告知正在观看的那个人的义务。这是一个要和法律顾问一起做的标注决定,不是 API 调用里的一个开关。
一张生成出来的脸不是一个人,但它可以离一个人近到足以让某个人受到伤害。同意、披露,以及愿意不去做这个镜头,跟焦距一样属于这门手艺。
常见问题
在 Gemini Omni 1.1 Flash 上怎么把皮肤做真实?
描述这个表面,而不是夸它。「Perfect skin」「flawless」和「beautiful」选中的是修过的商业影像,会把质感抹平。把它们换成可观察的事实——鼻子和脸颊上看得见的毛孔、额头上的油光、一道小疤——并且写明年龄。Google 要求对角色做极其详细的描述,这跟要求一个好看的角色不是一回事。
为什么 AI 视频里的手会长歪,在 prompt 里怎么修?
手指是一小块自我遮挡区域里的复杂运动,而 Google 的模型卡把复杂运动点名为「仍然是一项挑战」的东西。给手派个活儿,而不是去描述它们:一个带明确握法的具体物件,或者一个有开始有结束的动作。让它们待在同一个焦平面上,并且离脸远一点。
能关掉 Gemini Omni 1.1 Flash 的音频吗?
不能。音频是与画面一起原生生成的,没有参数能关掉它,它也不在每秒价格之外单独计费。您可以用一句「Sound design:」以及明确的「No dialogue.」或「No music.」从句去指挥它,但没法拒绝它。要做无声播放,就把播放器静音。
Omni 的 prompt 里对白该怎么写?
用 Google 写进文档的形式:说话者、冒号、台词,不带引号。声音的指导跟在后面,用大白话写,因为这里没有声音参数——口音、年龄、音区和节奏全都以英文的形式送进去。台词要短,放在前面,描述语气而不是要求「emotional」的表演。
Gemini Omni 的 lip sync 能撑多久?
invideo 在一篇把被测模型写成 Gemini Omni Flash 而不是 1.1 的评测里报告说,单人说话时 lip sync 大概能撑 6 到 7 秒然后开始掉,并把一个画面里两个说话的人称为弱项,模型在那里会掉 sync 或者把对白安错人。这是一位评测者在更早一个模型上的发现,不是 Google 的规格,但它支持一次生成只放一个说话的人、台词要短并放在前面。
Gemini Omni 1.1 Flash 能生成一个真实人物的形象吗?
不可靠,而且动手之前要好好想想。Google 的文档说,在欧洲经济区、瑞士和英国不支持上传和编辑包含某些可识别人物的图像,而测试者报告说真实品牌名和普通的角色编辑都会被拒。撇开过滤器不谈,形象权因司法辖区而异,而且不会因为素材是合成的就被豁免。
SynthID 水印会出现在每一帧上吗,能去掉吗?
每一段生成的视频都带着 SynthID,在生成时就嵌入,对观看者不可见,可以通过程序检测。没有哪家提供商暴露了开关,而且这个水印能扛住压缩、裁剪和调色,所以去水印不是一个您可以据以规划的工作流。如果某份交付规格禁止带水印的素材,在开渲之前就把它定下来。
在低分辨率上迭代脸更便宜吗?
更便宜,而且差得很多。十遍 360p 的搜索加一遍 1080p 的收尾在 E2X 上是 1.73 美元,对着十遍 1080p 的 5.40 美元——多生成一次,省掉百分之六十八。草稿的分辨率足够看视线和走位,但不够看皮肤质感或 lip sync,所以在草稿循环收口之后要计划两条满分辨率的片子。
价格和产品条款会变化。在做采购决定之前,请核对各家服务商当前的定价。
四项能力的 schema 和实时价格都在模型页面上。隔壁还有:写进文档的 prompt 语法、四十秒的序列到底要花多少钱,以及同样的权重在哪里卖得更贵。