Continuidad entre planos en Gemini Omni 1.1 Flash: qué endpoint arregla cada deriva
Google publicó dos frases sobre este modelo en el mismo lanzamiento, y apuntan en direcciones opuestas.
La primera está en el anuncio: cuando Omni continúa un clip ahora lee «hasta 10 segundos de contexto previo, un salto respecto a modelos anteriores que solo referenciaban el último segundo». Diez veces la memoria. La segunda está en la model card de DeepMind, bajo limitaciones: «mantener una consistencia completa a lo largo de las ediciones, generar escenas con movimiento complejo o renderizar texto perfectamente exacto sigue siendo un reto».
Las dos son ciertas, y juntas describen el trabajo. La continuidad aquí no es un interruptor que se activa sino un conjunto de decisiones tomadas en la entrada: qué endpoint llama, qué fija con una imagen, qué frases repite palabra por palabra. El coste de una secuencia en cuatro partes es un argumento aparte que no vamos a repetir.
Cuatro endpoints, cuatro cosas distintas quietas
En E2X, gemini-omni-1.1-flash sale como cuatro capacidades a un solo precio: $0.18 el segundo en 4K, llame a la que llame. Eso cambia cómo hay que pensarlas: elegir entre ellas nunca es una decisión de presupuesto, solo de oficio.
Lo que fija cada una:
| Capacidad | Lo que mantiene quieto | Lo que no va a mantener |
|---|---|---|
| text-to-video | Nada salvo sus palabras | Todo lo que no haya escrito |
| image-to-video | El fotograma de apertura, exactamente | Todo lo posterior a más o menos el primer segundo |
| start-end-frame-to-video | Los dos extremos del plano | El camino entre ellos |
| reference-to-video | La identidad y el aspecto del sujeto | Encuadre, puesta en escena, posición de cámara |
Léala como un diagnóstico y no como una lista de funciones: nombre la deriva que está viendo y después elija el endpoint que la ataca.
El plano empieza mal. Su segundo ángulo abre en otra habitación, o el personaje entra ya a mitad de gesto. Déle un fotograma: image-to-video toma una imagen fija y empieza ahí, así que el plano dos puede abrir sobre una captura del último fotograma del plano uno, o sobre un render de fija que aprobó antes. Es el arreglo de continuidad más barato que ofrece el modelo.
El plano termina mal. El movimiento es correcto y el aterrizaje no: la mano busca la puerta y la puerta está en otro sitio. Eso es start-end-frame-to-video. Usted aporta start_frame_url y end_frame_url, el modelo rellena el intervalo, y el fotograma con el que tiene que casar su siguiente corte es uno que ha elegido en lugar de uno que le han dado.
La persona cambia. No el encuadre, no la puesta en escena: la cara, el pelo, la chaqueta. Eso es reference-to-video, la única de las cuatro cuyo propósito es la identidad. Nuestro array image_urls acepta un mínimo de una y un máximo de siete; Runware documenta el mismo techo —«hasta 7 imágenes»— mientras que la referencia de Google no declara ninguna cifra, aunque su ejemplo resuelto usa seis etiquetas. Trate el siete como consenso de terceros, no como una garantía publicada.
Las referencias de vídeo están limitadas más duramente y Google sí publica esas cifras: «las referencias de vídeo admiten un máximo de 3 clips, de hasta 3 segundos cada uno», junto a «no está soportado referenciar ni razonar a través de varios vídeos»: el tres es un techo al que uno se aproxima, no un objetivo que haya que llenar. Sobre qué debe llevar una imagen de referencia, la documentación de Runware es más específica que la de Google y recomienda un plano medio limpio de retrato —encuadre de cintura para arriba, fondo neutro, detalles identificativos visibles— porque «los planos de cuerpo entero, los fondos recargados o los ángulos extremos diluyen la lectura que el modelo hace del personaje».
Lo que fija el seed, y lo que no
En este endpoint no hay muestreador. La documentación de Google es tajante: «las instrucciones de sistema, temperature, top_p, las secuencias de parada y los prompts negativos no están soportados». Sin superficie de muestreo hay un único control de reproducibilidad, y es seed, un entero opcional que aceptan los esquemas de nuestras cuatro capacidades.
Conviene saber de dónde sale ese campo, porque no está en la referencia de Google en absoluto. La documentación de la 1.1 de Runware lleva un seed y describe que devuelve «el seed generado aleatoriamente» cuando no se aporta ninguno; nosotros exponemos el campo en todas las capacidades; Google, en la página que uno consultaría primero, no dice nada. Úselo, pero no lo trate como un contrato.
La parte que pilla a la gente: el seed fija la muestra, no el sujeto. El mismo seed con un prompt idéntico byte a byte es una repetición. El mismo seed con una palabra editada es un sorteo nuevo: se vuelve a muestrear, no se ajusta. Eso es lo contrario de una perilla de temperatura, y significa que el hábito de los modelos de imagen de mantener el seed mientras se afina el prompt no se transfiere.
Lo que deja el seed útil para exactamente dos cosas en un trabajo de varios planos, e inútil para una tercera:
- Volver a renderizar una toma buena en un nivel superior. Haga borradores, encuentre la toma, y después ejecute el mismo prompt y el mismo seed a su resolución de entrega. Nada cambió, así que nada se vuelve a muestrear.
- Aislar una variable. Cambie la frase de iluminación, mantenga el seed, y lo que se mueva es atribuible a esa frase. No es un experimento controlado, pero es más rápido que volver a muestrear a ciegas.
- Llevar una cara entre dos planos distintos. No lo va a hacer. Dos prompts son dos prompts; el seed no se acuerda de su personaje. La identidad entre planos viene de las imágenes de referencia, no de un entero.
Anote el seed junto al prompt en el momento en que una toma funciona. Después no hay ningún historial del que recuperarlo.
Bloques de bloqueo: el mismo párrafo, repetido literalmente
Como una llamada de text-to-video no tiene memoria de su llamada anterior, la instrucción de continuidad más común que circula por ahí no va dirigida a nadie: «Keep everything consistent with the previous shot» señala a un plano que el modelo nunca ha visto.
El arreglo no es lucido. Escriba un bloque de datos de aspecto y de decorado y péguelo en todos los prompts de la secuencia, sin cambios: ni parafraseado, ni apretado, ni reordenado. Una descripción nueva es un sorteo nuevo.
Aquí hay dos versiones del mismo segundo plano de una secuencia de dos. Primero la que deriva:
Continuing the same scene, a tighter shot of the same man at his
workbench in the garage. Cinematic lighting, moody atmosphere,
highly detailed, professional colour grading. He lifts the machined
part into the light and turns it slowly while his colleague watches
from the right. Keep the characters and the location consistent
with the previous shot. Single continuous shot, no scene cuts.
Sound design: workshop room tone and quiet handling noise.
Cuente lo que ese prompt deja sin fijar y tendrá la lista de cosas libres de cambiar: el verde exacto de la chaqueta, si el puño está deshilachado, si hay o no un pañuelo, qué cuelga del panel de herramientas, de dónde viene la luz. Nada de eso está escrito, así que nada de eso se le debe: un plano competente de otra tarde es una respuesta correcta a lo que se pidió.
La reescritura mantiene la acción y gasta sus palabras en hechos en lugar de en adjetivos:
In a single continuous shot, no scene cuts. Medium two-shot in a
cluttered garage workshop, 40mm lens at f/4, both subjects sharp.

[Lock - repeat verbatim in every shot of this sequence]
Man: mid-forties, close-cropped grey hair parted on his left, faded
green canvas work jacket, frayed left cuff, oil stain on the right
pocket, steel watch on his left wrist. Woman: thirties, dark hair
tied back, grey knit sweater, red bandana at her neck, clipboard in
her right hand. Set: steel workbench, pegboard behind with three
wrenches hanging left of centre, one overhead fluorescent tube,
cold white key from above, no window light.

Action: he lifts a machined aluminium part into the light and turns
it once; she does not move. Sound design: fluorescent hum, the part
clicking down onto steel. No dialogue.
La etiqueta entre corchetes es para usted, no para el modelo: marca la región que copia. Lo que se gana un sitio en el bloque es cualquier cosa asimétrica o dañada: por qué lado se peina, qué puño está deshilachado, qué muñeca lleva el reloj, qué mano sostiene el portapapeles. La simetría es donde se esconde la deriva, porque un detalle simétrico reflejado parece correcto por sí solo y está mal dentro de un corte. Los nombres de color pertenecen ahí, y también la luz: dirección, dureza y la ausencia explícita de una fuente que no quiere.
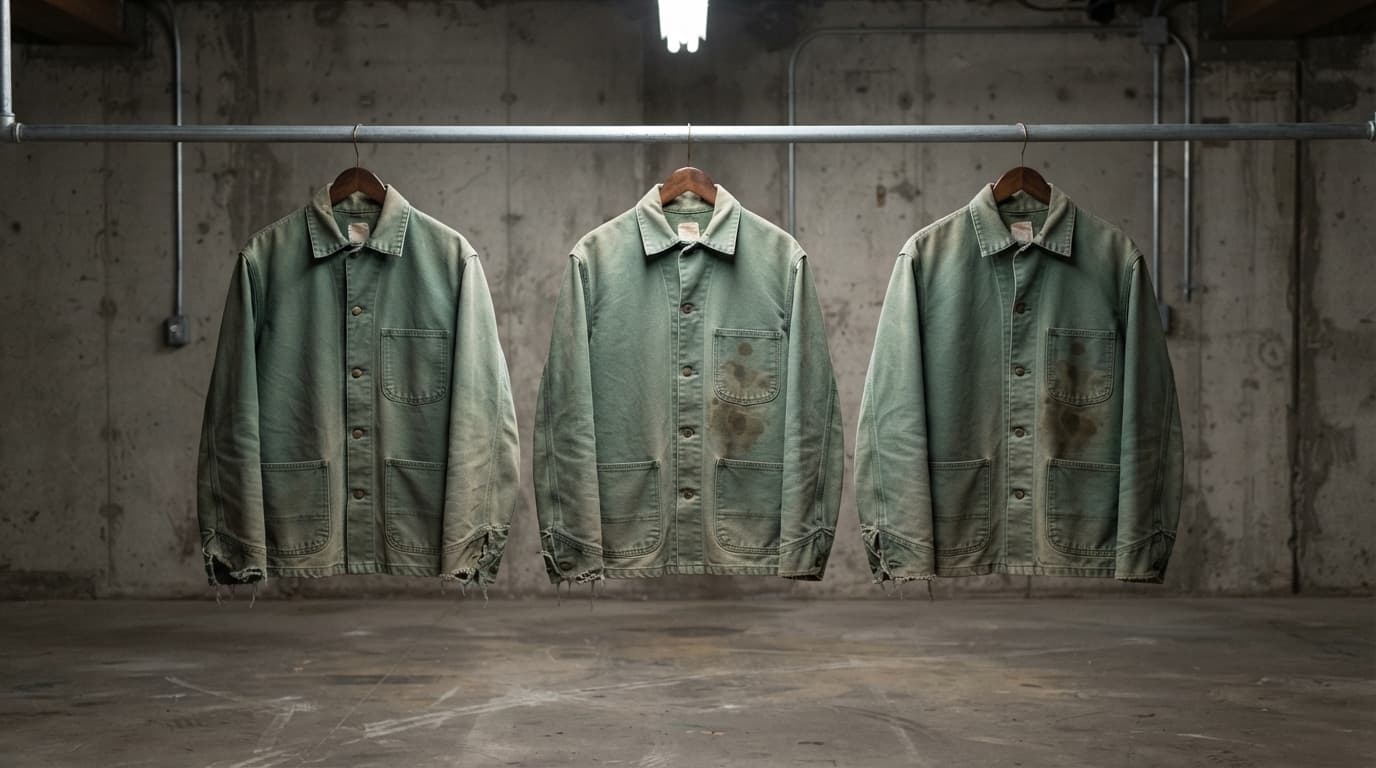
Una cosa que hay que dejar fuera del bloque: etiquetas impresas, rótulos, texto legible en atrezo. La model card lista el texto exacto entre los problemas abiertos, así que un objeto que deba leerse igual en dos planos es el ancla menos fiable disponible. Ánclese en la forma y en la mancha.
La extensión corre hacia delante, así que planifique hacia atrás
La formulación de Google no deja margen: «la extensión de vídeo se limita a añadir al final de un vídeo; no está soportado anteponer contenido ni extender la mitad de un clip». Las continuaciones van en pasos de diez segundos «hasta una longitud total de 40 s», y un clip subido debe tener «10 segundos o menos de duración» antes de poder extenderlo.
La consecuencia para la planificación es mayor de lo que parece: una cadena no tiene deshacer. El plano uno fija la paleta, la luz y la gramática de cámara de todo lo que se le añada detrás, así que un error ahí es una secuencia que se reconstruye y no un plano que se vuelve a renderizar. Y el plano más arriesgado —el gesto difícil, el reflejo complicado— suele quedar en el medio, exactamente donde no se puede llegar.
Así que hay una decisión estructural que tomar antes de la primera llamada:
- Una sola cadena de extensiones le compra una continuación real fotograma a fotograma y diez segundos de contexto que el modelo lee de verdad. Le cuesta la capacidad de arreglar cualquier cosa que no sea la cola.
- Generaciones independientes cosidas en un editor, cada una anclada por una imagen de referencia o un fotograma de inicio, le cuestan la unión invisible y le compran la capacidad de volver a tirar el plano tres treinta veces sin tocar los planos uno y dos.
Para una acción que no puede cortar de forma visible, extienda. Para una secuencia que ya lleva cortes, genere por separado: esa es además la opción que sobrevive a una nota de cliente, y casi todas las secuencias reciben una.
Ese clip es una única generación que lleva dentro un reencuadre, y no dos planos unidos:
A two-shot in a cluttered garage workshop, 40mm lens at f/4, both
subjects sharp. A man in a faded green work jacket with a torn left
cuff stands at the bench; a woman in a grey knit sweater with a red
bandana tied at her neck stands to his right holding a clipboard.
The camera holds the wide two-shot for four seconds while he lifts
a machined aluminium part into the light and turns it. Then the
camera pushes in and reframes to a tighter two-shot from the same
axis - same jacket, same torn cuff, same bandana, same bench clutter
behind them, same overhead fluorescent light. No cut, no wardrobe
change, no relight. Sound: fluorescent hum and the part clicking
down onto steel.
Los puntos de corte también son cortes de audio
El audio se genera con la imagen y no hay interruptor para rechazarlo. Eso normalmente se archiva bajo diseño de sonido; para la continuidad es una restricción, porque su corte aterriza en mitad de una banda sonora que usted no compuso y que no puede recortar en origen.
De ahí salen dos reglas. Describa el ambiente con palabras idénticas a los dos lados de un corte, igual que repite el bloque de vestuario: «fluorescent hum» en los dos prompts, y no «fluorescent hum» y luego «the buzz of the overhead light». Un ruido de sala que cambia en la unión es más difícil de ignorar que una chaqueta que cambia de tono, porque el oído no tiene ningún límite de plano tras el que esconderse.
Después elija dónde cortar pensando en el sonido. Cortar a mitad de gesto exige que el modelo reproduzca el mismo vector de movimiento al otro lado: exactamente el caso de «movimiento complejo» que señala la model card. Cortar sobre una pose asentada, con la pieza dejada y la mano quieta, le da a la siguiente generación una condición de partida inequívoca y al audio una costura natural. Cuesta un tiempo de ritmo y compra una unión que aguanta.
Hay una decisión que va antes que todo esto: la relación de aspecto. El modelo ofrece 16:9 y 9:16, y nada más. Como la extensión solo añade al final y las imágenes de referencia heredan el encuadre con el que se tomaron, cambiar de orientación a mitad de secuencia no es un cambio de ajuste: invalida todos los activos anteriores. Elija la orientación pensando en la entrega, en el plano uno.
Lo que cuesta una secuencia de cuatro planos
Las herramientas de continuidad de este modelo son gratis. Una llamada de reference-to-video con siete imágenes cuesta lo que cuesta una llamada pelada de text-to-video; los fotogramas que pasa a start-end-frame-to-video no añaden nada. Se paga por segundos y por resolución.
Cuatro planos de ocho segundos son treinta y dos segundos. En el nivel más alto:
| Dónde | 32 s en 4K |
|---|---|
| E2X | $5.76 |
| Google, desde sus tarifas de tokens publicadas | $9.73 |
| fal | $9.60 |
| Runware | $10.24 |
| WaveSpeed | $12.48 |
Esa diferencia es una historia de multiplicadores, no de descuentos. Las dos escaleras suben igual de 360p a 1080p; en el peldaño de arriba Google triplica su tarifa de 720p y nosotros duplicamos la nuestra, así que la horquilla es más ancha exactamente donde se entregan las secuencias terminadas. El desarrollo nivel por nivel, incluido por qué el nivel de arriba es un escalado, está en nuestro post sobre el 4K.
Ahora aplíquelo a cómo va de verdad el trabajo de continuidad. Nadie clava cuatro planos en cuatro generaciones. Si el plano tres se lleva seis intentos y el cuatro tres, eso son quince trabajos: $21.60 aquí frente a $36.49 directos en 4K. Que es el argumento más fuerte a favor de las generaciones independientes frente a una sola cadena: volver a tirar cuesta un plano, no la cola de la secuencia. Haga las pruebas de continuidad a 360p, un sexto de la tarifa de 4K por segundo, y ascienda la toma buena.
Dónde sigue patinando
La versión honesta, ya que la model card nos da el lenguaje para ello.
La división se deduce de lo que pueden codificar los dos mecanismos. Una frase y una fotografía de referencia llevan propiedades gruesas y nombrables: silueta y color de la prenda, longitud y color del pelo, geometría de la habitación, paleta, dirección y dureza de la luz, la colocación aproximada de los objetos grandes. Eso lo puede declarar un bloque de bloqueo y lo puede mostrar una imagen de referencia.
Lo que ninguno de los dos lleva es la precisión por debajo del nivel de un nombre: la geometría facial exacta entre encuadres distantes, la joyería, los objetos pequeños de fondo, el detalle fino del tejido y todo lo impreso, que la model card lista aparte como poco fiable. Google nombra el patrón solo en términos generales, y los evaluadores de terceros lo describen apareciendo con más fuerza en los cambios de escena y los movimientos de cámara que dentro de un plano sostenido. Esa es nuestra lectura de la documentación y de lo publicado, no una afirmación medida; no hemos montado un banco de pruebas que le pusiera un número.
En la práctica: una secuencia con un primer plano protagonista necesita generar ese primer plano a partir de un conjunto de referencias en lugar de heredarlo de un plano general, porque la identidad sobrevive mejor a un reencuadre que a un cambio de escala. La técnica de cara en plano único es su propio post, y el vocabulario de cámara que mantiene dos planos en un mismo eje está en el de cámara.
Nadie debería vender una narrativa de treinta planos con este modelo y prometer una cara que no se mueve nunca. Lo que sí se puede vender es una secuencia donde la deriva sea lo bastante pequeña como para caber dentro de un corte: alcanzable con referencias, bloques de bloqueo y puntos de corte elegidos sobre la quietud.
Empiece por la tabla del principio: nombre la deriva, elija la herramienta, escriba el bloque una vez, repítalo exactamente. La referencia de API de Google lleva las formas de etiqueta para vincular referencias por nombre, y las páginas de capacidad llevan las tarifas y los esquemas vigentes.
Los precios y las condiciones de producto cambian. Compruebe el precio vigente de cada proveedor antes de tomar una decisión de compra.
Preguntas frecuentes
¿Cómo se mantiene consistente un personaje entre planos en Gemini Omni 1.1 Flash?
Con dos mecanismos a la vez. Pase el personaje como imágenes de referencia por reference-to-video —nuestro esquema acepta de una a siete, y Runware documenta el mismo techo— y repita un bloque idéntico de datos de aspecto en todos los prompts, copiado y no parafraseado. Las referencias llevan la identidad; el texto repetido lleva el vestuario, el atrezo y la luz. La model card de Google es explícita en que la consistencia completa entre ediciones sigue siendo un problema abierto, así que ninguno de los dos basta por su cuenta.
¿El seed mantiene el mismo personaje entre dos prompts de Gemini Omni?
No. El seed fija una muestra, no un sujeto. Dos prompts distintos son dos sorteos distintos independientemente del seed, y una sola palabra editada en un prompt por lo demás idéntico es una muestra nueva y no una variación. El seed se gana su sitio para volver a renderizar una toma aprobada a mayor resolución y para aislar una frase cambiada. La identidad entre planos viene de las imágenes de referencia.
¿Qué capacidad de Omni debo usar para un plano que tiene que terminar en un fotograma concreto?
start-end-frame-to-video. Usted aporta una imagen de inicio y una de fin, el modelo genera el intervalo, y el fotograma con el que tiene que casar su siguiente corte es uno que ha elegido. En E2X cuesta lo mismo por segundo que un text-to-video pelado, así que no hay ninguna razón de precio para evitarlo.
¿Puede Gemini Omni 1.1 Flash extender un vídeo hacia atrás?
No. La documentación de Google dice que la extensión solo añade al final de un clip, sin forma de anteponer contenido ni de extender el medio. Las continuaciones van en pasos de diez segundos hasta un total de cuarenta, y el clip que extiende debe durar diez segundos o menos. Así que la primera generación fija el aspecto de todo lo que venga después, y un error temprano no se puede reparar sin reconstruir la cadena.
¿Cuántas imágenes de referencia acepta Gemini Omni 1.1 Flash?
Nuestro esquema de reference-to-video acepta de una a siete, y la documentación de Runware declara el mismo máximo. La propia referencia de Google no publica ninguna cifra, aunque su ejemplo resuelto vincula seis imágenes etiquetadas en un mismo prompt, así que trate el siete como consenso de terceros y no como garantía documentada. Las referencias de vídeo las limita Google aparte a tres clips de hasta tres segundos cada uno.
¿Cuál es el mejor sitio para cortar entre dos planos generados?
Sobre la quietud, no a mitad de movimiento. Una pose asentada le da a la siguiente generación una condición de partida inequívoca; un corte dentro de un gesto le pide al modelo que reproduzca un vector de movimiento, el caso de movimiento complejo que la model card de Google lista como debilidad conocida. Y como cada clip llega con una banda sonora que no se puede rechazar, describa el ambiente con palabras idénticas a los dos lados de la unión o el ruido de sala cambiará en el corte.
¿Puedo mezclar planos 16:9 y 9:16 en una misma secuencia de Omni?
No de forma útil. Esas dos relaciones son las únicas opciones, la extensión añade en la orientación con la que empezó, y las imágenes de referencia llevan el encuadre con el que se tomaron, así que cambiar de orientación a mitad invalida todos los activos anteriores. Decida apaisado o vertical contra el formato de entrega antes del plano uno.
¿Sale más barato construir una secuencia extendiendo o generando los planos por separado?
La tarifa por segundo es idéntica de las dos formas —la extensión no lleva descuento—, así que la diferencia está en lo que cuesta volver a tirar. En una cadena, arreglar un plano temprano descarta todo lo que se le añadió detrás. Con generaciones independientes ancladas por imágenes de referencia o fotogramas de inicio, un plano malo cuesta un plano. En E2X treinta y dos segundos de 4K son $5.76 frente a $9.73 directos desde Google, y esa diferencia se ensancha con cada toma que descarta.