Continuité des plans sur Gemini Omni 1.1 Flash : quel endpoint corrige quelle dérive
Google a publié deux phrases sur ce modèle lors du même lancement, et elles pointent dans des directions opposées.
La première est dans l'annonce : quand Omni prolonge un clip, il lit désormais « up to 10 seconds of prior context — a leap from previous models that only referenced the final second. » Dix fois plus de mémoire. La seconde est dans la fiche modèle de DeepMind, dans les limitations : « maintaining complete consistency throughout edits, generating scenes with complex motion, or rendering perfectly accurate text remains a challenge. »
Les deux sont vraies, et ensemble elles décrivent le travail. La continuité n'est pas ici un interrupteur qu'on active, mais un ensemble de choix faits à l'entrée — quel endpoint vous appelez, ce que vous fixez avec une image, quelles phrases vous répétez mot pour mot. Le coût d'une séquence en quatre parties est un argument distinct que nous ne rejouerons pas.
Quatre endpoints, quatre choses différentes maintenues
Sur E2X, gemini-omni-1.1-flash est livré en quatre capacités à un seul prix — $0.18 la seconde en 4K, quelle que soit celle que vous appelez. Cela change la façon d'y penser : choisir entre elles n'est jamais une décision budgétaire, seulement une décision de métier.
Ce que chacune fixe :
| Capacité | Ce qu'elle maintient | Ce qu'elle ne maintiendra pas |
|---|---|---|
| text-to-video | Rien d'autre que vos mots | Tout ce que vous n'avez pas écrit |
| image-to-video | L'image d'ouverture, exactement | Tout ce qui vient après la première seconde environ |
| start-end-frame-to-video | Les deux extrémités du plan | Le chemin entre les deux |
| reference-to-video | L'identité et l'allure du sujet | Le cadrage, la mise en place, la position de caméra |
Lisez cela comme un diagnostic plutôt que comme une liste de fonctionnalités : nommez la dérive que vous constatez, puis choisissez l'endpoint qui l'adresse.
Le plan commence mal. Votre second axe ouvre sur une autre pièce, ou le personnage entre déjà au milieu d'un geste. Donnez-lui une image : image-to-video prend un fixe et démarre là, donc le plan deux peut ouvrir sur une capture de la dernière image du plan un, ou sur un rendu fixe que vous aviez validé. C'est le correctif de continuité le moins cher que propose le modèle.
Le plan finit mal. Le mouvement est bon et l'atterrissage non — la main va vers la porte et la porte est ailleurs. C'est le rôle de start-end-frame-to-video. Vous fournissez start_frame_url et end_frame_url, le modèle remplit l'intervalle, et l'image que votre coupe suivante doit raccorder est une image que vous avez choisie plutôt qu'une image qu'on vous a donnée.
La personne change. Pas le cadrage, pas la mise en place — le visage, les cheveux, la veste. C'est reference-to-video, la seule des quatre dont l'objet est l'identité. Notre tableau image_urls accepte au minimum une et au maximum sept images ; Runware documente le même plafond — « up to 7 images » — tandis que la référence de Google n'énonce aucun nombre, même si son exemple travaillé utilise six tags. Traitez sept comme un consensus de tiers, pas comme une garantie publiée.
Les références vidéo sont plafonnées plus durement et Google publie ces chiffres-là : « Video references support a maximum of 3 clips, up to 3 seconds each », à côté de « Referencing or reasoning across multiple videos is not supported » — trois est un plafond dont on s'approche, pas un objectif à remplir. Sur ce qui doit figurer dans une image de référence, la documentation de Runware est plus précise que celle de Google : elle recommande un portrait mi-plan propre — cadrage jusqu'à la taille, fond neutre, détails identifiants visibles — parce que « Full-body shots, busy backgrounds, or extreme angles dilute the model's read on the character. »
Ce que le seed fixe, et ce qu'il ne fixe pas
Il n'y a pas d'échantillonneur sur cet endpoint. La documentation de Google est catégorique : « System instructions, temperature, top_p, stop sequences, and negative prompts are not supported. » Pas de surface d'échantillonnage signifie un seul contrôle de reproductibilité, et c'est seed — un entier optionnel que nos quatre schémas de capacité acceptent.
Il vaut la peine de savoir d'où vient ce champ, car il n'est pas du tout dans la référence de Google. La documentation 1.1 de Runware porte un seed et décrit le renvoi de « the randomly generated seed » quand vous n'en fournissez aucun ; nous exposons le champ sur chaque capacité ; Google, sur la page que vous consulteriez en premier, ne dit rien. Utilisez-le, mais n'y voyez pas un contrat.
Le point qui piège : le seed fixe l'échantillon, pas le sujet. Même seed et prompt identique au byte près, c'est une répétition. Même seed et un mot modifié, c'est un nouveau tirage — un échantillonnage neuf, pas un ajustement. C'est l'inverse d'un réglage de température, et cela signifie que l'habitude venue des modèles d'image, tenir le seed en réglant le prompt, ne se transfère pas.
Ce qui laisse le seed utile pour exactement deux choses dans un travail multi-plans, et inutile pour une troisième :
- Refaire un keeper à un palier supérieur. Faites des brouillons, trouvez la prise, puis lancez le même prompt et le même seed à votre résolution de livraison. Rien n'a changé, donc rien n'est rééchantillonné.
- Isoler une variable. Changez la phrase de lumière, tenez le seed, et ce qui bouge est attribuable à cette phrase. Pas une expérience contrôlée, mais plus rapide qu'un rééchantillonnage à l'aveugle.
- Transporter un visage entre deux plans différents. Il ne le fera pas. Deux prompts sont deux prompts ; le seed ne se souvient pas de votre personnage. L'identité d'un plan à l'autre vient des images de référence, pas d'un entier.
Notez le seed à côté du prompt à l'instant où une prise fonctionne. Il n'existe aucun historique pour le récupérer plus tard.
Blocs de verrouillage : le même paragraphe, répété mot pour mot
Parce qu'un appel text-to-video n'a aucune mémoire de votre appel précédent, l'instruction de continuité la plus répandue s'adresse à personne : « Keep everything consistent with the previous shot » désigne un plan que le modèle n'a jamais vu.
Le correctif n'a rien de glamour. Écrivez un bloc de faits d'apparence et de décor et collez-le dans chaque prompt de la séquence, inchangé — pas paraphrasé, pas resserré, pas réordonné. Une nouvelle description est un nouveau tirage.
Voici deux versions du même second plan dans une séquence de deux plans. D'abord celle qui dérive :
Continuing the same scene, a tighter shot of the same man at his
workbench in the garage. Cinematic lighting, moody atmosphere,
highly detailed, professional colour grading. He lifts the machined
part into the light and turns it slowly while his colleague watches
from the right. Keep the characters and the location consistent
with the previous shot. Single continuous shot, no scene cuts.
Sound design: workshop room tone and quiet handling noise.
Comptez ce que ce prompt laisse non fixé et vous obtenez la liste de ce qui est libre de changer : le vert exact de la veste, le fait que le poignet soit effiloché ou non, la présence même d'un bandana, ce qui pend au panneau perforé, d'où vient la lumière. Rien de tout cela n'est écrit, donc rien ne vous est dû — un plan compétent d'un autre après-midi est une réponse correcte à ce qui a été demandé.
La réécriture garde l'action et dépense ses mots en faits plutôt qu'en adjectifs :
In a single continuous shot, no scene cuts. Medium two-shot in a
cluttered garage workshop, 40mm lens at f/4, both subjects sharp.

[Lock - repeat verbatim in every shot of this sequence]
Man: mid-forties, close-cropped grey hair parted on his left, faded
green canvas work jacket, frayed left cuff, oil stain on the right
pocket, steel watch on his left wrist. Woman: thirties, dark hair
tied back, grey knit sweater, red bandana at her neck, clipboard in
her right hand. Set: steel workbench, pegboard behind with three
wrenches hanging left of centre, one overhead fluorescent tube,
cold white key from above, no window light.

Action: he lifts a machined aluminium part into the light and turns
it once; she does not move. Sound design: fluorescent hum, the part
clicking down onto steel. No dialogue.
L'étiquette entre crochets est pour vous, pas pour le modèle — elle marque la région que vous copiez. Ce qui mérite sa place dans le bloc, c'est tout ce qui est asymétrique ou abîmé : de quel côté la raie des cheveux, quel poignet est effiloché, quel poignet porte la montre, quelle main tient le porte-bloc. La symétrie est l'endroit où la dérive se cache, parce qu'un détail symétrique inversé paraît correct seul et faux dans une coupe. Les noms de couleurs y appartiennent, et la lumière aussi : direction, dureté, et l'absence explicite d'une source dont vous ne voulez pas.
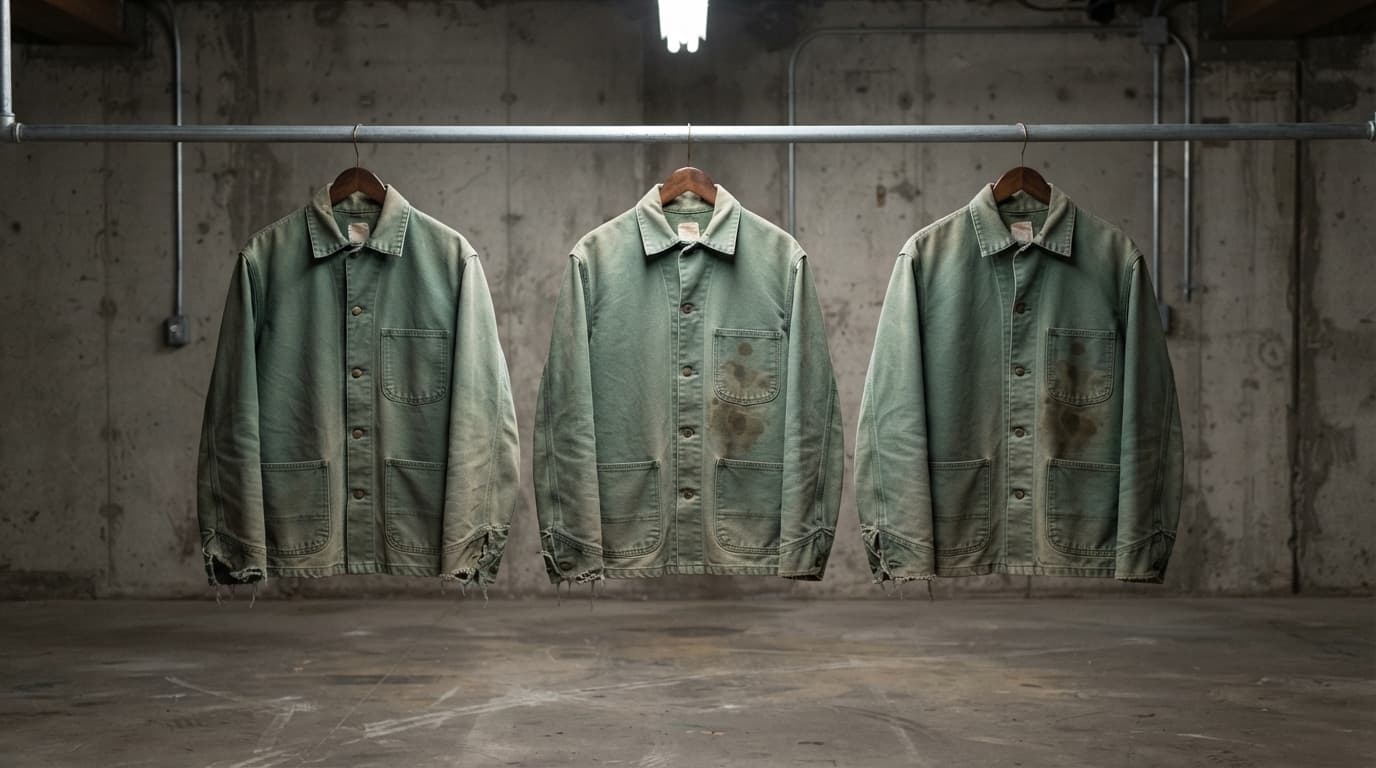
Une chose à tenir hors du bloc : les étiquettes imprimées, la signalétique, le texte lisible sur les accessoires. La fiche modèle range le texte exact parmi les problèmes ouverts, donc un accessoire qui doit se lire pareil dans deux plans est l'ancrage le moins fiable disponible. Ancrez plutôt sur la forme et la tache.
L'extension va vers l'avant, alors planifiez à rebours
La formulation de Google ne laisse pas de marge : « Video extension is limited to appending to the end of a video; prepending or extending the middle of a clip is not supported. » Les continuations avancent par pas de dix secondes « up to a total length of 40s », et un clip téléversé doit faire « 10 seconds or less in length » avant que vous puissiez l'étendre.
La conséquence pour la planification est plus lourde qu'elle n'en a l'air : une chaîne n'a pas d'annulation. Le plan un fixe la palette, la lumière et la grammaire de caméra de tout ce qui lui est ajouté, donc une erreur là-bas est une séquence à reconstruire et non un plan à refaire. Et le plan le plus risqué — le geste difficile, le reflet délicat — se situe généralement au milieu, exactement là où vous ne pouvez plus atteindre.
Il y a donc un choix structurel à faire avant le premier appel :
- Une chaîne d'extension vous offre une véritable continuation d'image à image et dix secondes de contexte que le modèle lit réellement. Elle vous coûte la possibilité de corriger autre chose que la fin.
- Des générations indépendantes assemblées au montage, chacune ancrée par une image de référence ou une image de départ, vous coûtent le raccord invisible et vous offrent la possibilité de relancer trente fois le plan trois sans toucher aux plans un et deux.
Pour une action qui ne doit pas visiblement couper, étendez. Pour une séquence qui comporte de toute façon des coupes, générez séparément — c'est aussi l'option qui survit à une remarque de client, et la plupart des séquences en reçoivent une.
Ce clip est une seule génération qui porte un recadrage, et non deux plans raccordés :
A two-shot in a cluttered garage workshop, 40mm lens at f/4, both
subjects sharp. A man in a faded green work jacket with a torn left
cuff stands at the bench; a woman in a grey knit sweater with a red
bandana tied at her neck stands to his right holding a clipboard.
The camera holds the wide two-shot for four seconds while he lifts
a machined aluminium part into the light and turns it. Then the
camera pushes in and reframes to a tighter two-shot from the same
axis - same jacket, same torn cuff, same bandana, same bench clutter
behind them, same overhead fluorescent light. No cut, no wardrobe
change, no relight. Sound: fluorescent hum and the part clicking
down onto steel.
Les points de coupe sont aussi des coupes son
L'audio est généré avec l'image et aucun interrupteur ne permet de le refuser. Cela se range normalement au rayon sound design ; pour la continuité, c'est une contrainte, parce que votre coupe tombe au milieu d'une bande son que vous n'avez pas composée et que vous ne pouvez pas rogner à la source.
Deux règles en découlent. Décrivez l'ambiance avec des mots identiques des deux côtés d'une coupe, comme vous répétez le bloc de costume — « fluorescent hum » dans les deux prompts, pas « fluorescent hum » puis « the buzz of the overhead light ». Un fond sonore qui se décale au raccord est plus difficile à ignorer qu'une veste qui change de nuance, parce que l'oreille n'a pas de frontière de plan derrière laquelle se cacher.
Choisissez ensuite l'endroit de la coupe en pensant au son. Couper en plein geste demande au modèle de reproduire le même vecteur de mouvement de l'autre côté — exactement le cas « complex motion » que la fiche modèle signale. Couper sur une pose posée, la pièce reposée et la main immobile, donne à la génération suivante une condition de départ sans ambiguïté et au son une couture naturelle. Cela coûte un temps de rythme et achète un raccord qui tient.
Une décision précède tout cela : le format d'image. Le modèle propose 16:9 et 9:16, rien d'autre. Parce que l'extension ne fait qu'ajouter et que les images de référence héritent du cadrage dans lequel elles ont été prises, changer d'orientation en cours de séquence n'est pas un changement de réglage — cela invalide tous les assets en amont. Choisissez l'orientation en fonction de la livraison, dès le plan un.
Ce que coûte une séquence de quatre plans
L'outillage de continuité de ce modèle est gratuit. Un appel reference-to-video avec sept images coûte ce que coûte un appel text-to-video nu ; les images que vous passez à start-end-frame-to-video n'ajoutent rien. Vous payez des secondes et une résolution.
Quatre plans de huit secondes font trente-deux secondes. Au palier supérieur :
| Où | 32 s en 4K |
|---|---|
| E2X | $5.76 |
| Google, d'après les tarifs token publiés | $9.73 |
| fal | $9.60 |
| Runware | $10.24 |
| WaveSpeed | $12.48 |
Cet écart est une histoire de multiplicateurs, pas une histoire de remise. Les deux échelles montent de la même façon de 360p à 1080p ; au dernier barreau Google triple son tarif 720p et nous doublons le nôtre, donc l'écart est le plus large exactement là où les séquences finies sont livrées. Le détail palier par palier, y compris pourquoi le palier supérieur est un upscale, est dans notre billet 4K.
Appliquez maintenant cela à la façon dont se déroule le travail de continuité. Personne ne réussit quatre plans en quatre générations. Si le plan trois demande six tentatives et le plan quatre trois, cela fait quinze travaux — $21.60 ici contre $36.49 en direct en 4K. C'est le plus fort argument pour des générations indépendantes plutôt qu'une chaîne : une relance coûte un plan, pas la fin de la séquence. Faites les tests de continuité en 360p, un sixième du tarif 4K à la seconde, et promouvez la prise.
Là où ça glisse encore
La version honnête, puisque la fiche modèle nous en donne le vocabulaire.
La séparation découle de ce que les deux mécanismes peuvent encoder. Une phrase et une photographie de référence portent des propriétés grossières et nommables : silhouette et couleur de vêtement, longueur et couleur de cheveux, géométrie de la pièce, palette, direction et dureté de la lumière, placement approximatif des gros accessoires. Cela, un bloc de verrouillage peut l'énoncer et une image de référence le montrer.
Ce qu'aucun des deux ne porte, c'est la précision en dessous du niveau d'un nom — géométrie exacte du visage entre des cadrages éloignés, bijoux, petits objets d'arrière-plan, détails fins de tissu, et tout ce qui est imprimé, que la fiche modèle liste séparément comme peu fiable. Google ne nomme le phénomène qu'en termes généraux, et les testeurs tiers le décrivent comme frappant le plus fort aux changements de scène et aux mouvements de caméra plutôt qu'à l'intérieur d'un plan tenu. C'est notre lecture de la documentation et des comptes rendus, pas une mesure ; nous n'avons pas monté de banc qui permettrait d'y mettre un chiffre.
En pratique : une séquence comportant un gros plan clé exige que ce gros plan soit généré à partir d'un jeu de références plutôt qu'hérité d'un plan large, parce que l'identité survit mieux à un recadrage qu'à un changement d'échelle. La technique du visage dans un plan unique fait l'objet de son propre billet, et le vocabulaire de caméra qui garde deux plans sur un même axe est dans celui sur la caméra.
Personne ne devrait vendre un récit de trente plans sur ce modèle en promettant un visage qui ne bouge jamais. Ce qui se vend, c'est une séquence où la dérive est assez petite pour tenir à l'intérieur d'une coupe — atteignable avec des références, des blocs de verrouillage et des points de coupe choisis sur l'immobilité.
Partez du tableau du début : nommez la dérive, choisissez l'outil, écrivez le bloc une fois, répétez-le exactement. La référence de l'API de Google porte les formes de tags pour lier les références par leur nom, et les pages de capacité portent les tarifs et schémas en vigueur.
Les prix et les conditions produit changent. Vérifiez les tarifs en vigueur de chaque fournisseur avant toute décision d'achat.
Questions fréquentes
Comment garder un personnage cohérent d'un plan à l'autre avec Gemini Omni 1.1 Flash ?
Deux mécanismes ensemble. Passez le personnage en images de référence via reference-to-video — notre schéma en accepte de une à sept, et Runware documente le même plafond — et répétez dans chaque prompt un bloc identique de faits d'apparence, copié plutôt que paraphrasé. Les références portent l'identité ; le texte répété porte le costume, les accessoires et la lumière. La fiche modèle de Google dit explicitement que la cohérence complète à travers les éditions reste un problème ouvert : ni l'un ni l'autre ne suffit seul.
Le seed conserve-t-il le même personnage entre deux prompts Gemini Omni ?
Non. Le seed fixe un échantillon, pas un sujet. Deux prompts différents sont deux tirages différents quel que soit le seed, et un mot modifié dans un prompt par ailleurs identique donne un échantillon neuf plutôt qu'une variation. Le seed gagne sa place pour refaire une prise validée à une résolution supérieure et pour isoler une phrase modifiée. L'identité d'un plan à l'autre vient des images de référence.
Quelle capacité Omni utiliser pour un plan qui doit finir sur une image précise ?
start-end-frame-to-video. Vous fournissez une image de départ et une image de fin, le modèle génère l'intervalle, et l'image que votre coupe suivante doit raccorder est celle que vous avez choisie. Sur E2X, cela coûte la même chose à la seconde qu'un simple text-to-video : aucune raison tarifaire de l'éviter.
Gemini Omni 1.1 Flash peut-il étendre une vidéo vers l'arrière ?
Non. La documentation de Google indique que l'extension ne fait qu'ajouter à la fin d'un clip, sans possibilité d'ajouter avant ni d'étendre le milieu. Les continuations avancent par pas de dix secondes jusqu'à un total de quarante secondes, et le clip que vous étendez doit faire dix secondes ou moins. La première génération fixe donc l'allure de tout ce qui suit, et une erreur précoce ne se répare pas sans reconstruire la chaîne.
Combien d'images de référence Gemini Omni 1.1 Flash accepte-t-il ?
Notre schéma reference-to-video en accepte de une à sept, et la documentation de Runware énonce le même maximum. La référence de Google ne publie aucun nombre, même si son exemple travaillé lie six images taguées dans un seul prompt — traitez donc sept comme un consensus de tiers et non comme une garantie documentée. Les références vidéo sont plafonnées séparément par Google à trois clips de trois secondes maximum chacun.
Où couper entre deux plans générés ?
Sur l'immobilité plutôt qu'en plein mouvement. Une pose posée donne à la génération suivante une condition de départ sans ambiguïté ; une coupe à l'intérieur d'un geste demande au modèle de reproduire un vecteur de mouvement, le cas de mouvement complexe que la fiche modèle de Google liste comme faiblesse connue. Et puisque chaque clip arrive avec une bande son que vous ne pouvez pas refuser, décrivez l'ambiance avec des mots identiques des deux côtés du raccord, faute de quoi le fond sonore se décale à la coupe.
Puis-je mélanger des plans 16:9 et 9:16 dans une même séquence Omni ?
Pas utilement. Ces deux ratios sont les seules options, l'extension ajoute dans l'orientation où elle a commencé, et les images de référence portent le cadrage dans lequel elles ont été prises — changer d'orientation en cours de route invalide donc tous les assets en amont. Décidez paysage ou portrait en fonction du format de livraison, avant le plan un.
Est-il moins cher de construire une séquence par extension ou par générations séparées ?
Le tarif à la seconde est identique dans les deux cas — l'extension n'offre aucune remise — la différence est donc le coût d'une relance. Dans une chaîne, corriger un plan précoce jette tout ce qui lui a été ajouté. Avec des générations indépendantes ancrées par des images de référence ou des images de départ, un mauvais plan coûte un plan. Sur E2X, trente-deux secondes de 4K coûtent $5.76 contre $9.73 en direct chez Google, et cet écart se creuse à chaque prise jetée.