Continuidade entre planos no Gemini Omni 1.1 Flash: qual endpoint corrige qual desvio
O Google publicou duas frases sobre este modelo no mesmo lançamento, e elas apontam em direções opostas.
A primeira está no anúncio: quando o Omni continua um clipe, ele agora lê "até 10 segundos de contexto anterior — um salto em relação a modelos anteriores, que só referenciavam o último segundo." Dez vezes a memória. A segunda está no model card da DeepMind, sob limitações: "manter consistência completa ao longo de edições, gerar cenas com movimento complexo ou renderizar texto perfeitamente preciso continuam sendo um desafio."
As duas são verdadeiras, e juntas descrevem o trabalho. Continuidade aqui não é uma chave que se liga, e sim um conjunto de escolhas feitas na entrada — qual endpoint você chama, o que você fixa com uma imagem, quais frases você repete palavra por palavra. O custo de uma sequência de quatro partes é um argumento separado que não vamos rodar de novo.
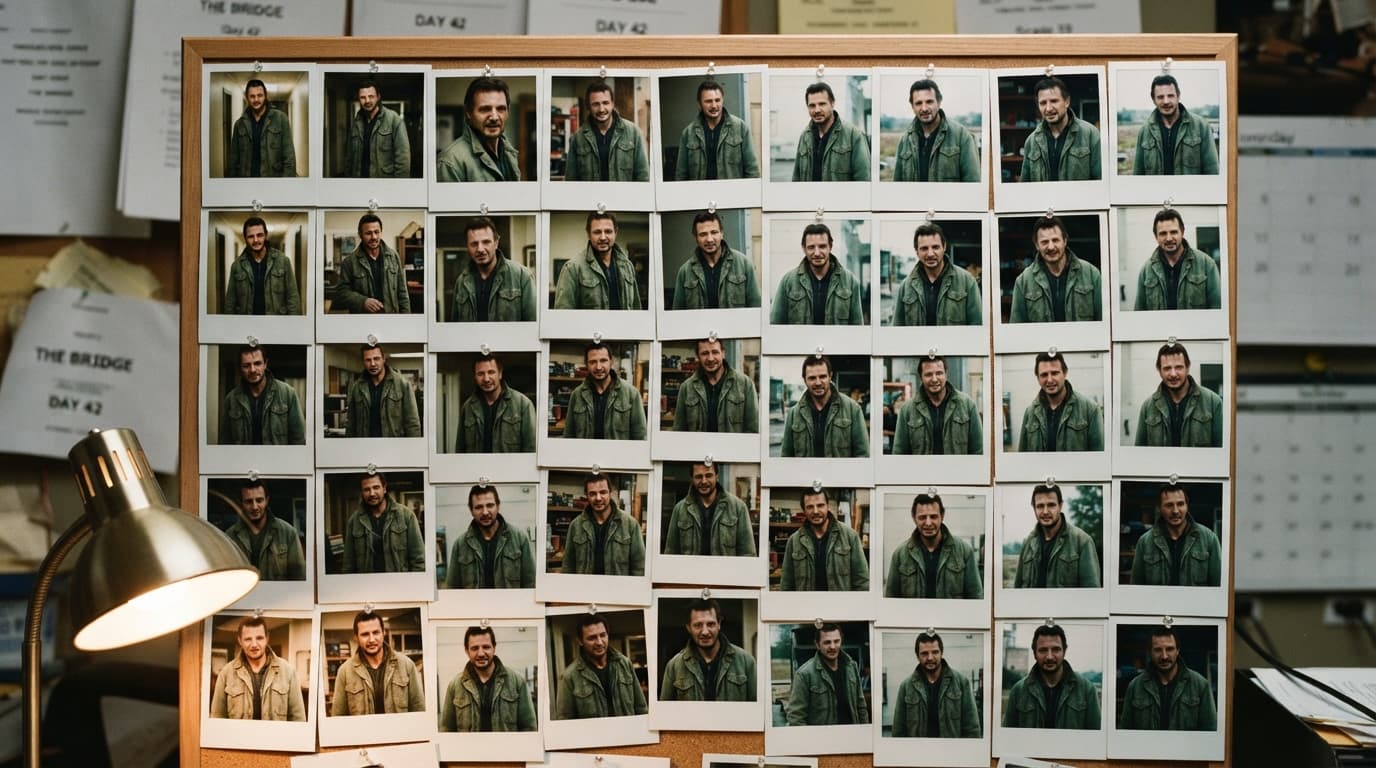
Quatro endpoints, quatro coisas diferentes mantidas paradas
Na E2X, o gemini-omni-1.1-flash sai como quatro capacidades a um só preço — $0.18 por segundo em 4K, qualquer que seja a que você chame. Isso muda como pensar nelas: escolher entre elas nunca é uma decisão de orçamento, só de ofício.
O que cada uma fixa:
| Capacidade | O que ela mantém parado | O que ela não mantém |
|---|---|---|
| text-to-video | Nada além das suas palavras | Qualquer coisa que você não escreveu |
| image-to-video | O frame de abertura, exatamente | Tudo depois de mais ou menos o primeiro segundo |
| start-end-frame-to-video | As duas pontas do plano | O caminho entre elas |
| reference-to-video | Identidade e aparência do sujeito | Enquadramento, marcação, posição de câmera |
Leia isso como diagnóstico e não como lista de recursos: nomeie o desvio que você está vendo, depois escolha o endpoint que o endereça.
O plano começa errado. O seu segundo ângulo abre numa sala diferente, ou o personagem entra já no meio de um gesto. Dê a ele um frame: o image-to-video pega uma imagem parada e começa dali, então o plano dois pode abrir num grab do último frame do plano um, ou num render de still que você aprovou antes. É a correção de continuidade mais barata que o modelo oferece.
O plano termina errado. O movimento está certo e a aterrissagem não — a mão alcança a porta e a porta está em outro lugar. Isso é start-end-frame-to-video. Você fornece start_frame_url e end_frame_url, o modelo preenche o intervalo, e o frame que o seu próximo corte precisa casar é um que você escolheu em vez de um que você recebeu.
A pessoa muda. Não o enquadramento, não a marcação — o rosto, o cabelo, o casaco. Isso é reference-to-video, o único dos quatro cujo propósito é identidade. Nosso array image_urls aceita no mínimo uma e no máximo sete; a Runware documenta o mesmo teto — "até 7 imagens" — enquanto a referência do Google não declara número nenhum, embora o exemplo trabalhado dela use seis tags. Trate sete como consenso de terceiros, não como garantia publicada.
Referências de vídeo têm teto mais rígido e o Google publica esses números: "Referências de vídeo suportam no máximo 3 clipes, de até 3 segundos cada", ao lado de "Referenciar ou raciocinar através de múltiplos vídeos não é suportado" — três é um teto do qual você se aproxima, não uma meta a preencher. Sobre o que cabe numa imagem de referência, a documentação da Runware é mais específica que a do Google, recomendando um retrato limpo em plano médio — enquadramento da cintura para cima, fundo neutro, detalhes identificadores visíveis — porque "Planos de corpo inteiro, fundos carregados ou ângulos extremos diluem a leitura do modelo sobre o personagem."
O que o seed fixa, e o que ele não fixa
Não existe sampler neste endpoint. A documentação do Google é categórica: "Instruções de sistema, temperature, top_p, stop sequences e prompts negativos não são suportados." Sem superfície de amostragem, sobra um controle de reprodutibilidade, e ele é o seed — um inteiro opcional que os schemas das nossas quatro capacidades aceitam.
Vale saber de onde vem esse campo, porque ele não está na referência do Google. A documentação 1.1 da Runware carrega um seed e descreve devolver "o seed gerado aleatoriamente" quando você não fornece nenhum; nós expomos o campo em toda capacidade; o Google, na página que você checaria primeiro, não diz nada. Use-o, mas não o trate como contrato.
A parte que pega as pessoas: o seed fixa a amostra, não o sujeito. Mesmo seed e um prompt idêntico byte a byte é uma repetição. Mesmo seed e uma palavra editada é um sorteio novo — amostragem do zero, não um empurrãozinho. Isso é o oposto de um botão de temperatura, e significa que o hábito vindo dos modelos de imagem de segurar o seed enquanto se ajusta o prompt não se transfere.
O que deixa o seed útil para exatamente duas coisas num trabalho de vários planos, e inútil para uma terceira:
- Re-renderizar uma tomada aprovada num tier mais alto. Rascunhe, ache a tomada, depois rode o mesmo prompt e seed na sua resolução de entrega. Nada mudou, então nada é reamostrado.
- Isolar uma variável. Mude a frase de iluminação, segure o seed, e o que se mover é atribuível àquela frase. Não é um experimento controlado, mas é mais rápido do que reamostrar às cegas.
- Carregar um rosto entre dois planos diferentes. Não vai. Dois prompts são dois prompts; o seed não lembra do seu personagem. Identidade entre planos vem de imagens de referência, não de um inteiro.
Anote o seed ao lado do prompt no momento em que uma tomada funciona. Não existe histórico de onde recuperá-lo depois.
Blocos de trava: o mesmo parágrafo, repetido literalmente
Como uma chamada de text-to-video não tem memória da sua chamada anterior, a instrução de continuidade mais comum por aí não é endereçada a ninguém: "Mantenha tudo consistente com o plano anterior" aponta para um plano que o modelo nunca viu.
A correção não tem glamour. Escreva um bloco de fatos de aparência e de cenário e cole-o em todo prompt da sequência, sem alterar — não parafraseado, não enxugado, não reordenado. Uma descrição nova é um sorteio novo.
Aqui estão duas versões do mesmo segundo plano numa sequência de dois planos. Primeiro a que desvia:
Continuing the same scene, a tighter shot of the same man at his
workbench in the garage. Cinematic lighting, moody atmosphere,
highly detailed, professional colour grading. He lifts the machined
part into the light and turns it slowly while his colleague watches
from the right. Keep the characters and the location consistent
with the previous shot. Single continuous shot, no scene cuts.
Sound design: workshop room tone and quiet handling noise.
Conte o que esse prompt deixa sem fixar e você tem a lista das coisas livres para mudar: o verde exato do casaco, se o punho está puído, se existe uma bandana, o que pende do painel de ferramentas, de onde vem a luz. Nada disso está escrito, então nada disso é devido a você — um plano competente de uma tarde diferente é uma resposta correta para o que foi pedido.
A reescrita mantém a ação e gasta suas palavras em fatos em vez de adjetivos:
In a single continuous shot, no scene cuts. Medium two-shot in a
cluttered garage workshop, 40mm lens at f/4, both subjects sharp.

[Lock - repeat verbatim in every shot of this sequence]
Man: mid-forties, close-cropped grey hair parted on his left, faded
green canvas work jacket, frayed left cuff, oil stain on the right
pocket, steel watch on his left wrist. Woman: thirties, dark hair
tied back, grey knit sweater, red bandana at her neck, clipboard in
her right hand. Set: steel workbench, pegboard behind with three
wrenches hanging left of centre, one overhead fluorescent tube,
cold white key from above, no window light.

Action: he lifts a machined aluminium part into the light and turns
it once; she does not move. Sound design: fluorescent hum, the part
clicking down onto steel. No dialogue.
O rótulo entre colchetes é para você, não para o modelo — ele marca a região que você copia. O que ganha lugar no bloco é tudo que for assimétrico ou danificado: de que lado o cabelo reparte, qual punho está puído, qual pulso carrega o relógio, qual mão segura a prancheta. Simetria é onde o desvio se esconde, porque um detalhe simétrico espelhado parece correto sozinho e errado num corte. Nomes de cor pertencem ali, e a luz também: direção, dureza e a ausência explícita de uma fonte que você não quer.
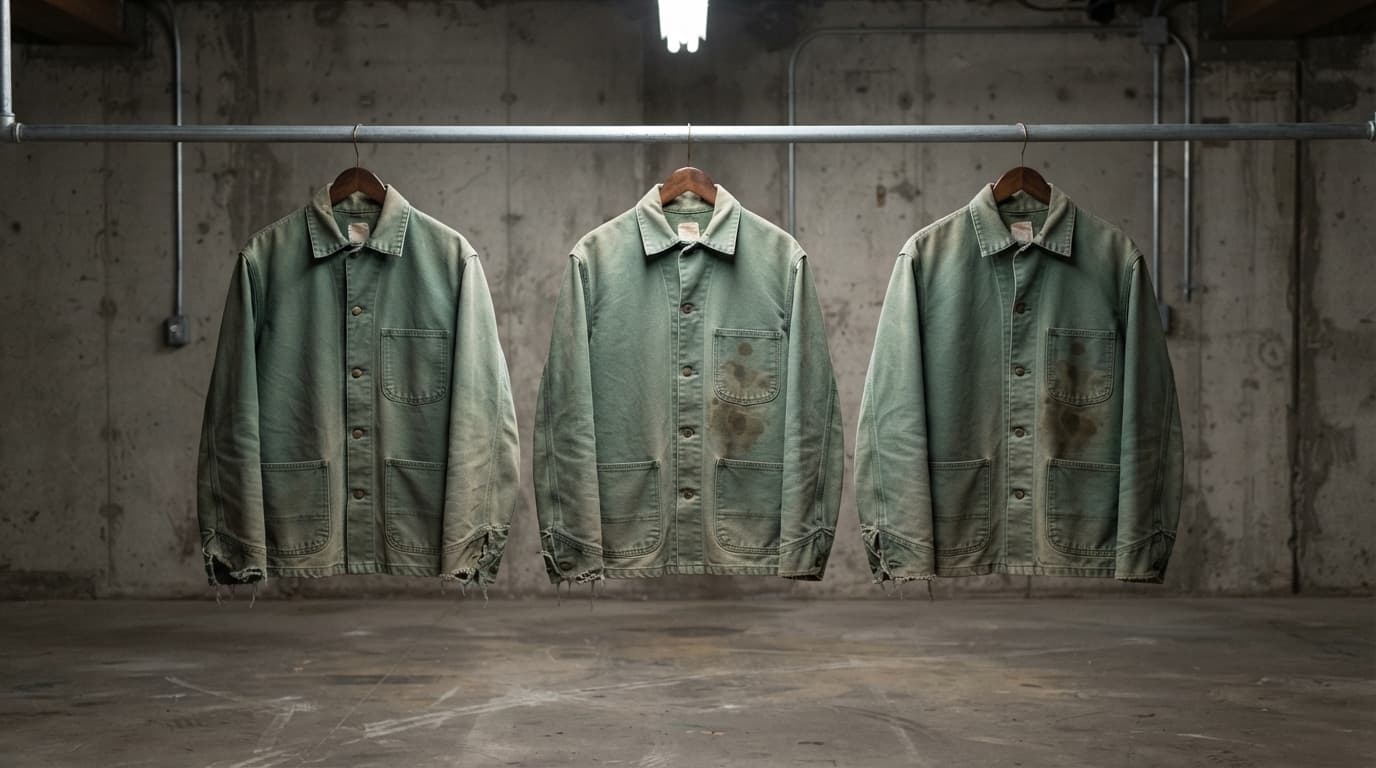
Uma coisa a manter fora do bloco: rótulos impressos, placas, texto legível em objetos de cena. O model card lista texto preciso entre os problemas abertos, então um objeto que precisa ler igual em dois planos é a âncora menos confiável disponível. Ancore em forma e mancha.
A extensão corre para a frente, então planeje para trás
A formulação do Google não deixa margem: "A extensão de vídeo se limita a acrescentar ao fim de um vídeo; prefixar ou estender o meio de um clipe não é suportado." As continuações rodam em passos de dez segundos "até um comprimento total de 40s", e um clipe enviado precisa ter "10 segundos ou menos de duração" antes que você possa estendê-lo.
A consequência de planejamento é maior do que parece: uma cadeia não tem desfazer. O plano um fixa paleta, luz e gramática de câmera para tudo que for acrescentado a ele, então um erro ali é uma sequência que você reconstrói e não um plano que você re-renderiza. E o plano mais arriscado — o gesto difícil, o reflexo complicado — costuma ficar no meio, exatamente onde você não alcança.
Então há uma escolha estrutural a fazer antes da primeira chamada:
- Uma cadeia de extensão te compra continuação genuína de frame a frame e dez segundos de contexto que o modelo de fato lê. Custa a capacidade de corrigir qualquer coisa que não seja a cauda.
- Gerações independentes costuradas num editor, cada uma ancorada por uma imagem de referência ou um frame inicial, custam a emenda invisível e compram a capacidade de refazer o plano três trinta vezes sem tocar nos planos um e dois.
Para uma ação que não pode cortar visivelmente, estenda. Para uma sequência que já tem cortes, gere separadamente — essa também é a opção que sobrevive a um pedido de cliente, e a maioria das sequências recebe um.
Aquele clipe é uma geração só carregando um reenquadramento, e não dois planos unidos:
A two-shot in a cluttered garage workshop, 40mm lens at f/4, both
subjects sharp. A man in a faded green work jacket with a torn left
cuff stands at the bench; a woman in a grey knit sweater with a red
bandana tied at her neck stands to his right holding a clipboard.
The camera holds the wide two-shot for four seconds while he lifts
a machined aluminium part into the light and turns it. Then the
camera pushes in and reframes to a tighter two-shot from the same
axis - same jacket, same torn cuff, same bandana, same bench clutter
behind them, same overhead fluorescent light. No cut, no wardrobe
change, no relight. Sound: fluorescent hum and the part clicking
down onto steel.
Pontos de corte também são cortes de áudio
O áudio é gerado junto com a imagem e não há chave para recusá-lo. Isso normalmente é arquivado como desenho de som; para continuidade é uma restrição, porque o seu corte cai no meio de uma trilha que você não compôs e não pode aparar na origem.
Duas regras decorrem. Descreva a ambiência com palavras idênticas nos dois lados de um corte, do mesmo jeito que você repete o bloco de figurino — "fluorescent hum" nos dois prompts, não "fluorescent hum" e depois "the buzz of the overhead light". Um som de sala que muda na emenda é mais difícil de ignorar do que um casaco que muda de tom, porque o ouvido não tem uma fronteira de plano onde se esconder.
Depois escolha onde cortar com o som em mente. Cortar no meio de um gesto exige que o modelo reproduza o mesmo vetor de movimento do outro lado — exatamente o caso de "movimento complexo" que o model card sinaliza. Cortar numa pose acomodada, com a peça apoiada e a mão parada, dá à próxima geração uma condição inicial inequívoca e ao áudio uma emenda natural. Custa um tempo de ritmo e compra uma junção que se sustenta.
Uma decisão vem antes de tudo isso: proporção de tela. O modelo oferece 16:9 e 9:16 e nada mais. Como a extensão só acrescenta e as imagens de referência herdam o enquadramento em que foram feitas, trocar de orientação no meio de uma sequência não é uma mudança de configuração — invalida todo ativo anterior a ela. Escolha a orientação com a entrega em mente, no plano um.
Quanto custa uma sequência de quatro planos
O ferramental de continuidade neste modelo é de graça. Uma chamada de reference-to-video com sete imagens custa o que custa uma chamada pelada de text-to-video; os frames que você passa ao start-end-frame-to-video não somam nada. Você paga por segundos e resolução.
Quatro planos de oito segundos são trinta e dois segundos. No tier do topo:
| Onde | 32s em 4K |
|---|---|
| E2X | $5.76 |
| Google, a partir das taxas publicadas de tokens | $9.73 |
| fal | $9.60 |
| Runware | $10.24 |
| WaveSpeed | $12.48 |
Essa diferença é uma história de multiplicador, não de desconto. As duas escadas sobem do mesmo jeito de 360p a 1080p; no degrau do topo o Google triplica sua taxa de 720p e nós dobramos a nossa, então a diferença é maior exatamente onde sequências finalizadas são entregues. A conta tier por tier, incluindo por que o tier do topo é um upscale, está no nosso post sobre 4K.
Agora aplique isso a como trabalho de continuidade acontece. Ninguém acerta quatro planos em quatro gerações. Se o plano três levar seis tentativas e o plano quatro levar três, são quinze trabalhos — $21.60 aqui contra $36.49 direto em 4K. O que é o argumento mais forte a favor de gerações independentes em vez de uma cadeia: refazer custa um plano, não a cauda da sequência. Rode os testes de continuidade em 360p, um sexto da taxa por segundo do 4K, e promova a tomada.
Onde ainda escorrega
A versão honesta, já que o model card nos dá a linguagem para ela.
A divisão decorre do que os dois mecanismos conseguem codificar. Uma frase e uma fotografia de referência carregam propriedades grossas e nomeáveis: silhueta e cor da peça de roupa, comprimento e cor do cabelo, geometria da sala, paleta, direção e dureza da luz, a posição aproximada de objetos grandes. Essas um bloco de trava consegue declarar e uma imagem de referência consegue mostrar.
O que nenhum dos dois carrega é precisão abaixo do nível de um nome — geometria facial exata entre enquadramentos distantes, joias, pequenos objetos de fundo, detalhe fino de tecido e qualquer coisa impressa, que o model card lista à parte como pouco confiável. O Google nomeia o padrão só em termos gerais, e resenhistas de terceiros descrevem que ele aparece com mais força em mudanças de cena e movimentos de câmera do que dentro de um plano sustentado. Essa é a nossa leitura da documentação e da cobertura, não uma alegação medida; não rodamos um aparato que colocasse um número nisso.
Na prática: uma sequência com um close herói precisa que esse close seja gerado a partir de um conjunto de referência em vez de herdado de um plano geral, porque identidade sobrevive melhor a um reenquadramento do que a uma mudança de escala. A técnica de rosto em plano único tem um post só dela, e o vocabulário de câmera que mantém dois planos no mesmo eixo está no post de câmera.
Ninguém deveria vender uma narrativa de trinta planos neste modelo prometendo um rosto que nunca se mexe. O que dá para vender é uma sequência em que o desvio é pequeno o bastante para caber dentro de um corte — alcançável com referências, blocos de trava e pontos de corte escolhidos na imobilidade.
Comece pela tabela do início: nomeie o desvio, escolha a ferramenta, escreva o bloco uma vez, repita-o exatamente. A referência de API do Google carrega as formas de tag para vincular referências por nome, e as páginas de capacidade carregam as taxas e schemas atuais.
Preços e termos de produto mudam. Verifique o preço atual de cada provedor antes de tomar uma decisão de compra.
Perguntas frequentes
Como manter um personagem consistente entre planos no Gemini Omni 1.1 Flash?
Dois mecanismos juntos. Passe o personagem como imagens de referência pelo reference-to-video — nosso schema aceita de uma a sete, e a Runware documenta o mesmo teto — e repita um bloco idêntico de fatos de aparência em todo prompt, copiado e não parafraseado. As referências carregam identidade; o texto repetido carrega figurino, objetos de cena e luz. O model card do Google é explícito que consistência completa ao longo de edições ainda está em aberto, então nenhum dos dois sozinho basta.
O seed mantém o mesmo personagem entre dois prompts do Gemini Omni?
Não. O seed fixa uma amostra, não um sujeito. Dois prompts diferentes são dois sorteios diferentes independentemente do seed, e uma palavra editada num prompt de resto idêntico é uma amostra nova e não uma variação. O seed se paga para re-renderizar uma tomada aprovada numa resolução maior e para isolar uma frase alterada. Identidade entre planos vem de imagens de referência.
Qual capacidade do Omni usar para um plano que precisa terminar num frame específico?
start-end-frame-to-video. Você fornece uma imagem inicial e uma final, o modelo gera o intervalo, e o frame que o seu próximo corte precisa casar é um que você escolheu. Na E2X custa o mesmo por segundo que um text-to-video simples, então não há razão de preço para evitá-lo.
O Gemini Omni 1.1 Flash consegue estender um vídeo para trás?
Não. A documentação do Google diz que a extensão só acrescenta ao fim de um clipe, sem jeito de prefixar nem de estender o meio. As continuações rodam em passos de dez segundos até um total de quarenta segundos, e o clipe que você estende precisa ter dez segundos ou menos. Então a primeira geração fixa a aparência de tudo que vem depois, e um erro inicial não pode ser reparado sem reconstruir a cadeia.
Quantas imagens de referência o Gemini Omni 1.1 Flash aceita?
Nosso schema de reference-to-video aceita de uma a sete, e a documentação da Runware declara o mesmo máximo. A referência do próprio Google não publica número nenhum, embora o exemplo trabalhado dela vincule seis imagens tagueadas num prompt só — então trate sete como consenso de terceiros, não como garantia documentada. Referências de vídeo têm teto separado do Google em três clipes de até três segundos cada.
Qual é o melhor lugar para cortar entre dois planos gerados?
Na imobilidade, e não no meio do movimento. Uma pose acomodada dá à próxima geração uma condição inicial inequívoca; um corte dentro de um gesto pede ao modelo que reproduza um vetor de movimento, o caso de movimento complexo que o model card do Google lista como fraqueza conhecida. E como todo clipe chega com uma trilha que você não pode recusar, descreva a ambiência com palavras idênticas nos dois lados da junção ou o som de sala muda no corte.
Dá para misturar planos 16:9 e 9:16 numa mesma sequência do Omni?
Não de forma útil. Essas duas proporções são as únicas opções, a extensão acrescenta na orientação em que começou, e as imagens de referência carregam o enquadramento em que foram feitas — então trocar de orientação no meio invalida todo ativo anterior. Decida paisagem ou retrato contra o formato de entrega antes do plano um.
É mais barato construir uma sequência estendendo ou gerando planos separadamente?
A taxa por segundo é idêntica dos dois jeitos — a extensão não tem desconto — então a diferença é quanto custa refazer. Numa cadeia, corrigir um plano inicial descarta tudo que foi acrescentado a ele. Com gerações independentes ancoradas por imagens de referência ou frames iniciais, um plano ruim custa um plano. Na E2X trinta e dois segundos de 4K são $5.76 contra $9.73 direto do Google, e essa diferença cresce a cada tomada que você descarta.