Gemini Omni 1.1 Flash 上的镜头连续性:哪个端点治哪一种漂移
Google 在同一次发布里公布了关于这个模型的两句话,而它们指向相反的方向。
第一句在发布公告里:Omni 续接一段片子时,现在会读取*「最多 10 秒的前文语境——相对于此前只参考最后一秒的模型是一次飞跃。」十倍的记忆。第二句在 DeepMind 的模型卡里,写在限制那一节:「在编辑全程保持完全的一致性、生成带有复杂运动的场景,或者渲染完全准确的文字,仍然是一项挑战。」*
两句都是真的,而它们合在一起描述了这份活儿。这里的连续性不是一个您能打开的开关,而是一组在输入端做出的选择——您调用哪个端点、用一张图钉住什么、把哪些句子一字不差地重复。一段四段式序列的成本是另一个我们不会重跑的话题。
四个端点,稳住四样不同的东西
在 E2X 上,gemini-omni-1.1-flash 以一个价格提供四项能力——不管您调哪一个,4K 下都是每秒 0.18 美元。这改变了看待它们的方式:在它们之间做选择从来不是一个预算决定,只是一个手艺决定。
每一个钉住的是什么:
| 能力 | 它稳住什么 | 它不会稳住什么 |
|---|---|---|
| 文生视频 | 除了您的词语什么都没有 | 您没写下来的任何东西 |
| 图生视频 | 开场那一帧,精确地 | 大约第一秒之后的一切 |
| 首尾帧生视频 | 镜头的两端 | 两端之间的路径 |
| 参考生视频 | 主体的身份和外观 | 取景、调度、机位 |
把这张表当作一份诊断书来读,而不是一份功能清单:先点名您看到的那种漂移,再挑对症的那个端点。
**镜头开头不对。**您的第二个角度开在了另一个房间里,或者角色走进来时手势已经做到一半了。给它一帧:图生视频接收一张静图并从那里开始,所以第二个镜头可以开在第一个镜头最后一帧的截图上,或者开在您早先审过的一张静帧渲染上。这是模型提供的最便宜的连续性修法。
**镜头结尾不对。**运镜是对的,落点不对——手伸向门,而门在别的地方。那就是首尾帧生视频。您提供 start_frame_url 和 end_frame_url,模型填中间这一段,而您下一刀要接上的那一帧是您自己选的,不是别人塞给您的。
**人变了。**不是取景,不是调度——是脸、头发、外套。那就是参考生视频,四项里唯一以身份为目的的一项。我们的 image_urls 数组最少一张、最多七张;Runware 也写了同样的上限——「最多 7 张图像」——而 Google 的参考没有给出数字,尽管它那个完整示例用了六个标签。把七当作第三方共识,而不是一份公布过的保证。
视频参考的上限更硬,而 Google 确实公布了这些数字:「视频参考最多支持 3 段片段,每段最长 3 秒」,旁边还有*「不支持跨多个视频进行引用或推理」——三是您逼近的天花板,不是您要填满的目标。关于一张参考图里该放什么,Runware 的文档比 Google 的更具体,它推荐一张干净的中景人像——齐腰的取景、中性的背景、能看清辨识特征——因为「全身照、杂乱的背景或者极端的角度,都会稀释模型对这个角色的读取。」*
seed 钉住了什么,又没钉住什么
这个端点上没有采样器。Google 的文档说得很平实:*「不支持系统指令、temperature、top_p、停止序列和负面 prompt。」*没有采样面就意味着只有一个可复现性控制,那就是 seed——一个可选整数,我们四个能力的 schema 都接受它。
值得知道这个字段是从哪儿来的,因为它压根不在 Google 的参考里。Runware 的 1.1 文档带着一个 seed,并描述了当您不提供时会返回*「随机生成的那个 seed」*;我们在每一项能力上都暴露了这个字段;而 Google,在您会第一个去查的那个页面上,什么也没说。用它,但别把它当成一份契约。
会绊倒人的是这一点:seed 钉住的是采样,不是主体。同一个 seed 加上一条逐字节相同的 prompt,是一次重复。同一个 seed 加上改动过的一个词,是一次全新的抽取——重新采样,而不是轻推。这跟 temperature 那种旋钮正好相反,也意味着图像模型那套「固定 seed 然后调 prompt」的习惯迁移不过来。
于是在一个多镜头的活儿里,seed 恰好在两件事上有用,在第三件事上没用:
- **把留下的那条在更高档位上重渲。**先出草稿,找到那一条,然后用同一条 prompt 和同一个 seed 在您的交付分辨率上跑一遍。什么都没变,所以什么都不会重新采样。
- **隔离一个变量。**改动灯光那句话,固定 seed,那么动了的东西就可以归因到那句话上。这不是一次对照实验,但比闭着眼重新采样要快。
- **把一张脸从一个镜头带到另一个镜头。**它做不到。两条 prompt 就是两条 prompt;seed 不记得您的角色。跨镜头的身份来自参考图,而不是来自一个整数。
在某一条片子成了的那一刻,就把 seed 记在 prompt 旁边。事后没有历史记录能帮您找回它。
锁定块:同一段话,一字不差地重复
因为一次文生视频调用对您上一次调用毫无记忆,所以外面最常见的那条连续性指令其实是说给谁都不听的:「Keep everything consistent with the previous shot」指向的是一个模型从未见过的镜头。
解法一点也不光鲜。写一段关于外观和场景的事实,然后把它原封不动地粘进这个序列的每一条 prompt 里——不改写、不精简、不重排。一段新的描述就是一次新的抽取。
下面是一个双镜头序列里同一个第二镜头的两个版本。先看会漂的那个:
Continuing the same scene, a tighter shot of the same man at his
workbench in the garage. Cinematic lighting, moody atmosphere,
highly detailed, professional colour grading. He lifts the machined
part into the light and turns it slowly while his colleague watches
from the right. Keep the characters and the location consistent
with the previous shot. Single continuous shot, no scene cuts.
Sound design: workshop room tone and quiet handling noise.
数一数那条 prompt 留下了多少没被钉住的东西,您就得到了一份可以随便变的清单:外套那个绿色的确切色号、袖口有没有磨损、到底有没有一条头巾、洞洞板上挂着什么、光从哪里来。这些一样都没有写下来,所以一样都不欠您——另一个下午拍出来的一个称职镜头,对刚才那个提问来说就是一个正确答案。
改写版保住了动作,并且把词花在事实上而不是形容词上:
In a single continuous shot, no scene cuts. Medium two-shot in a
cluttered garage workshop, 40mm lens at f/4, both subjects sharp.

[Lock - repeat verbatim in every shot of this sequence]
Man: mid-forties, close-cropped grey hair parted on his left, faded
green canvas work jacket, frayed left cuff, oil stain on the right
pocket, steel watch on his left wrist. Woman: thirties, dark hair
tied back, grey knit sweater, red bandana at her neck, clipboard in
her right hand. Set: steel workbench, pegboard behind with three
wrenches hanging left of centre, one overhead fluorescent tube,
cold white key from above, no window light.

Action: he lifts a machined aluminium part into the light and turns
it once; she does not move. Sound design: fluorescent hum, the part
clicking down onto steel. No dialogue.
方括号里那个标签是给您看的,不是给模型看的——它标出您要复制的那一段。有资格进这个块的,是任何不对称的或有损伤的东西:头发往哪边分、哪只袖口磨了、哪只手腕戴着表、哪只手拿着写字板。对称正是漂移藏身的地方,因为一处被镜像的对称细节单看是对的,一到剪辑里就错了。颜色的名字属于这个块,光也一样:方向、硬度,以及您明确不想要的某个光源的缺席。
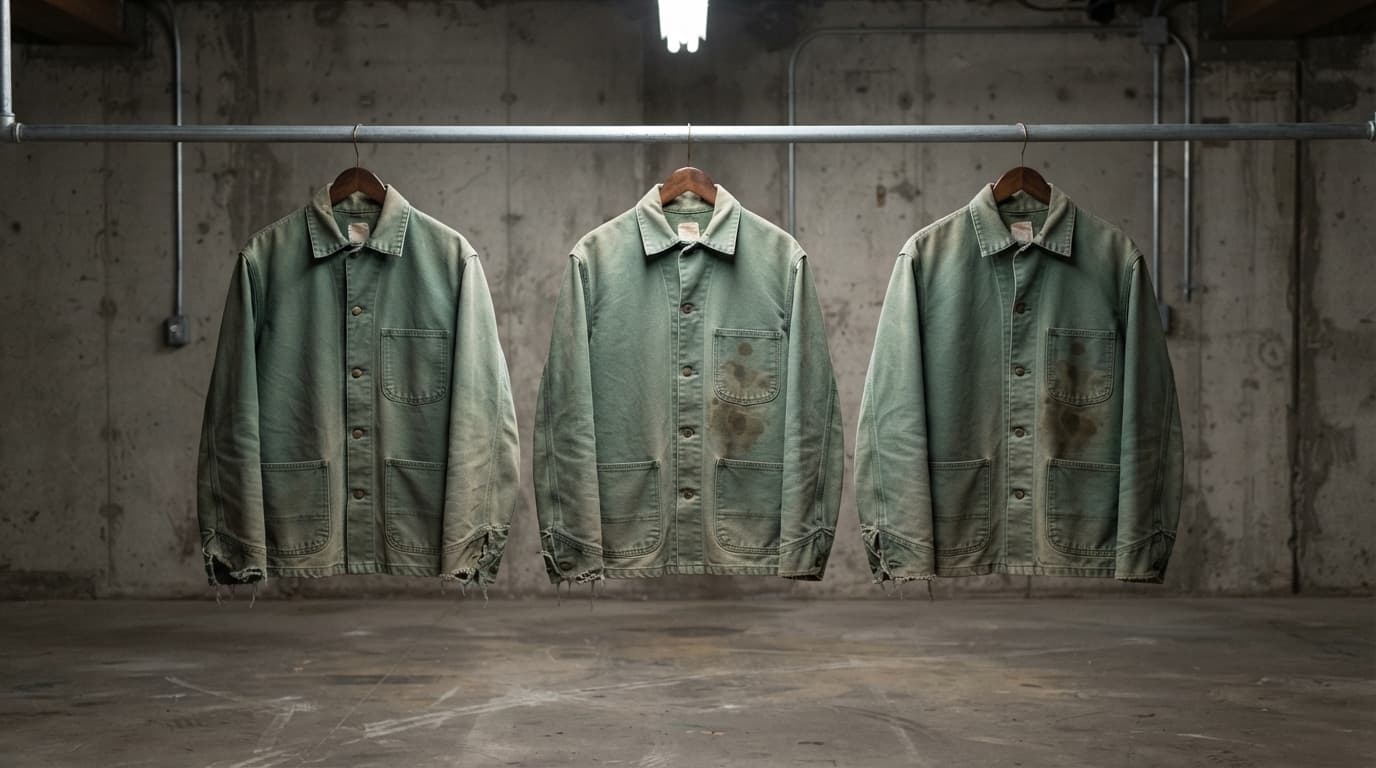
有一样东西要挡在这个块之外:印刷标签、招牌、道具上可读的文字。模型卡把准确的文字列进了尚未解决的问题里,所以一个必须在两个镜头里读起来一样的道具,是可用的锚点里最不可靠的一个。改用形状和污渍来锚定。
延伸只往前跑,所以要倒着计划
Google 的措辞没有留下余地:「视频延伸仅限于追加到视频末尾;不支持在片子前面接内容或延伸片子的中间部分。」续接以十秒为一步进行,「直到总长 40s」,而一段上传的片子必须*「长度在 10 秒或以内」*您才能延伸它。
这在计划上的后果比看上去更大:一条链没有撤销。第一个镜头为后面追加的一切定下了色调、光和相机语法,所以那里出的错是一整段要重建的序列,而不是一个可以重渲的镜头。而风险最高的那个镜头——难做的手势、麻烦的反光——通常就坐在中间,正好是您够不到的地方。
所以在第一次调用之前有一个结构性的选择要做:
- 一条延伸链买到的是真正的逐帧续接,以及模型确实会读的十秒语境。它的代价是,除了尾巴以外您什么都修不了。
- 各自独立生成、再到剪辑软件里拼起来,每一段用一张参考图或一张起始帧锚定,代价是失去无缝的接口,买到的是可以把第三个镜头重跑三十次而完全不碰第一和第二个镜头。
对于一个不能被看见剪开的动作,用延伸。对于本来就有剪辑点的序列,分开生成——那也是能扛住客户意见的那个选项,而大多数序列都会收到一条。
那段片子是一次生成里带了一次重新取景,而不是两个镜头接起来的:
A two-shot in a cluttered garage workshop, 40mm lens at f/4, both
subjects sharp. A man in a faded green work jacket with a torn left
cuff stands at the bench; a woman in a grey knit sweater with a red
bandana tied at her neck stands to his right holding a clipboard.
The camera holds the wide two-shot for four seconds while he lifts
a machined aluminium part into the light and turns it. Then the
camera pushes in and reframes to a tighter two-shot from the same
axis - same jacket, same torn cuff, same bandana, same bench clutter
behind them, same overhead fluorescent light. No cut, no wardrobe
change, no relight. Sound: fluorescent hum and the part clicking
down onto steel.
剪辑点同时也是声音的剪辑点
音频是和画面一起生成的,而且没有开关可以拒绝它。这件事通常被归进声音设计;但对连续性来说它是一条约束,因为您的这一刀落在一条您没有谱写、也无法在源头修剪的声轨中间。
由此有两条规则。用完全相同的词描述一刀两侧的环境声,就像您重复那段服装块一样——两条 prompt 里都写「fluorescent hum」,而不是一条写「fluorescent hum」另一条写「the buzz of the overhead light」。在接口处变掉的环境底噪,比变了色号的外套更难被忽略,因为耳朵没有一个镜头边界可以躲。
然后要带着声音去挑在哪里剪。在手势中间剪,要求模型在另一侧复现同样的运动矢量——正是模型卡点出来的那个*「复杂运动」*的情形。在一个安定下来的姿势上剪,零件已经放下、手也停住了,就给了下一次生成一个毫不含糊的起始条件,也给了音频一道自然的接缝。它的代价是一个节拍的节奏,换来的是一个撑得住的接口。
有一个决定要排在上述所有事情之前:宽高比。这个模型提供 16:9 和 9:16,此外没有别的。因为延伸只做追加,而参考图会继承它们被拍下来时的取景,所以在一个序列进行到一半时切换方向不是改一个设置——它会让它上游的每一份素材作废。在第一个镜头上,就带着交付的样子把方向定下来。
一个四镜头的序列要花多少钱
这个模型上的连续性工具是免费的。一次带七张图的参考生视频调用,和一次光有文字的文生视频调用价钱一样;您传给首尾帧生视频的那两帧不多收一分钱。您付的是秒数和分辨率的钱。
四个八秒镜头就是三十二秒。在最高那一档上:
| 在哪里 | 32 秒 4K |
|---|---|
| E2X | 5.76 美元 |
| Google,按公布的 token 价推算 | 9.73 美元 |
| fal | 9.60 美元 |
| Runware | 10.24 美元 |
| WaveSpeed | 12.48 美元 |
这个差距讲的是倍率,不是折扣。两道阶梯从 360p 到 1080p 爬的方式是一样的;到了最顶那一档,Google 把它的 720p 价格翻三倍,我们翻两倍,所以差距恰好在成片序列交付的那一档上最大。逐档的推算过程,包括为什么最顶那一档是放大出来的,都在我们那篇讲 4K 的文章里。
现在把它套到连续性工作的实际进行方式上。没有人能用四次生成就把四个镜头做定。如果第三个镜头要跑六次、第四个要跑三次,那就是十五个活儿——在 4K 上我们这里 21.60 美元,直连是 36.49 美元。这就是「独立生成优于一条链」最有力的论据:重跑一次的代价是一个镜头,而不是序列的整条尾巴。把连续性测试放在 360p 上跑,那里的每秒价格是 4K 的六分之一,然后把选中的那条提上去。
它仍然会滑掉的地方
诚实的版本,既然模型卡把措辞给了我们。
这道分界来自这两套机制能编码什么。一句话和一张参考照片承载的是粗粒度的、可以点名的属性:轮廓和衣服颜色、头发的长度和颜色、房间的几何、色调、光的方向和硬度、大件道具的大致位置。这些东西,锁定块说得出来,参考图也看得见。
两者都承载不了的是名字级别以下的精度——远近取景之间确切的面部几何、首饰、背景里的小物件、织物的细部,以及任何印刷出来的东西,而模型卡另外把印刷文字列为不可靠。Google 只在很笼统的层面上点了这个规律,而第三方评测者描述它在场景切换和相机运动时最厉害,而不是在一个保持不动的镜头之内。这是我们对文档和报道的解读,不是一个测出来的断言;我们没有搭过能给它一个数字的装置。
实操上:一段带有关键特写的序列,需要让那个特写从一组参考图生成,而不是从一个全景继承过来,因为身份挺得过一次重新取景,比挺过一次景别变化更容易。单镜头的脸部技巧本身是另一篇文章,而让两个镜头保持在同一条轴线上的那套相机词汇在讲相机的那篇里。
没有人应该拿这个模型去卖一个三十镜头的叙事,还承诺一张永远不动的脸。您能卖的,是一段漂移小到可以藏进一次剪辑里的序列——用参考图、锁定块,以及挑在静止处的剪辑点,这是够得着的。
从最上面那张表开始:点名漂移,挑工具,把那个块写一次,然后一字不差地重复。Google 的 API 参考带着按名字绑定参考的标签写法,而各能力页面带着当前价格和 schema。
价格和产品条款会变化。在做采购决定之前,请核对各家服务商当前的定价。
常见问题
在 Gemini Omni 1.1 Flash 上怎么让一个角色跨镜头保持一致?
两套机制一起用。通过参考生视频把角色作为参考图传进去——我们的 schema 接受一到七张,Runware 也写了同样的上限——并且在每一条 prompt 里重复一段完全相同的外观事实块,是复制而不是改写。参考图承载身份;重复的文字承载服装、道具和光。Google 的模型卡明确写着,跨编辑的完全一致性仍未解决,所以两者单独用都不够。
seed 能让同一个角色跨两条 Gemini Omni 的 prompt 保持不变吗?
不能。seed 钉住的是一次采样,不是一个主体。两条不同的 prompt 就是两次不同的抽取,跟 seed 无关,而在一条其余完全相同的 prompt 里改一个词,也是一次全新的采样,而不是一次变体。seed 的价值在于把一条审过的片子在更高分辨率上重渲,以及隔离出改动过的那一句话。跨镜头的身份来自参考图。
一个必须结束在特定某一帧上的镜头,我该用 Omni 的哪项能力?
首尾帧生视频。您提供一张起始图和一张结束图,模型生成中间这一段,而您下一刀要接上的那一帧是您自己选的。在 E2X 上它的每秒价格和普通的文生视频一样,所以没有价格上的理由去回避它。
Gemini Omni 1.1 Flash 能往回延伸一段视频吗?
不能。Google 的文档说延伸只会追加到片子末尾,没有办法在前面接内容或延伸中间部分。续接以十秒为一步进行,直到总长四十秒,而您要延伸的那段片子必须是十秒或更短。所以第一次生成就为它之后的一切定下了观感,而早期的一个错误不重建整条链就没法修。
Gemini Omni 1.1 Flash 接受多少张参考图?
我们的参考生视频 schema 接受一到七张,而 Runware 的文档给出了同样的上限。Google 自己的参考没有公布数字,尽管它那个完整示例在一条 prompt 里绑定了六张带标签的图像——所以把七当作第三方共识,而不是一份写进文档的保证。视频参考被 Google 另行限制为最多三段、每段最长三秒。
两个生成出来的镜头之间,最好的剪辑点在哪里?
在静止处,而不是动作中间。一个安定下来的姿势给了下一次生成一个毫不含糊的起始条件;而在一个手势内部剪,是要求模型复现一个运动矢量,也就是 Google 模型卡列为已知弱项的那个复杂运动情形。而且既然每一段片子来的时候都带着一条您拒绝不了的声轨,就要在接口两侧用完全相同的词描述环境声,否则环境底噪会在剪辑点上变掉。
我能在一个 Omni 序列里混用 16:9 和 9:16 的镜头吗?
没什么用。这两个比例是仅有的选项,延伸会按它开始时的方向追加,而参考图带着它们被拍下时的取景——所以中途换方向会让上游的每一份素材作废。在第一个镜头之前,就对着交付格式把横屏还是竖屏定下来。
用延伸还是分开生成来搭一个序列更便宜?
两种方式的每秒价格完全一样——延伸没有折扣——所以差别在于重跑一次要花多少钱。在一条链里,修一个靠前的镜头会把追加在它后面的一切都扔掉。而用参考图或起始帧锚定的独立生成,一个坏镜头只花掉一个镜头。在 E2X 上三十二秒的 4K 是 5.76 美元,直连 Google 是 9.73 美元,而您每扔掉一条,这个差距就拉大一点。