Cómo escribir prompts para GPT Image 2.5: tipografía, espacio negativo y elección entre high, xhigh o max
La mayoría de los prompts fallidos enviados a GPT Image 2.5 text-to-image fracasan por la misma razón: están escritos para modelos de difusión de 2022 en lugar de para una arquitectura condicionada por lenguaje de 2026. Cuando introduces palabras de moda separadas por comas ("coffee dripper, 8k, hyperrealistic, octane render, studio lighting, award winning") en un endpoint que acepta 32,000 caracteres en lenguaje natural, dejas el 90% de las decisiones espaciales del encuadre al azar estadístico.
GPT Image 2.5 no necesita adjetivos de calidad. Necesita un brief espacial claro escrito con frases declarativas completas, combinado con los ajustes de esquema adecuados (aspect_ratio, resolution y quality: high, xhigh o max). Y cuando pasas de /models/openai/gpt-image-2.5-sunburst/text-to-image a /models/openai/gpt-image-2.5-sunburst/edit-image, las reglas se invierten: volver a describir toda la escena en una llamada de edición provoca desviaciones no deseadas, mientras que un prompt delta conciso fija tu imagen de referencia en su sitio.
A continuación se muestra la estructura exacta de prompt en cuatro partes que utilizamos en los pipelines de producción en E2X, con reescrituras del antes y el después, reglas de formato tipográfico, reserva de espacio negativo y una guía práctica para elegir entre high, xhigh y max cuando los cinco niveles de calidad cuestan los mismos $0.0525 en 1K.
La estructura de frases en 4 partes que GPT Image 2.5 obedece mejor
Con un límite de 32,000 caracteres en GPT Image 2.5 text-to-image y 50,000 caracteres en GPT Image 2.5 edit-image, nunca necesitas telegrafiar tus instrucciones en fragmentos recortados. Escribe oraciones completas en la secuencia exacta en que deseas que se construya el lienzo. Las primeras cláusulas anclan la geometría de la cámara y el objeto principal; las cláusulas posteriores refinan la iluminación, la tipografía y los márgenes vacíos.
Sigue este orden de cuatro partes:
- Sujeto + material + posición: Nombra el medio y el objeto principal, su acabado superficial táctil y dónde se sitúa en el encuadre (
"Matte ceramic pour-over coffee dripper centered on a brushed steel digital scale on a pale ash wood counter"). - Fuente de luz física + dirección: Indica qué genera la luz, desde qué ángulo llega y cómo caen las sombras (
"afternoon sunlight from camera left casting sharp shadows across the brackets"). - Texto entre comillas + tratamiento de fuente/superficie: Cuando el encuadre incluya cartelería, etiquetas o elementos de interfaz, encierra los caracteres exactos entre comillas dobles y describe el estilo de las letras y el sustrato material (
"crisp white sans-serif lettering reading \"PLATFORM 4 — EXPRESS TO GENEVA\" on deep Prussian blue enamel"). - Reserva explícita de espacio negativo: Indica al modelo qué tercio o mitad del lienzo debe permanecer vacío para que tu equipo de diseño pueda superponer texto en HTML o Figma más adelante (
"Keep the right third of the frame an uncluttered warm plaster wall for headline copy").
Antes y después: sopa de palabras clave frente a brief espacial declarativo
Compara lo que ocurre cuando reemplazas una lista genérica de etiquetas por la estructura de oraciones en cuatro partes en tres tareas comerciales habituales.
Tarea 1: Banner principal de comercio electrónico con espacio para texto
Weak prompt (keyword soup):
pour-over coffee maker, digital scale, minimalist kitchen, copy space on right,
product photography, 8k, photorealistic, soft lighting, clean background
Strong prompt (declarative brief):
Matte ceramic pour-over coffee dripper centered on a brushed steel digital scale on a pale ash wood counter. Keep the right third of the frame an uncluttered warm plaster wall for headline copy.
Por qué funciona la reescritura: "copy space on right" dentro de una lista separada por comas rara vez impide que un modelo de imagen cuelgue una estantería, una planta o el marco de una ventana en esa esquina. Nombrar el material exacto de la región vacía ("an uncluttered warm plaster wall") le da al modelo una superficie concreta que renderizar en el tercio derecho del lienzo.
Tarea 2: Cartelería arquitectónica con texto incrustado
Weak prompt (unquoted text and vague style):
vintage blue train station sign that says platform 4 express to geneva,
retro typography, brass brackets, sunny day, ultra detailed
Strong prompt (exact quotes and surface physics):
Vintage enamel railway station platform sign in deep Prussian blue with crisp white sans-serif lettering reading "PLATFORM 4 — EXPRESS TO GENEVA", weathered brass mounting brackets, afternoon sunlight.
Por qué funciona la reescritura: Dejar las palabras objetivo en minúsculas y sin comillas (says platform 4 express to geneva) invita al modelo a parafrasear, omitir signos de puntuación o inventar nombres de estaciones adicionales. Envolver "PLATFORM 4 — EXPRESS TO GENEVA" entre comillas dobles y especificar "crisp white sans-serif lettering" fija tanto el uso de mayúsculas como la geometría de los glifos.
Tarea 3: Composición de mesa con múltiples objetos
Weak prompt (flat inventory list):
desk flatlay with anodized keyboard, walnut desk, orange escape key,
notebook, brass pen, daylight, sharp legends
Strong prompt (spatial hierarchy):
Overhead editorial photograph of an anodized aluminum mechanical keyboard centered on a dark walnut desk. Keycaps in matte charcoal with a single signal-orange Esc key at the top left corner of the board. Closed cream linen notebook resting parallel to the right edge of the keyboard, brass fountain pen centered on the cover. Soft north-window daylight from the upper left, crisp key legends, no other props.
Por qué funciona la reescritura: Cada objeto secundario está anclado en relación con el sujeto principal ("at the top left corner of the board", "parallel to the right edge"), evitando que las geometrías se superpongan.
Reserva de espacio negativo para titulares y superposiciones de UI
Uno de los errores más costosos en los pipelines automatizados de anuncios y páginas de destino es generar una composición cuadrada centrada en 16:9 y esperar que un desarrollador frontend pueda colocar texto blanco flotante sobre el margen izquierdo o derecho. A menos que reclames el espacio vacío en tu prompt, GPT Image 2.5 llenará todo el ancho del encuadre con objetos secundarios, elementos desenfocados o degradados de sombra dramáticos que arruinan el contraste del texto.
Aquí tienes el prompt del gotero de café renderizado en GPT Image 2.5, demostrando cómo responde el modelo cuando asignas explícitamente una superficie de pared al tercio derecho del encuadre:
Matte ceramic pour-over coffee dripper centered on a brushed steel digital scale on a pale ash wood counter. Keep the right third of the frame an uncluttered warm plaster wall for headline copy.
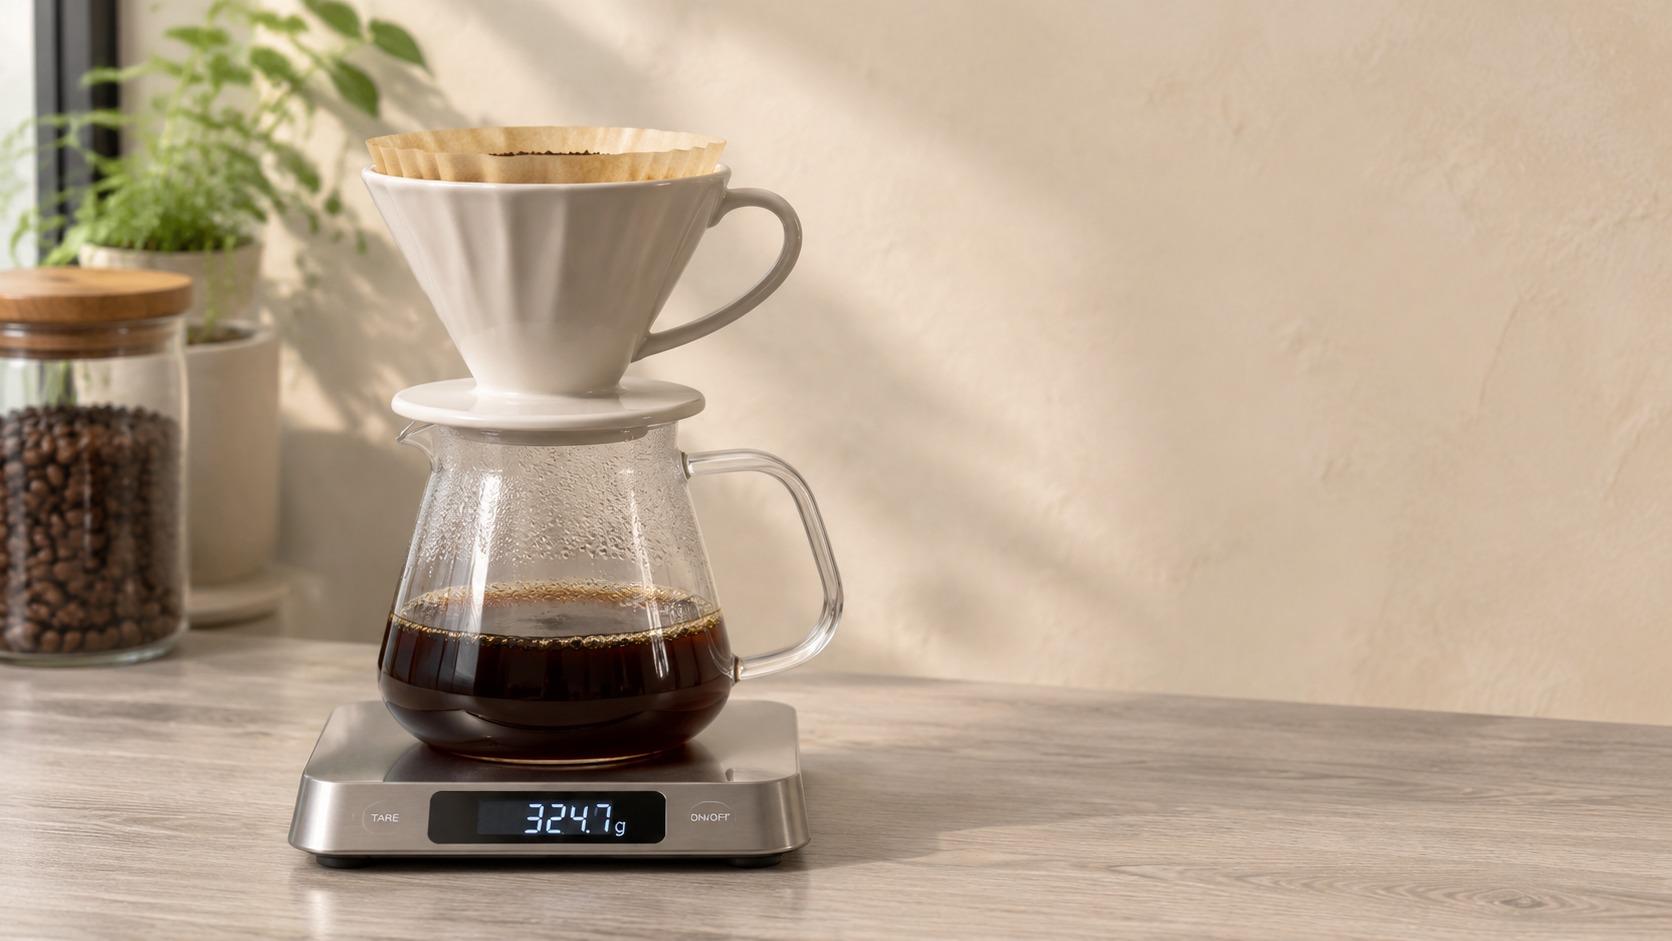
Observa cómo se divide la escena a lo largo del eje horizontal:
- Las estrías de cerámica mate del gotero y la plataforma de pesaje de acero cepillado ocupan las zonas izquierda y centro-izquierda sin quedar recortadas en el borde del fotograma.
- El mostrador de madera de fresno pálido continúa limpiamente hasta el borde derecho, asentando la escena para que no parezca un collage de pantalla dividida pegado a posteriori.
- La zona superior derecha mantiene una superficie uniforme de yeso cálido con una suave caída tonal, lista para recibir tipografía HTML oscura con o sin serifa sin necesidad de colocar un recuadro oscuro translúcido detrás de las palabras.
Cuando escribas instrucciones de espacio negativo, combina siempre la fracción espacial ("the right third", "the upper quarter", "the left half") con el material de fondo específico que debe ocuparla ("uncluttered warm plaster wall", "clear pale overcast sky", "seamless slate-gray studio sweep"). Decirle a un modelo qué hay en el espacio vacío funciona con mucha más fiabilidad que limitarse a decir "leave empty space".
Citar texto exacto y controlar la tipografía superficial
GPT Image 2.5 es el modelo más sólido del catálogo de E2X para renderizar cartelería de varias palabras, etiquetas de envases, portadas de libros y tarjetas de interfaz. Para obtener letras limpias en la primera pasada, sigue cuatro reglas mecánicas siempre que tu prompt contenga texto:
- Envuelve siempre los caracteres exactos entre comillas dobles: Escribe
"PLATFORM 4 — EXPRESS TO GENEVA"exactamente en mayúsculas o en la combinación de mayúsculas y minúsculas que quieras renderizar. - Describe la tipografía por familia visual y grosor, no por nombres de archivos de fuentes comerciales: Utiliza descriptores como
"condensed bold grotesque sans-serif","high-contrast editorial Didone serif"o"hand-painted gold leaf sign-painter capitals". - Especifica cómo se adhiere el texto al material físico: Indica si las letras están
"screen-printed in matte black ink","stamped in recessed gold foil","enameled white on Prussian blue steel"o"backlit acrylic channel letters". - Evita texto sin sentido en el fondo: Si tu escena incluye escaparates, frascos o libros en segundo plano que no deberían mostrar palabras inventadas al azar, cierra tu prompt con
"no other text or logos in the frame".
Aquí está el prompt del letrero ferroviario generado en GPT Image 2.5 aplicando exactamente esas reglas:
Vintage enamel railway station platform sign in deep Prussian blue with crisp white sans-serif lettering reading "PLATFORM 4 — EXPRESS TO GENEVA", weathered brass mounting brackets, afternoon sunlight.
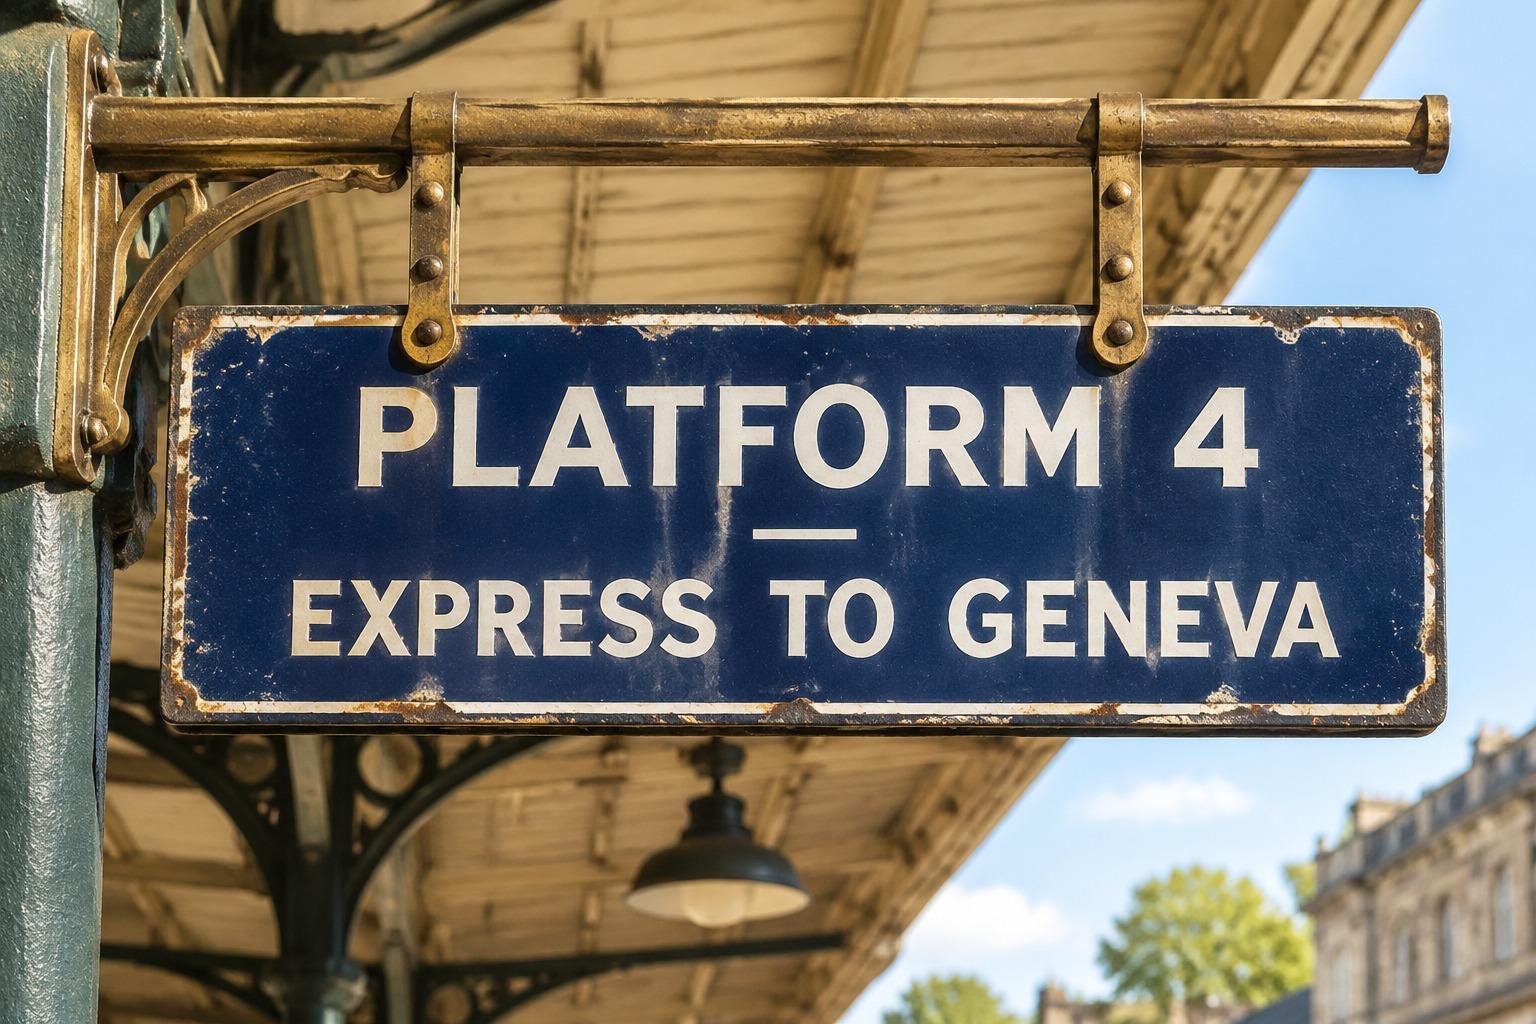
En ese resultado, el modelo conserva el espaciado alrededor del signo de puntuación entre PLATFORM 4 y EXPRESS TO GENEVA, mantiene uniforme el grosor del trazo blanco sin serifa a lo largo de toda la placa horizontal y renderiza sutiles brillos especulares de sol de tarde tanto en el esmalte azul como en las letras pintadas de blanco. Al mismo tiempo, los soportes de montaje de latón envejecido en las esquinas muestran detalles de oxidación y pernos sin invadir el borde interior del cartel.
Cómo elegir entre calidad high, xhigh y max en E2X
En /models/openai/gpt-image-2.5-sunburst/text-to-image y /models/openai/gpt-image-2.5-sunburst/edit-image, el parámetro quality acepta cinco valores: low, medium, high (el valor por defecto del esquema cuando se omite), xhigh y max. En E2X, GPT Image 2.5 está disponible en dos variantes: GPT Image 2.5 Sunburst (openai/gpt-image-2.5-sunburst, que admite resoluciones 1K/2K/4K y niveles de calidad low, medium, high, xhigh, max) y GPT Image 2.5 Flare (openai/gpt-image-2.5-flare, que admite /models/openai/gpt-image-2.5-flare/text-to-image y /models/openai/gpt-image-2.5-flare/edit-image con resoluciones 1K/2K/4K y niveles de calidad low, medium, high).
Antes de decidir qué ajuste enviar, comprende cómo factura E2X este parámetro. Cada llamada parte de una tarifa base de lista de $0.03, que nuestro descuento permanente del 75% reduce a $0.0075. A partir de ahí:
- Cada ajuste de
quality(low,medium,high,xhighymax) aplica exactamente el mismo multiplicador ×7. resolutionaplica un multiplicador ×1 en1K($0.0525), ×2 en2K($0.1050) y ×3 en4K($0.1575).
Los precios y las condiciones de los productos pueden cambiar. Consulta los precios actuales de cada proveedor antes de tomar una decisión de compra. Los precios Batch o Flex de Google no son directamente equivalentes a una solicitud de API estándar bajo demanda porque las condiciones de programación, disponibilidad y procesamiento difieren; por lo tanto, se excluyen de esta comparativa. Esta es una comparación acotada, no una afirmación de que E2X sea la opción más barata del mundo en todas las configuraciones.
Dado que low, high, xhigh y max cuestan exactamente los mismos $0.0525 en 1K ($0.105 en 2K, $0.1575 en 4K), no existe ninguna razón financiera para enviar low o medium. Tu verdadero compromiso de ingeniería entre high, xhigh y max está entre la latencia de inferencia y el refinamiento de detalles finos:
| Ajuste de calidad | Precio 1K en E2X | Precio 4K en E2X | Mejor caso de uso |
|---|---|---|---|
high (por defecto) | $0.0525 | $0.1575 | Vistas previas interactivas rápidas, tomas de producto de un solo sujeto, fondos limpios con espacio negativo |
xhigh | $0.0525 | $0.1575 | Cartelería de fachadas, etiquetas de frascos cosméticos, composiciones de mesa con varios objetos, retratos con textura fina de piel o tejido |
max | $0.0525 | $0.1575 | Pósters densos de varias líneas, secciones transversales mecánicas o arquitectónicas detalladas, renderizados máster finales en 2K/4K |
En la práctica, utiliza quality: "high" con resolution: "1K" cuando un usuario esté esperando de forma interactiva en un lienzo de interfaz y tu prompt no tenga texto en cuerpo pequeño. Utiliza quality: "xhigh" en 1K ($0.0525) siempre que tu prompt incluya tipografía entre comillas o múltiples objetos interactuando. Cambia a quality: "max" en 2K ($0.105) o 4K ($0.1575) al renderizar el máster de producción final en una cola de trabajo en segundo plano.
Prompts delta para edit-image frente a prompts de escena completa para text-to-image
Escribir prompts para GPT Image 2.5 edit-image requiere un modelo mental diferente al de text-to-image. Cuando pasas una o más imágenes de origen en image_urls, la escena visual ya existe. Si tu prompt vuelve a describir toda la habitación, la iluminación y la lente de la cámara desde cero, el modelo trata esas frases como instrucciones para regenerar esas regiones, introduciendo sutiles desviaciones en rostros, texturas o perspectiva.
Escribe un prompt para edit-image como un delta estricto con tres componentes:
- Indexa explícitamente las imágenes de origen: Cuando pases múltiples URLs en
image_urls, refiérete a ellas como"image 1","image 2"e"image 3". - Indica la modificación exacta: Describe únicamente el elemento que cambia, incluyendo el texto de reemplazo entre comillas si estás actualizando un letrero o etiqueta.
- Bloquea todo lo demás: Enumera explícitamente los elementos circundantes que deben permanecer intactos.
Compara un prompt de escena completa para text-to-image con su correspondiente prompt delta para edit-image:
Full-scene prompt (for openai/gpt-image-2.5-sunburst/text-to-image):
Vintage enamel railway station platform sign in deep Prussian blue with crisp white sans-serif lettering reading "PLATFORM 4 — EXPRESS TO GENEVA", weathered brass mounting brackets, afternoon sunlight.
Delta edit prompt (for openai/gpt-image-2.5-sunburst/edit-image):
In image 1, change the white sans-serif lettering on the Prussian blue enamel sign to read "PLATFORM 9 — NIGHT TRAIN TO MILAN" in the exact same font weight, kerning, and enamel surface gloss. Keep the weathered brass mounting brackets, afternoon sunlight angle, and background masonry completely unchanged.
Envía esa llamada de edición delta mediante POST https://api.e2x.ai/v1/jobs/submit, manteniendo aspect_ratio: "auto" para que la salida coincida con las dimensiones de tu imagen de entrada:
curl -X POST https://api.e2x.ai/v1/jobs/submit \
  -H "Authorization: Bearer $E2X_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.5-sunburst/edit-image",
    "input": {
      "prompt": "In image 1, change the white sans-serif lettering on the Prussian blue enamel sign to read \"PLATFORM 9 — NIGHT TRAIN TO MILAN\" in the exact same font weight, kerning, and enamel surface gloss. Keep the weathered brass mounting brackets, afternoon sunlight angle, and background masonry completely unchanged.",
      "image_urls": [
        "https://assets.e2x.ai/assets/posts/gpt-image-2-5-prompting-guide/example-2.jpg"
      ],
      "aspect_ratio": "auto",
      "resolution": "2K",
      "quality": "max"
    }
  }'
Recuerda dos reglas de esquema cuando te muevas entre generación y edición en E2X:
openai/gpt-image-2.5-sunburst/edit-imageacepta prompts de hasta 50,000 caracteres (frente a los 32,000 entext-to-image), por lo que los scripts de localización automatizados pueden pasar reglas de diseño completas sin truncamiento.- Ninguno de los endpoints de GPT Image 2.5 incluye
background: "transparent". Si el recorte de un packshot necesita un canal alfa en una sola llamada de API, dirige ese trabajo a GPT Image 2 text-to-image o GPT Image 2 edit-image al mismo precio de $0.0525 (1K).
Para comparativas directas entre modelos, lee nuestros análisis de GPT Image 2.5 vs Nano Banana 2.1 y GPT Image 2.5 vs FLUX.2 Pro y Max, o consulta nuestra guía de prompts para Nano Banana. También puedes inspeccionar los esquemas de parámetros en bruto en la especificación llms.txt de text-to-image y en la especificación llms.txt de edit-image, o explorar todos los modelos en el catálogo de E2X.
Preguntas frecuentes
¿Cuál es el mejor orden de frases para un prompt de GPT Image 2.5?
Comienza con el sujeto principal, su acabado material y su posición en el encuadre. Continúa con la fuente de luz física y la dirección de las sombras, luego especifica cualquier texto exacto dentro de la imagen entre comillas dobles junto con su fuente y tratamiento superficial, y termina reservando espacio negativo explícito (nombrando tanto la región del encuadre como la superficie de fondo despejada).
¿Por qué GPT Image 2.5 escribe mal las palabras cuando no uso comillas?
Cuando las palabras objetivo se escriben dentro de la frase sin comillas, la capa de condicionamiento lingüístico puede tratarlas como descripciones temáticas en lugar de cadenas de caracteres literales. Envolver la cadena exacta entre comillas dobles (reading "PLATFORM 4 — EXPRESS TO GENEVA"), indicar el estilo de fuente ("crisp white sans-serif lettering") y configurar quality en xhigh o max indica al modelo que renderice esos glifos exactos.
¿Debería usar siempre la calidad max en GPT Image 2.5 ya que cuesta lo mismo que high?
En E2X, low, medium, high, xhigh y max aplican el mismo multiplicador ×7 ($0.0525 en 1K, $0.105 en 2K, $0.1575 en 4K). Utiliza xhigh o max siempre que tu prompt contenga tipografía incrustada, texturas finas de piel o tela, o restricciones espaciales con múltiples objetos. Mantén high cuando busques un tiempo de respuesta más rápido en borradores sencillos de un solo sujeto o fondos limpios.
¿Cómo reservo espacio limpio para superposiciones de texto en HTML?
Especifica tanto la fracción del encuadre como la superficie física exacta que debe ocupar esa zona vacía, por ejemplo "Keep the right third of the frame an uncluttered warm plaster wall for headline copy" o "Keep the upper half a clear pale overcast sky with no clouds or objects". Nombrar la superficie evita que el modelo rellene el espacio con objetos de fondo aleatorios.
¿En qué debe diferenciarse un prompt de edit-image de uno de text-to-image?
Para /models/openai/gpt-image-2.5-sunburst/text-to-image, describe toda la escena desde cero (hasta 32,000 caracteres). Para /models/openai/gpt-image-2.5-sunburst/edit-image (hasta 50,000 caracteres), escribe únicamente el delta: haz referencia al archivo de entrada por su número ("In image 1..."), indica el elemento exacto o el texto entre comillas que cambia e instruye explícitamente al modelo para que mantenga sin cambios todos los demás objetos, la iluminación y el ángulo de cámara.