Anschluss auf Gemini Omni 1.1 Flash: Welcher Endpunkt welche Abweichung behebt
Google hat zum selben Launch zwei Sätze über dieses Modell veröffentlicht, und sie zeigen in entgegengesetzte Richtungen.
Der erste steht in der Ankündigung: Wenn Omni einen Clip fortsetzt, liest es jetzt „up to 10 seconds of prior context — a leap from previous models that only referenced the final second.“ Zehnmal so viel Gedächtnis. Der zweite steht in DeepMinds Modellkarte unter den Einschränkungen: „maintaining complete consistency throughout edits, generating scenes with complex motion, or rendering perfectly accurate text remains a challenge.“
Beides stimmt, und zusammen beschreiben sie die Aufgabe. Anschluss ist hier kein Schalter, den man umlegt, sondern eine Reihe von Entscheidungen am Input — welchen Endpunkt Sie aufrufen, was Sie mit einem Bild festnageln, welche Sätze Sie wortwörtlich wiederholen. Die Kosten einer vierteiligen Sequenz sind ein eigenes Argument, das wir hier nicht wiederholen.
Vier Endpunkte, vier verschiedene Dinge, die stillgehalten werden
Auf E2X kommt gemini-omni-1.1-flash als vier Capabilities zu einem Preis — $0.18 pro Sekunde in 4K, welche auch immer Sie aufrufen. Das ändert, wie man über sie denkt: Die Wahl zwischen ihnen ist nie eine Budgetentscheidung, nur eine handwerkliche.
Was jede festhält:
| Capability | Was sie stillhält | Was sie nicht hält |
|---|---|---|
| text-to-video | Nichts außer Ihren Worten | Alles, was Sie nicht aufgeschrieben haben |
| image-to-video | Den Eröffnungsframe, exakt | Alles nach ungefähr der ersten Sekunde |
| start-end-frame-to-video | Beide Enden der Einstellung | Den Weg dazwischen |
| reference-to-video | Identität und Aussehen des Motivs | Bildausschnitt, Anordnung, Kameraposition |
Lesen Sie das als Diagnose statt als Featureliste: Benennen Sie die Abweichung, die Sie sehen, und wählen Sie dann den Endpunkt, der sie adressiert.
Die Einstellung beginnt falsch. Ihr zweiter Winkel öffnet in einem anderen Raum, oder die Figur kommt schon mitten in einer Geste herein. Geben Sie ihr einen Frame: image-to-video nimmt ein Standbild und beginnt dort, Einstellung zwei kann also mit einem Grab aus dem letzten Frame von Einstellung eins öffnen oder mit einem zuvor freigegebenen Still-Render. Es ist die günstigste Anschlusshilfe, die das Modell bietet.
Die Einstellung endet falsch. Die Bewegung stimmt und die Landung nicht — die Hand greift zur Tür, und die Tür ist woanders. Dafür gibt es start-end-frame-to-video. Sie liefern start_frame_url und end_frame_url, das Modell füllt das Intervall, und der Frame, auf den Ihr nächster Schnitt passen muss, ist einer, den Sie gewählt haben, statt eines, den man Ihnen gereicht hat.
Die Person wechselt. Nicht der Bildausschnitt, nicht die Anordnung — das Gesicht, die Haare, die Jacke. Dafür gibt es reference-to-video, das einzige der vier, dessen Zweck Identität ist. Unser image_urls-Array nimmt mindestens eins und höchstens sieben; Runware dokumentiert dieselbe Obergrenze — „up to 7 images“ —, während Googles Referenz keine Zahl nennt, ihr durchgerechnetes Beispiel aber sechs Tags verwendet. Behandeln Sie sieben als Konsens Dritter, nicht als veröffentlichte Zusage.
Videoreferenzen sind härter gedeckelt, und diese Zahlen veröffentlicht Google: „Video references support a maximum of 3 clips, up to 3 seconds each“, daneben „Referencing or reasoning across multiple videos is not supported“ — drei ist eine Grenze, der man sich nähert, kein Ziel, das man ausfüllt. Was in ein Referenzbild gehört, dokumentiert Runware genauer als Google und empfiehlt ein sauberes Halbporträt — Bildausschnitt bis zur Taille, neutraler Hintergrund, identifizierende Details sichtbar —, weil „Full-body shots, busy backgrounds, or extreme angles dilute the model's read on the character.“
Was der Seed fixiert und was nicht
Auf diesem Endpunkt gibt es keinen Sampler. Googles Dokumentation ist unumwunden: „System instructions, temperature, top_p, stop sequences, and negative prompts are not supported.“ Keine Sampling-Fläche bedeutet eine einzige Kontrolle über Reproduzierbarkeit, und das ist seed — ein optionaler Integer, den alle vier unserer Capability-Schemata akzeptieren.
Es lohnt sich zu wissen, woher dieses Feld kommt, denn in Googles Referenz steht es überhaupt nicht. Runwares 1.1-Dokumentation führt einen Seed und beschreibt, dass „the randomly generated seed“ zurückgegeben wird, wenn man keinen angibt; wir legen das Feld auf jeder Capability offen; Google sagt auf der Seite, die man zuerst prüfen würde, nichts. Nutzen Sie es, aber behandeln Sie es nicht als Zusage.
Der Teil, über den viele stolpern: Der Seed fixiert die Stichprobe, nicht das Motiv. Gleicher Seed und ein byteidentischer Prompt ist eine Wiederholung. Gleicher Seed und ein geändertes Wort ist eine neue Ziehung — frisch gesampelt, nicht nachjustiert. Das ist das Gegenteil eines Temperatur-Reglers, und es bedeutet, dass die Gewohnheit aus Bildmodellen, den Seed festzuhalten und am Prompt zu drehen, sich nicht überträgt.
Damit ist der Seed in einem mehrteiligen Job für genau zwei Dinge nützlich und für ein drittes nutzlos:
- Einen Keeper auf einer höheren Stufe neu rendern. Entwerfen, den Take finden, dann denselben Prompt und Seed in Ihrer Auslieferungsauflösung fahren. Nichts hat sich geändert, also wird nichts neu gesampelt.
- Eine Variable isolieren. Ändern Sie den Lichtsatz, halten Sie den Seed, und was sich bewegt, ist diesem Satz zuzuschreiben. Kein kontrolliertes Experiment, aber schneller als blind neu zu sampeln.
- Ein Gesicht zwischen zwei verschiedenen Einstellungen tragen. Das leistet er nicht. Zwei Prompts sind zwei Prompts; der Seed erinnert sich nicht an Ihre Figur. Identität über Einstellungen hinweg kommt von Referenzbildern, nicht von einem Integer.
Schreiben Sie den Seed in dem Moment neben den Prompt, in dem ein Take funktioniert. Es gibt keine Historie, aus der er sich später wiederherstellen ließe.
Lock-Blöcke: derselbe Absatz, wortwörtlich wiederholt
Weil ein text-to-video-Aufruf kein Gedächtnis an Ihren vorherigen Aufruf hat, richtet sich die häufigste Anschlussanweisung im Umlauf an niemanden: „Keep everything consistent with the previous shot“ zeigt auf eine Einstellung, die das Modell nie gesehen hat.
Die Abhilfe ist unglamourös. Schreiben Sie einen Block aus Aussehens- und Set-Fakten und fügen Sie ihn unverändert in jeden Prompt der Sequenz ein — nicht umformuliert, nicht gestrafft, nicht umgestellt. Eine neue Beschreibung ist eine neue Ziehung.
Hier sind zwei Fassungen derselben zweiten Einstellung einer zweiteiligen Sequenz. Zuerst die, die abdriftet:
Continuing the same scene, a tighter shot of the same man at his
workbench in the garage. Cinematic lighting, moody atmosphere,
highly detailed, professional colour grading. He lifts the machined
part into the light and turns it slowly while his colleague watches
from the right. Keep the characters and the location consistent
with the previous shot. Single continuous shot, no scene cuts.
Sound design: workshop room tone and quiet handling noise.
Zählen Sie, was dieser Prompt unfixiert lässt, und Sie haben die Liste dessen, was sich ändern darf: das genaue Grün der Jacke, ob die Manschette ausgefranst ist, ob überhaupt ein Kopftuch da ist, was an der Lochwand hängt, woher das Licht kommt. Nichts davon ist aufgeschrieben, also schuldet man Ihnen nichts davon — eine saubere Einstellung von einem anderen Nachmittag ist eine korrekte Antwort auf das, was gefragt wurde.
Die Neufassung behält die Handlung und gibt ihre Wörter für Fakten statt für Adjektive aus:
In a single continuous shot, no scene cuts. Medium two-shot in a
cluttered garage workshop, 40mm lens at f/4, both subjects sharp.

[Lock - repeat verbatim in every shot of this sequence]
Man: mid-forties, close-cropped grey hair parted on his left, faded
green canvas work jacket, frayed left cuff, oil stain on the right
pocket, steel watch on his left wrist. Woman: thirties, dark hair
tied back, grey knit sweater, red bandana at her neck, clipboard in
her right hand. Set: steel workbench, pegboard behind with three
wrenches hanging left of centre, one overhead fluorescent tube,
cold white key from above, no window light.

Action: he lifts a machined aluminium part into the light and turns
it once; she does not move. Sound design: fluorescent hum, the part
clicking down onto steel. No dialogue.
Das Label in eckigen Klammern ist für Sie, nicht für das Modell — es markiert die Region, die Sie kopieren. In den Block gehört alles Asymmetrische oder Beschädigte: auf welcher Seite das Haar gescheitelt ist, welche Manschette ausgefranst ist, welches Handgelenk die Uhr trägt, welche Hand das Klemmbrett hält. Symmetrie ist, wo sich Abweichung versteckt, denn ein gespiegeltes symmetrisches Detail sieht allein richtig aus und im Schnitt falsch. Farbnamen gehören dahinein, und das Licht auch: Richtung, Härte und das ausdrückliche Fehlen einer Quelle, die Sie nicht wollen.
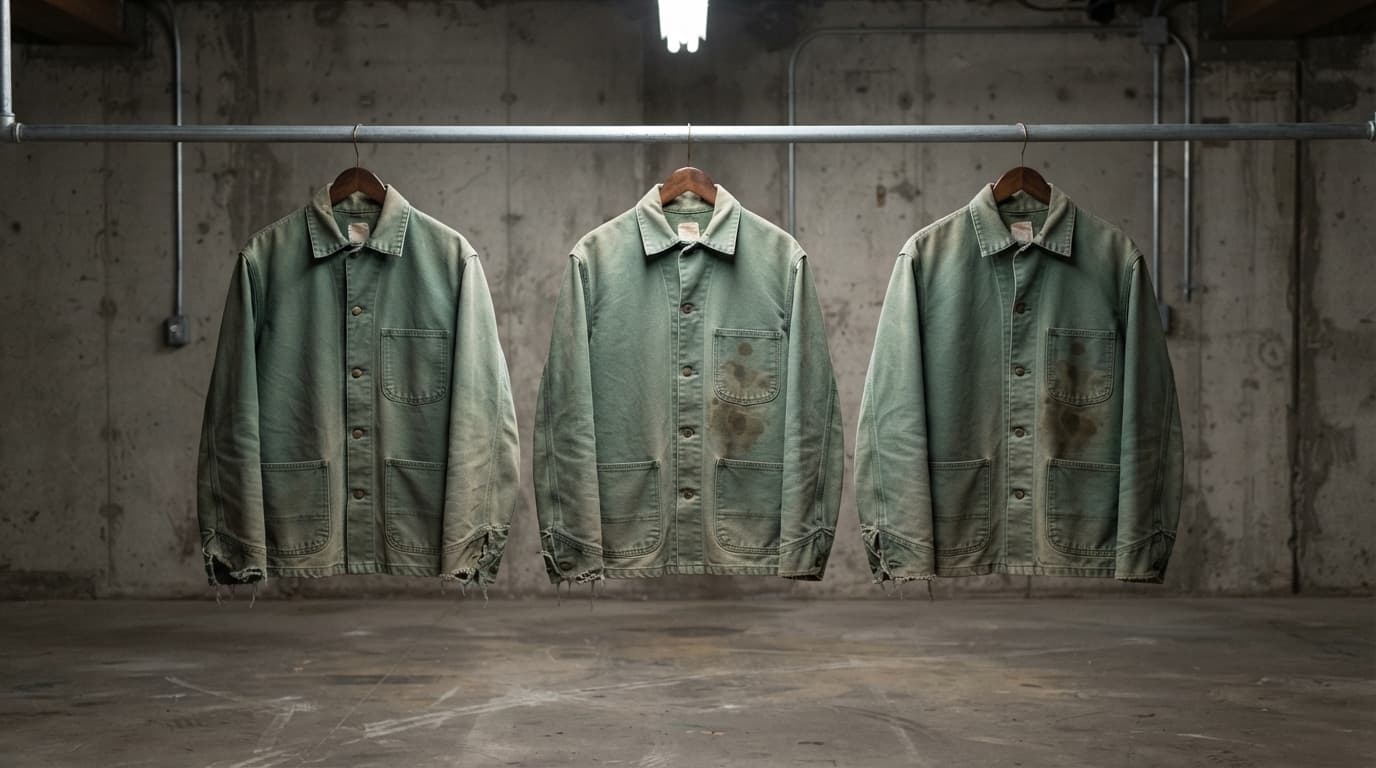
Eines gehört nicht in den Block: aufgedruckte Etiketten, Beschilderung, lesbarer Text auf Requisiten. Die Modellkarte führt korrekten Text unter den offenen Problemen, eine Requisite, die in zwei Einstellungen gleich lesbar sein muss, ist also der unzuverlässigste verfügbare Anker. Verankern Sie stattdessen an Form und Fleck.
Erweiterung läuft vorwärts, planen Sie also rückwärts
Googles Formulierung lässt keinen Spielraum: „Video extension is limited to appending to the end of a video; prepending or extending the middle of a clip is not supported.“ Fortsetzungen laufen in Zehn-Sekunden-Schritten „up to a total length of 40s“, und ein hochgeladener Clip muss „10 seconds or less in length“ sein, bevor Sie ihn erweitern können.
Die Folge für die Planung ist größer, als sie aussieht: Eine Kette hat kein Rückgängig. Einstellung eins legt Palette, Licht und Kameragrammatik für alles fest, was daran angehängt wird, ein Fehler dort ist also eine Sequenz, die Sie neu bauen, keine Einstellung, die Sie neu rendern. Und die riskanteste Einstellung — die schwierige Geste, die knifflige Spiegelung — sitzt meist in der Mitte, genau dort, wo Sie nicht hinkommen.
Vor dem ersten Aufruf steht also eine strukturelle Entscheidung:
- Eine Erweiterungskette kauft Ihnen echte Fortsetzung von Frame zu Frame und zehn Sekunden Kontext, die das Modell tatsächlich liest. Sie kostet Sie die Möglichkeit, irgendetwas außer dem Ende zu korrigieren.
- Getrennte Generierungen, im Schnittprogramm zusammengefügt, jede über ein Referenzbild oder einen Startframe verankert, kosten Sie den nahtlosen Übergang und kaufen Ihnen die Möglichkeit, Einstellung drei dreißigmal neu zu würfeln, ohne Einstellung eins und zwei anzufassen.
Für eine Handlung, die nicht sichtbar schneiden darf, erweitern Sie. Für eine Sequenz, die ohnehin Schnitte enthält, generieren Sie getrennt — das ist auch die Option, die eine Kundenanmerkung übersteht, und die bekommen die meisten Sequenzen.
Dieser Clip ist eine Generierung, die eine Umrahmung trägt, keine zwei zusammengefügten Einstellungen:
A two-shot in a cluttered garage workshop, 40mm lens at f/4, both
subjects sharp. A man in a faded green work jacket with a torn left
cuff stands at the bench; a woman in a grey knit sweater with a red
bandana tied at her neck stands to his right holding a clipboard.
The camera holds the wide two-shot for four seconds while he lifts
a machined aluminium part into the light and turns it. Then the
camera pushes in and reframes to a tighter two-shot from the same
axis - same jacket, same torn cuff, same bandana, same bench clutter
behind them, same overhead fluorescent light. No cut, no wardrobe
change, no relight. Sound: fluorescent hum and the part clicking
down onto steel.
Schnittpunkte sind auch Tonschnitte
Audio wird mit dem Bild erzeugt, und es gibt keinen Schalter, es abzulehnen. Das läuft normalerweise unter Sounddesign; für den Anschluss ist es eine Einschränkung, denn Ihr Schnitt landet mitten in einer Tonspur, die Sie nicht komponiert haben und an der Quelle nicht trimmen können.
Daraus folgen zwei Regeln. Beschreiben Sie das Ambiente auf beiden Seiten eines Schnitts mit identischen Worten, so wie Sie den Garderobenblock wiederholen — „fluorescent hum“ in beiden Prompts, nicht „fluorescent hum“ und dann „the buzz of the overhead light“. Ein Raumton, der am Übergang springt, ist schwerer zu ignorieren als eine Jacke, die den Ton wechselt, weil das Ohr keine Einstellungsgrenze hat, hinter der es sich verstecken kann.
Wählen Sie dann den Schnittpunkt mit dem Ton im Sinn. Mitten in der Geste zu schneiden verlangt vom Modell, denselben Bewegungsvektor auf der anderen Seite zu reproduzieren — genau der Fall „complex motion“, den die Modellkarte markiert. Auf einer ruhenden Pose zu schneiden, das Teil abgelegt und die Hand still, gibt der nächsten Generierung eine eindeutige Ausgangsbedingung und dem Ton eine natürliche Naht. Es kostet einen Takt Tempo und kauft einen Übergang, der hält.
Eine Entscheidung gehört vor all das: das Seitenverhältnis. Das Modell bietet 16:9 und 9:16 und sonst nichts. Weil Erweiterung nur anhängt und Referenzbilder den Bildausschnitt erben, in dem sie aufgenommen wurden, ist ein Orientierungswechsel mitten in einer Sequenz keine Einstellungsänderung — er entwertet jedes Asset stromaufwärts. Wählen Sie die Ausrichtung mit Blick auf die Auslieferung, bei Einstellung eins.
Was eine Vier-Einstellungen-Sequenz kostet
Die Anschluss-Werkzeuge dieses Modells sind gratis. Ein reference-to-video-Aufruf mit sieben Bildern kostet, was ein nackter text-to-video-Aufruf kostet; die Frames, die Sie an start-end-frame-to-video übergeben, kosten nichts extra. Sie zahlen für Sekunden und Auflösung.
Vier Acht-Sekunden-Einstellungen sind zweiunddreißig Sekunden. Auf der obersten Stufe:
| Wo | 32 s in 4K |
|---|---|
| E2X | $5.76 |
| Google, aus veröffentlichten Tokenraten | $9.73 |
| fal | $9.60 |
| Runware | $10.24 |
| WaveSpeed | $12.48 |
Dieser Abstand ist eine Multiplikator-Geschichte, keine Rabatt-Geschichte. Beide Leitern steigen von 360p bis 1080p gleich; auf der obersten Sprosse verdreifacht Google seine 720p-Rate und wir verdoppeln unsere, die Spanne ist also genau dort am größten, wo fertige Sequenzen ausgeliefert werden. Die Rechnung Stufe für Stufe, samt der Frage, warum die oberste Stufe ein Upscale ist, steht in unserem 4K-Beitrag.
Nun wenden Sie das darauf an, wie Anschlussarbeit tatsächlich läuft. Niemand landet vier Einstellungen in vier Generierungen. Wenn Einstellung drei sechs Versuche braucht und Einstellung vier drei, sind das fünfzehn Aufträge — $21.60 hier gegen $36.49 direkt in 4K. Das ist das stärkste Argument für getrennte Generierungen gegenüber einer Kette: Eine Neuwürfelung kostet eine Einstellung, nicht das Ende der Sequenz. Fahren Sie die Anschlusstests in 360p, einem Sechstel der 4K-Rate pro Sekunde, und befördern Sie den Take.
Wo es weiterhin rutscht
Die ehrliche Fassung, da uns die Modellkarte die Sprache dafür liefert.
Die Trennung folgt daraus, was die beiden Mechanismen kodieren können. Ein Satz und eine Referenzfotografie tragen grobe, benennbare Eigenschaften: Silhouette und Kleidungsfarbe, Haarlänge und -farbe, Raumgeometrie, Palette, Lichtrichtung und -härte, die ungefähre Platzierung großer Requisiten. Die kann ein Lock-Block benennen und ein Referenzbild zeigen.
Was keiner von beiden trägt, ist Präzision unterhalb der Ebene eines Namens — exakte Gesichtsgeometrie zwischen weit auseinanderliegenden Bildausschnitten, Schmuck, kleine Hintergrundobjekte, feine Stoffdetails und alles Gedruckte, das die Modellkarte gesondert als unzuverlässig führt. Google benennt das Muster nur allgemein, und Rezensenten Dritter beschreiben, dass es am härtesten bei Szenenwechseln und Kamerabewegungen zuschlägt statt innerhalb einer gehaltenen Einstellung. Das ist unsere Lesart der Dokumentation und der Berichte, keine gemessene Behauptung; wir haben keinen Aufbau gefahren, der eine Zahl darauf setzen würde.
Praktisch: Eine Sequenz mit einer Hero-Nahaufnahme braucht diese Nahaufnahme aus einem Referenzsatz erzeugt statt aus einer Totalen geerbt, weil Identität eine Umrahmung besser übersteht als einen Wechsel der Einstellungsgröße. Die Technik für das Gesicht in einer einzelnen Einstellung ist ein eigener Beitrag, und das Kameravokabular, das zwei Einstellungen auf einer Achse hält, steht im Kamerabeitrag.
Niemand sollte auf diesem Modell eine dreißigteilige Erzählung verkaufen und ein Gesicht versprechen, das sich nie bewegt. Verkaufen lässt sich eine Sequenz, in der die Abweichung klein genug ist, um in einem Schnitt zu verschwinden — erreichbar mit Referenzen, Lock-Blöcken und Schnittpunkten, die auf Stillstand gewählt sind.
Fangen Sie bei der Tabelle oben an: Abweichung benennen, Werkzeug wählen, den Block einmal schreiben, exakt wiederholen. Googles API-Referenz trägt die Tag-Formen, um Referenzen namentlich zu binden, und die Capability-Seiten tragen aktuelle Tarife und Schemata.
Preise und Produktbedingungen ändern sich. Prüfen Sie die aktuellen Preise jedes Anbieters, bevor Sie eine Kaufentscheidung treffen.
Häufige Fragen
Wie hält man eine Figur über mehrere Einstellungen in Gemini Omni 1.1 Flash konsistent?
Zwei Mechanismen zusammen. Übergeben Sie die Figur als Referenzbilder über reference-to-video — unser Schema nimmt eins bis sieben, und Runware dokumentiert dieselbe Obergrenze — und wiederholen Sie in jedem Prompt einen identischen Block aus Aussehensfakten, kopiert statt umformuliert. Referenzen tragen Identität; der wiederholte Text trägt Garderobe, Requisiten und Licht. Googles Modellkarte sagt ausdrücklich, dass vollständige Konsistenz über Bearbeitungen hinweg weiterhin offen ist, keiner der beiden reicht also allein.
Hält der Seed dieselbe Figur über zwei Gemini-Omni-Prompts hinweg?
Nein. Der Seed fixiert eine Stichprobe, kein Motiv. Zwei verschiedene Prompts sind zwei verschiedene Ziehungen, unabhängig vom Seed, und ein geändertes Wort in einem ansonsten identischen Prompt ist eine frische Stichprobe statt einer Variation. Der Seed verdient seinen Platz beim Neurendern eines freigegebenen Takes in höherer Auflösung und beim Isolieren eines geänderten Satzes. Identität über Einstellungen hinweg kommt von Referenzbildern.
Welche Omni-Capability nehme ich für eine Einstellung, die auf einem bestimmten Frame enden muss?
start-end-frame-to-video. Sie liefern ein Start- und ein Endbild, das Modell erzeugt das Intervall, und der Frame, auf den Ihr nächster Schnitt passen muss, ist einer, den Sie gewählt haben. Auf E2X kostet es pro Sekunde dasselbe wie einfaches text-to-video, es gibt also keinen preislichen Grund, es zu meiden.
Kann Gemini Omni 1.1 Flash ein Video rückwärts erweitern?
Nein. Googles Dokumentation sagt, dass Erweiterung nur ans Ende eines Clips anhängt, ohne Möglichkeit, davor zu setzen oder die Mitte zu erweitern. Fortsetzungen laufen in Zehn-Sekunden-Schritten bis zu insgesamt vierzig Sekunden, und der Clip, den Sie erweitern, darf höchstens zehn Sekunden lang sein. Die erste Generierung legt also den Look für alles danach fest, und ein früher Fehler lässt sich nicht ohne Neubau der Kette reparieren.
Wie viele Referenzbilder nimmt Gemini Omni 1.1 Flash?
Unser reference-to-video-Schema nimmt eins bis sieben, und Runwares Dokumentation nennt dasselbe Maximum. Googles eigene Referenz veröffentlicht keine Zahl, ihr durchgerechnetes Beispiel bindet aber sechs getaggte Bilder in einem Prompt — behandeln Sie sieben also als Konsens Dritter, nicht als dokumentierte Zusage. Videoreferenzen deckelt Google gesondert auf drei Clips von je bis zu drei Sekunden.
Wo schneidet man am besten zwischen zwei generierten Einstellungen?
Auf Stillstand statt mitten in der Bewegung. Eine ruhende Pose gibt der nächsten Generierung eine eindeutige Ausgangsbedingung; ein Schnitt innerhalb einer Geste verlangt vom Modell, einen Bewegungsvektor zu reproduzieren, den Fall komplexer Bewegung, den Googles Modellkarte als bekannte Schwäche führt. Und weil jeder Clip mit einer Tonspur kommt, die Sie nicht ablehnen können, beschreiben Sie das Ambiente auf beiden Seiten des Übergangs mit identischen Worten, sonst springt der Raumton am Schnitt.
Kann ich 16:9 und 9:16 in einer Omni-Sequenz mischen?
Nicht sinnvoll. Diese beiden Verhältnisse sind die einzigen Optionen, Erweiterung hängt in der Ausrichtung an, in der sie begonnen hat, und Referenzbilder tragen den Bildausschnitt, in dem sie aufgenommen wurden — ein Wechsel der Ausrichtung mittendrin entwertet also jedes Asset stromaufwärts. Entscheiden Sie Quer- oder Hochformat am Auslieferungsformat, vor Einstellung eins.
Ist es günstiger, eine Sequenz durch Erweitern oder durch getrennte Einstellungen zu bauen?
Der Sekundenpreis ist in beiden Fällen identisch — Erweiterung bringt keinen Rabatt —, der Unterschied ist also, was eine Neuwürfelung kostet. In einer Kette verwirft die Korrektur einer frühen Einstellung alles, was daran hängt. Bei getrennten Generierungen, verankert über Referenzbilder oder Startframes, kostet eine schlechte Einstellung eine Einstellung. Auf E2X kosten zweiunddreißig Sekunden 4K $5.76 gegen $9.73 direkt bei Google, und dieser Abstand wächst mit jedem verworfenen Take.