API de OpenAI GPT Image 2.5 en E2X: calidad xhigh y max hasta 4K desde $0.0525
GPT Image 2.5 de OpenAI ya está disponible en la API de E2X a través de dos rutas: openai/gpt-image-2.5-sunburst/text-to-image para generar escenas a partir de un prompt escrito y openai/gpt-image-2.5-sunburst/edit-image para modificar o componer fotos de origen. Con nuestro descuento permanente del 75% aplicado, una solicitud en 1K se factura a $0.0525, una en 2K a $0.105 y una en 4K a $0.1575.
Esas tarifas se mantienen fijas en todos los ajustes de quality del esquema. En E2X, los nuevos niveles de calidad xhigh y max comparten exactamente el mismo multiplicador ×7 que low, medium y high. Puedes ejecutar cada trabajo en xhigh o max sin sumar ni un centavo a tu factura.
Esta guía cubre la integración completa: cómo la tarifa base y los multiplicadores determinan tu factura, el esquema de entrada completo para ambas rutas, código de producción en curl y TypeScript para sondeo (polling) y webhooks, y los prompts exactos detrás de las imágenes de muestra de esta página.
Cómo se calcula el precio de $0.0525
Comprender la fórmula de facturación en E2X evita dos errores comunes: pagar por resolución 4K mientras aún estás probando la redacción del prompt, y bajar quality para ahorrar dinero cuando quality no cambia el precio.
Tanto openai/gpt-image-2.5-sunburst/text-to-image como openai/gpt-image-2.5-sunburst/edit-image comparten una tarifa base de lista de $0.03 (30,000 microcentavos en la respuesta de la API). E2X aplica un descuento permanente del 75% a esa base, reduciendo la unidad inicial a $0.0075 (7,500 microcentavos). A partir de ahí, el motor de facturación multiplica por dos factores de parámetros:
- El factor
quality:low,medium,high(el valor predeterminado del esquema),xhighymaxutilizan cada uno un multiplicador ×7. Multiplicar$0.0075por7produce$0.0525. - El factor
resolution:1K(el valor predeterminado del esquema) aplica ×1,2Kaplica ×2 y4Kaplica ×3.
Como los cinco valores de quality se asignan al mismo factor ×7 en la tabla de precios dinámicos, resolution es el único parámetro que modifica tu costo por imagen. Nunca verás un cargo sin multiplicar de $0.0075 en un trabajo completado porque quality toma por defecto high (×7) siempre que lo omitas. Y dado que xhigh y max comparten ese factor ×7, bajar a low o medium ahorra cero dólares. Configura quality en high, xhigh o max según la densidad visual de tu prompt y deja low de lado.
| Resolución | Fórmula del multiplicador | Tarifa de lista E2X ($0.03 × 7) | Tarifa E2X (75% dto.) | Microcentavos en la API | fal.ai bajo demanda (nivel high) | Ahorro en E2X |
|---|---|---|---|---|---|---|
1K (predeterminado) | $0.0075 × 7 × 1 | $0.21 | $0.0525 | 52500 | $0.211 | 75% |
2K | $0.0075 × 7 × 2 | $0.42 | $0.1050 | 105000 | $0.222 | 53% |
4K | $0.0075 × 7 × 3 | $0.63 | $0.1575 | 157500 | $0.401 | 61% |
Comparación de tarifas verificada el 4 de noviembre de 2026 frente a los precios bajo demanda de fal.ai. Las tarifas y condiciones de los proveedores pueden cambiar; consulta nuestra página de precios para ver las cifras en tiempo real.
Para los equipos que ejecutan ciclos de diseño iterativos, esa curva de multiplicadores simplifica la elaboración del presupuesto. Mantén resolution fijada en "1K" mientras refinas la iluminación, el ángulo de cámara y el texto incrustado en "xhigh" o "max". Ocho generaciones de borrador en 1K suman $0.42 en total. Una vez que el diseño esté definido, ejecuta un único render maestro en "4K" por $0.1575. Toda la secuencia de nueve imágenes cuesta $0.5775, en comparación con $1.4175 si cada borrador se ejecutara en 4K.
Observa la quinta columna de la tabla anterior. Cada campo monetario devuelto por la API de E2X es un número entero en microcentavos, donde 1,000,000 de microcentavos equivalen a $1.00 USD. Una generación en 1K devuelve 52500, una generación en 2K devuelve 105000 y una generación en 4K devuelve 157500. Almacena esos enteros directamente en tu tabla contable y divide por 1,000,000 solo al formatear los números para un panel de control humano.
Esquema completo de parámetros para ambos endpoints
Ambas rutas de GPT Image 2.5 se encuentran detrás de la estructura de trabajo estándar de E2X en POST https://api.e2x.ai/v1/jobs/submit. Pasas el identificador del modelo en el nivel superior del cuerpo JSON y colocas todos los controles específicos del modelo dentro del objeto input. En E2X, GPT Image 2.5 está disponible en dos variantes: GPT Image 2.5 Sunburst (openai/gpt-image-2.5-sunburst, que admite resoluciones 1K/2K/4K y niveles de calidad low, medium, high, xhigh, max) y GPT Image 2.5 Flare (openai/gpt-image-2.5-flare, que admite /models/openai/gpt-image-2.5-flare/text-to-image y /models/openai/gpt-image-2.5-flare/edit-image con resoluciones 1K/2K/4K y niveles de calidad low, medium, high).
| Parámetro | Disponibilidad de endpoint | Tipo | Obligatorio | Predeterminado | Valores aceptados / límites |
|---|---|---|---|---|---|
prompt | Ambos endpoints | string | Sí | Ninguno | Hasta 32,000 caracteres en text-to-image; hasta 50,000 caracteres en edit-image. |
image_urls | Solo edit-image | string[] | Sí (en edición) | Ninguno | URLs HTTPS accesibles públicamente para condicionamiento por referencia, composición o edición. |
aspect_ratio | Ambos endpoints | string | No | "1:1" | "auto", "1:1", "4:3", "3:4", "3:2", "2:3", "5:4", "4:5", "16:9", "9:16", "2:1", "1:2", "21:9", "9:21", "3:1", "1:3" (16 en total). |
resolution | Ambos endpoints | string | No | "1K" | "1K", "2K", "4K" (debe ir en mayúsculas). |
quality | Ambos endpoints | string | No | "high" | "low", "medium", "high", "xhigh", "max". |
Tres detalles del esquema merecen atención antes de escribir tu capa de validación:
- Se requieren cadenas de
resolutionen mayúsculas en los modelos de OpenAI. Pasa"1K","2K"o"4K". Si tu base de código ya llama a modelos de Google en nuestro catálogo de texto a imagen, donde las resoluciones van en minúsculas ("1k","2k","4k"), normaliza las mayúsculas y minúsculas por cada identificador de modelo en lugar de compartir una única constante de texto. aspect_ratiotoma por defecto"1:1"y admite"auto". Cuando omitesaspect_ratio, GPT Image 2.5 genera un encuadre cuadrado. Cuando pasas explícitamente"auto", el modelo selecciona una de las proporciones admitidas en función del sujeto descrito en tu prompt (o conserva el encuadre de tu imagen de referencia principal enedit-image).- GPT Image 2.5 omite el parámetro
background. Niopenai/gpt-image-2.5-sunburst/text-to-imageniopenai/gpt-image-2.5-sunburst/edit-imageincluyen el campobackground("transparent","opaque","auto"). Si tu flujo de trabajo necesita un recorte PNG transparente con canal alfa en una sola llamada, dirige esa solicitud aopenai/gpt-image-2/text-to-imageoopenai/gpt-image-2/edit-imagepor el mismo precio de$0.0525. Desglosamos esa decisión de enrutamiento en nuestra comparación entre GPT Image 2.5 y GPT Image 2.
Generando tu primera imagen con curl
Dado que los trabajos de GPT Image 2.5 tardan unos 60 segundos de media, la API de E2X es asíncrona. Tu solicitud POST valida el payload, pone el trabajo en cola y devuelve inmediatamente un jobId.
Aquí tienes una solicitud curl completa que llama a openai/gpt-image-2.5-sunburst/text-to-image con resolución "1K" y calidad "xhigh" ($0.0525):
curl -X POST https://api.e2x.ai/v1/jobs/submit \
  -H "Authorization: Bearer $E2X_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.5-sunburst/text-to-image",
    "input": {
      "prompt": "Overhead editorial photograph of an anodized aluminum mechanical keyboard on a dark walnut desk. Keycaps in matte charcoal with a single signal orange Esc key. Soft north-window daylight from the top left, crisp key legends.",
      "aspect_ratio": "3:2",
      "resolution": "1K",
      "quality": "xhigh"
    }
  }'
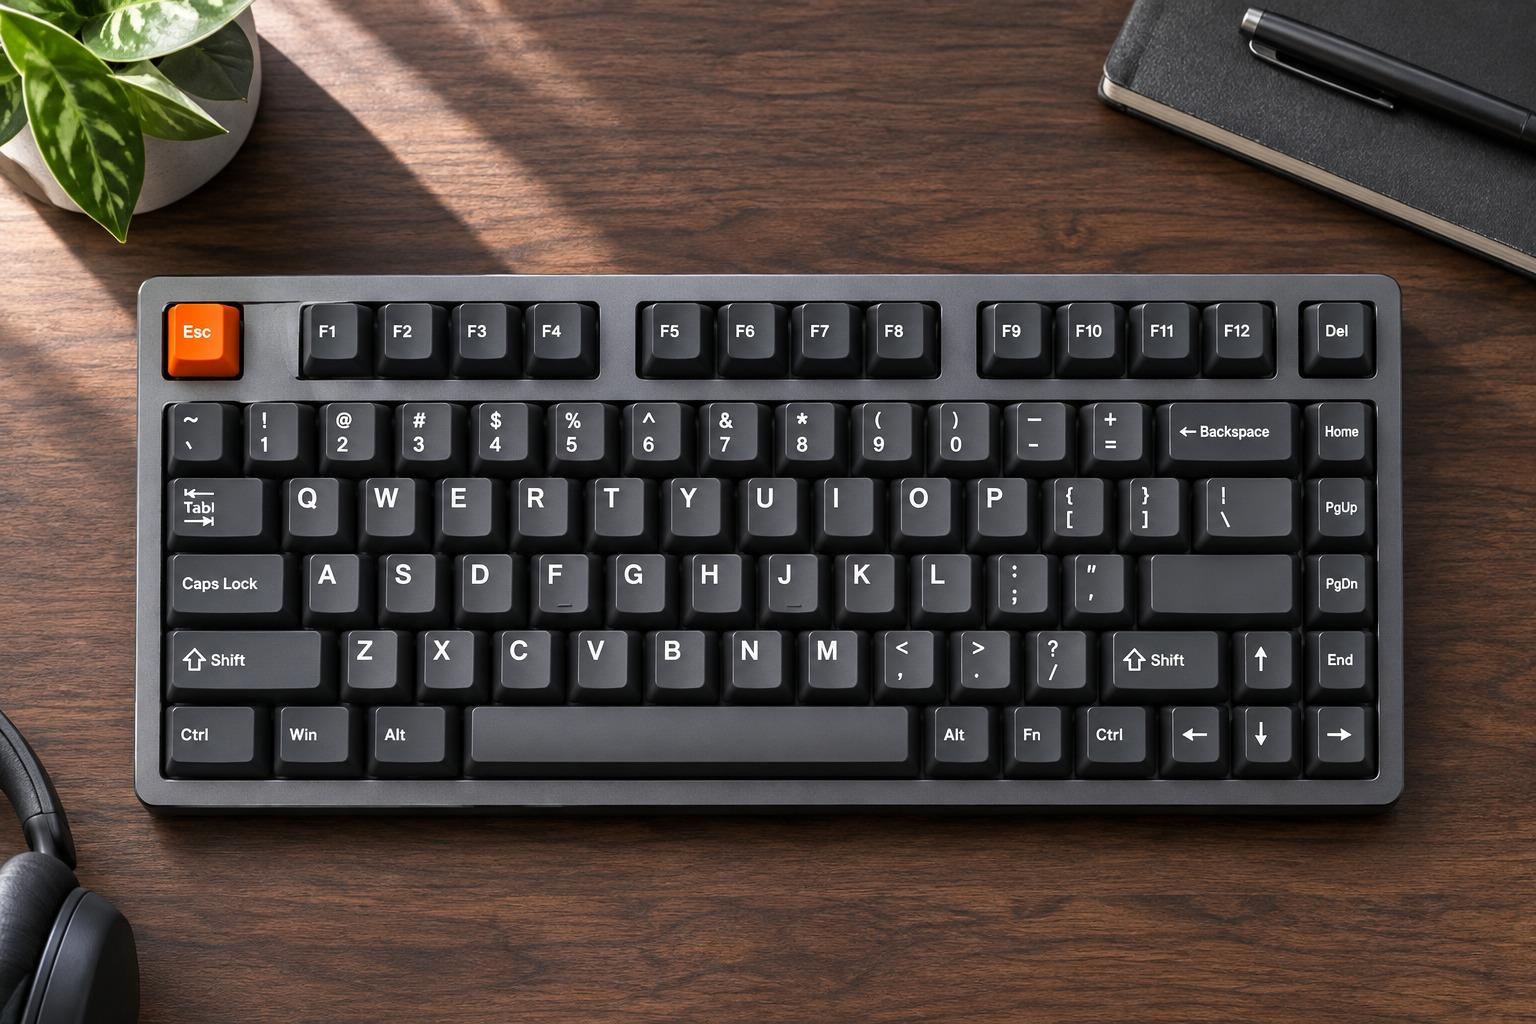
Prompt utilizado para la imagen anterior:
"Overhead editorial photograph of an anodized aluminum mechanical keyboard on a dark walnut desk. Keycaps in matte charcoal with a single signal orange Esc key. Soft north-window daylight from the top left, crisp key legends."
Por qué funciona bien este prompt en calidad "xhigh": los teclados mecánicos son una prueba de estrés clásica para los generadores de imágenes porque el espaciado irregular entre teclas, las filas deformadas o las leyendas borrosas arruinan inmediatamente la toma. Especificar un ángulo de cámara cenital (Overhead editorial photograph), nombrar el material exacto de la carcasa (anodized aluminum), aislar un único acento de color (single signal orange Esc key) y solicitar calidad "xhigh" le da al modelo suficiente presupuesto de muestreo para mantener la cuadrícula de interruptores recta y las leyendas de las teclas nítidas.
Cuando la llamada de envío tiene éxito, la API responde con un 200 OK y un sobre JSON que contiene el identificador de tu trabajo:
{
  "success": true,
  "data": {
    "jobId": "job_01J9X7K3M8P2Q4R6S8T0V2W4Y6",
    "status": "pending"
  }
}
Para comprobar el estado desde tu terminal, llama a GET https://api.e2x.ai/v1/jobs/{jobId} con el mismo encabezado Authorization:
curl -s https://api.e2x.ai/v1/jobs/job_01J9X7K3M8P2Q4R6S8T0V2W4Y6 \
  -H "Authorization: Bearer $E2X_API_KEY"
Cuando data.status pasa de pending a processing y finalmente a completed, la URL de la imagen terminada se encuentra en data.outputs[0].url.
Tipografía y diseño de carteles en calidad max
Una de las razones más sólidas para pasar de high a xhigh o max en GPT Image 2.5 es el renderizado de texto dentro de diseños gráficos estructurados. Los carteles, las portadas de libros, los planos de envases y las tarjetas de interfaz de usuario requieren una alineación estricta de la línea base y formas de letras limpias.
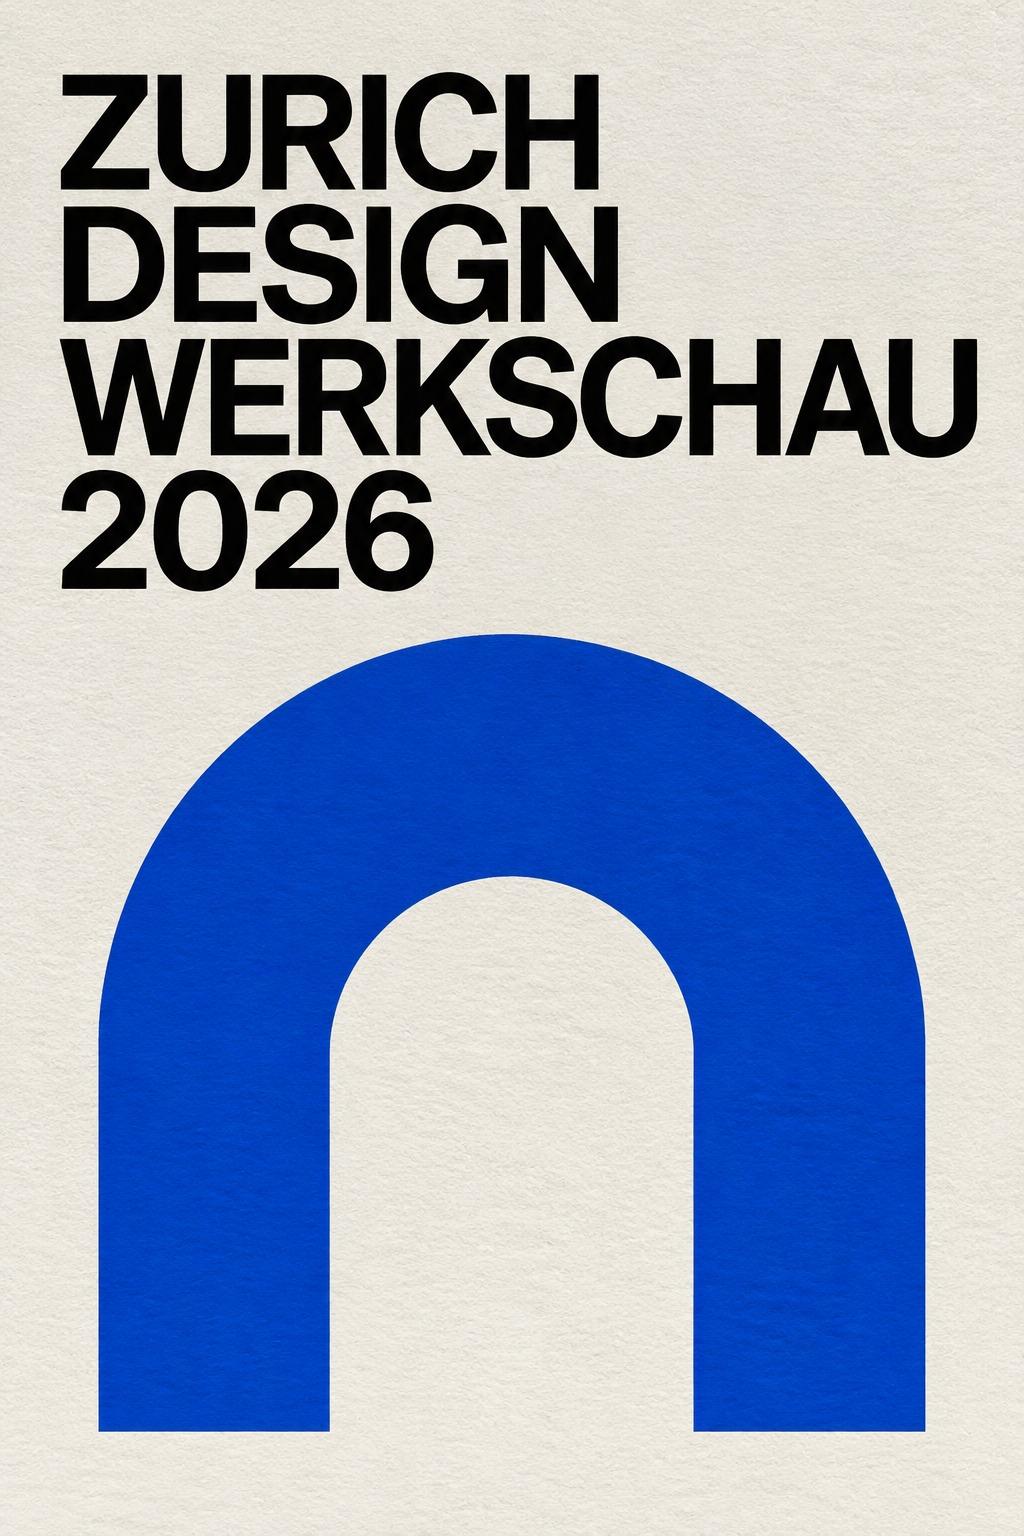
Aquí tienes el prompt y la configuración de parámetros utilizados para generar un cartel de exposición suizo en formato 2:3 con resolución "2K" y calidad "max" ($0.105):
'Minimalist museum poster on textured cotton paper. Centered Swiss grid typography reading "ZURICH DESIGN WERKSCHAU 2026" in bold black grotesque type above a cobalt blue geometric arch.'
Tres reglas prácticas hacen que la rotulación dentro de la imagen sea fiable en GPT Image 2.5:
- Pon la cadena de texto exacta entre comillas. Todo lo que está dentro de las comillas se trata como texto literal para renderizar en el lienzo, mientras que las palabras circundantes describen la tipografía (
bold black grotesque type), el soporte (textured cotton paper) y la ubicación (Centered Swiss grid typography). - Usa
xhighomaxsiempre que las letras sean el punto focal. Dado que E2X facturamaxcon el mismo multiplicador ×7 quehigh, solicitar"quality": "max"ofrece el interletraje más preciso y los bordes de trazo más limpios sin aumentar tu costo. - Elige la relación de aspecto final desde el principio. Un cartel corresponde a
"2:3"o"3:4". Generar en"1:1"y recortar después elimina márgenes de los que depende el diseño de cuadrícula.
Integración en producción con TypeScript: sondeo y almacenamiento
En un backend de Node.js o TypeScript, tu integración debe hacer tres cosas de forma limpia: enviar el trabajo, consultar el estado a un ritmo razonable (unos 3 segundos coincide con el intervalo de sondeo de nuestros workers) y copiar el archivo terminado desde la URL de entrega temporal de E2X a tu propio bucket de S3, R2 o GCS.
No omitas el paso de descarga. La URL devuelta en data.outputs[0].url es un enlace de entrega de corta duración. Almacenar esa cadena directamente en la base de datos de tu aplicación provocará imágenes rotas una vez que caduque el objeto de entrega.
import { writeFile, mkdir } from "node:fs/promises";
import path from "node:path";

const E2X_BASE_URL = "https://api.e2x.ai/v1";
const API_KEY = process.env.E2X_API_KEY;

if (!API_KEY) {
  throw new Error("Missing E2X_API_KEY environment variable");
}

type GptImageResolution = "1K" | "2K" | "4K";
type GptImageQuality = "low" | "medium" | "high" | "xhigh" | "max";

interface SubmitTextToImageInput {
  prompt: string;
  aspect_ratio?: string;
  resolution?: GptImageResolution;
  quality?: GptImageQuality;
  webhookUrl?: string;
}

const headers = {
  Authorization: `Bearer ${API_KEY}`,
  "Content-Type": "application/json",
};

export async function submitGptImage25(
  options: SubmitTextToImageInput
): Promise<string> {
  const { webhookUrl, ...input } = options;

  const response = await fetch(`${E2X_BASE_URL}/jobs/submit`, {
    method: "POST",
    headers,
    body: JSON.stringify({
      model: "openai/gpt-image-2.5-sunburst/text-to-image",
      input: {
        prompt: input.prompt,
        aspect_ratio: input.aspect_ratio ?? "2:3",
        resolution: input.resolution ?? "2K",
        quality: input.quality ?? "max",
      },
      ...(webhookUrl ? { webhookUrl } : {}),
    }),
  });

  if (!response.ok) {
    throw new Error(`Submit failed (${response.status}): ${await response.text()}`);
  }

  const payload = (await response.json()) as { data: { jobId: string } };
  return payload.data.jobId;
}

export async function pollUntilComplete(
  jobId: string,
  timeoutMs = 300_000
): Promise<string> {
  const deadline = Date.now() + timeoutMs;
  let delayMs = 3000;

  while (Date.now() < deadline) {
    await new Promise((resolve) => setTimeout(resolve, delayMs));

    const response = await fetch(`${E2X_BASE_URL}/jobs/${jobId}`, { headers });
    if (!response.ok) {
      throw new Error(`Status check failed with HTTP ${response.status}`);
    }

    const { data } = (await response.json()) as {
      data: {
        status: string;
        outputs?: Array<{ url: string }>;
        error?: { message?: string };
      };
    };

    if (data.status === "completed" && data.outputs?.[0]?.url) {
      return data.outputs[0].url;
    }
    if (data.status === "failed" || data.status === "cancelled") {
      throw new Error(data.error?.message ?? `Job ended in ${data.status}`);
    }

    delayMs = Math.min(Math.round(delayMs * 1.25), 8000);
  }

  throw new Error(`Timed out waiting for job ${jobId}`);
}

async function saveImage(url: string, destination: string): Promise<void> {
  const res = await fetch(url);
  if (!res.ok) throw new Error(`Download failed: HTTP ${res.status}`);
  await mkdir(path.dirname(destination), { recursive: true });
  await writeFile(destination, Buffer.from(await res.arrayBuffer()));
}
Si prefieres usar un cliente preconstruido en lugar de escribir envoltorios de fetch manualmente, consulta la página de SDKs de E2X para ver los paquetes oficiales y ejemplos de configuración.
Cambio a webhooks para cargas de trabajo por lotes
Ambos endpoints de GPT Image 2.5 admiten un límite de concurrencia de 100 trabajos activos por cuenta, junto con límites de tasa de 100 llamadas por minuto, 5,000 llamadas por hora y 50,000 llamadas por día. Cuando ejecutas cerca de 100 trabajos en paralelo, mantener abiertos 100 bucles de sondeo en memoria bloquea los procesos de los workers y hace que los despliegues sean frágiles.
Pasar webhookUrl en la raíz del cuerpo de /v1/jobs/submit elimina el bucle de sondeo. Tan pronto como el trabajo alcanza el estado completed, failed o cancelled, E2X envía una notificación HTTP POST a tu servidor:
curl -X POST https://api.e2x.ai/v1/jobs/submit \
  -H "Authorization: Bearer $E2X_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.5-sunburst/text-to-image",
    "input": {
      "prompt": "Overhead editorial photograph of an anodized aluminum mechanical keyboard on a dark walnut desk. Keycaps in matte charcoal with a single signal orange Esc key. Soft north-window daylight from the top left, crisp key legends.",
      "aspect_ratio": "3:2",
      "resolution": "1K",
      "quality": "xhigh"
    },
    "webhookUrl": "https://api.yourcompany.com/webhooks/e2x-image"
  }'
En tu controlador de webhook, registra el jobId entrante, verifica el estado llamando a GET /v1/jobs/{jobId} con tu clave de API, descarga la imagen de data.outputs[0].url en tu almacenamiento de objetos permanente y marca la fila de la base de datos como completada.
Edición y composición con openai/gpt-image-2.5-sunburst/edit-image
Cuando ya tienes una foto de producto, un diseño de envase o un render arquitectónico y necesitas modificar regiones específicas o combinar múltiples referencias, cambia el identificador del modelo a openai/gpt-image-2.5-sunburst/edit-image.
El precio coincide con el de texto a imagen (1K cuesta $0.0525, 2K cuesta $0.105, 4K cuesta $0.1575), y cambian dos reglas del esquema:
image_urlses obligatorio. Pasa un array de una o más URLs HTTPS accesibles públicamente que apunten a tus imágenes de origen.- El límite de
promptse amplía a 50,000 caracteres. Ese espacio adicional (frente a los 32,000 entext-to-image) permite que los pipelines automatizados de catálogos pasen transcripciones OCR completas, restricciones estrictas de colores de marca y reglas de ubicación por referencia sin provocar un error de longitud.
Aquí tienes una solicitud curl que pasa dos imágenes de origen en image_urls y las compone con resolución "1K" y calidad "max" ($0.0525):
curl -X POST https://api.e2x.ai/v1/jobs/submit \
  -H "Authorization: Bearer $E2X_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.5-sunburst/edit-image",
    "input": {
      "prompt": "Place the brushed titanium chronograph watch from image 1 onto the wet dark slate surface from image 2. Preserve the exact dial markings, hands, and bezel knurling from image 1, and match the cool cyan rim reflections from image 2.",
      "image_urls": [
        "https://your-cdn.example.com/catalog/chronograph-cutout.png",
        "https://your-cdn.example.com/backdrops/wet-slate-studio.jpg"
      ],
      "aspect_ratio": "1:1",
      "resolution": "1K",
      "quality": "max"
    }
  }'
Al escribir prompts para edit-image, indica explícitamente qué debe cambiar y qué debe permanecer intacto, y haz referencia a tus entradas por su posición basada en 1 dentro de image_urls (image 1, image 2). Cubrimos la indexación de múltiples imágenes, el reemplazo de etiquetas de envases y las plantillas de prompts de 50K en detalle en nuestra guía de edición multi-imagen con GPT Image 2.5.
Cómo encaja GPT Image 2.5 en el catálogo de modelos de E2X
Puedes explorar todos los modelos de imagen que alojamos en el catálogo de modelos de E2X o filtrar específicamente por la categoría de texto a imagen y la categoría de imagen a imagen. Dado que todos los modelos en E2X comparten el mismo contrato /v1/jobs/submit, cambiar entre modelos de OpenAI y Google solo requiere modificar la cadena model y hacer coincidir el uso de mayúsculas o minúsculas en resolution.
- Elige GPT Image 2.5 (
1Ka$0.0525,4Ka$0.1575) cuando quieras la fidelidad al prompt y el renderizado tipográfico de OpenAI combinados con los niveles de calidadxhighomaxyaspect_ratio: "auto". - Elige GPT Image 2 (
1Ka$0.0525,4Ka$0.1575) cuando tu pipeline requiera recortes PNG nativos con canal alfa mediantebackground: "transparent". - Elige Google Nano Banana 2.1 (
1Ka$0.03,2Ka$0.04,4Ka$0.09) cuando necesites el precio de generación 4K más bajo en E2X o proporciones panorámicas extremas como8:1y1:8. - Elige Google Nano Banana Pro (
1K/2Ka$0.075,4Ka$0.15) cuando necesites consistencia de personajes con múltiples referencias separadas por rol.
Preguntas frecuentes
¿Por qué xhigh y max cuestan lo mismo que low y high en E2X?
En el esquema de precios de E2X para openai/gpt-image-2.5-sunburst/text-to-image y openai/gpt-image-2.5-sunburst/edit-image, los cinco valores de quality (low, medium, high, xhigh, max) se asignan al mismo multiplicador ×7 sobre el costo base con descuento de $0.0075. Eso te da $0.0525 (1K), $0.105 (2K) y $0.1575 (4K) en cualquier ajuste de calidad.
¿Cuál es la diferencia entre los endpoints text-to-image y edit-image?
openai/gpt-image-2.5-sunburst/text-to-image genera imágenes nuevas únicamente a partir de un prompt de texto (límite de 32,000 caracteres). openai/gpt-image-2.5-sunburst/edit-image requiere tanto prompt (límite de 50,000 caracteres) como image_urls (URLs de imágenes de origen) para editar, cambiar el estilo o componer elementos visuales existentes. Ambos endpoints comparten exactamente los mismos precios y límites de tasa.