API de texto a imagen de GPT Image 2.6 Flare en E2X
GPT Image 2.6 Flare es el endpoint de producción de texto a imagen de alta velocidad de OpenAI en E2X, disponible en openai/gpt-image-2.6-flare/text-to-image. Diseñado para pipelines creativos de baja latencia y aplicaciones interactivas, se ejecuta hasta 2×–2.5× más rápido que GPT Image 2.5 Flare (~6 segundos en calidad low) mientras mantiene nuestro descuento permanente del 75 % ($0.0525 por imagen en resolution: "1K" frente a $0.211 por la solicitud equivalente de nivel alto en fal.ai). GPT Image 2.6 Flare admite generación nativa de .gif animados multifotograma (output_format: "gif"), generación de trazados vectoriales escalables .svg (output_format: "svg") y tres niveles de calidad optimizados (low, medium, high) en resoluciones 1K, 2K y 4K. Dado que los tres ajustes de calidad comparten el mismo multiplicador ×7 en E2X, puedes solicitar high en 1K exactamente por los mismos $0.0525 que low.
Cuando una carga de trabajo requiera los niveles de razonamiento más intensivos xhigh o max para planos arquitectónicos densos o tipografía micrograbada, dirige la solicitud a GPT Image 2.6 Sunburst text-to-image exactamente al mismo precio. Si tu flujo de trabajo comienza con imágenes de referencia existentes, fotos de producto o anotaciones de diseño, llama a GPT Image 2.6 Flare edit-image (Sunburst edit-image), que acepta hasta 16 imágenes de referencia mediante image_urls con la misma tarifa de $0.0525 (1K).
Galería de muestras visuales y GIF animados
Cada muestra visual a continuación se generó a través del pipeline de GPT Image 2.6 y se aloja en la CDN de E2X (assets.e2x.ai), mostrando las animaciones .gif multifotograma en bucle de Flare, renders comerciales nítidos de productos, trazados vectoriales .svg escalables y una comparación lado a lado frente a Sunburst Max.
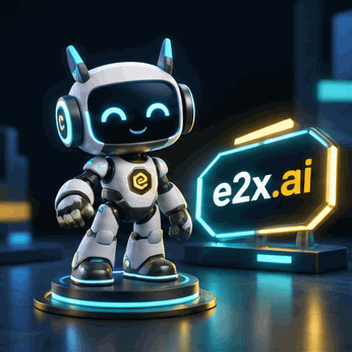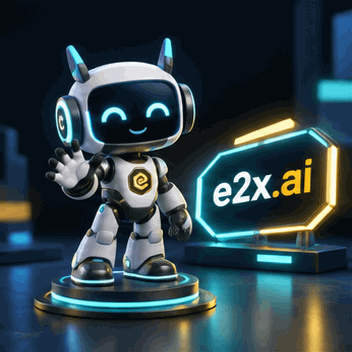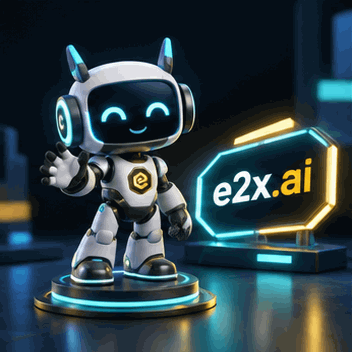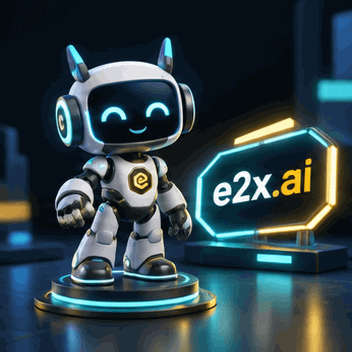
- Endpoint:
openai/gpt-image-2.6-flare/text-to-image (output_format: "gif", aspect_ratio: "1:1", frame_count: 8, frame_duration_ms: 150, 352×352)
- Prompt:
"A cute 3D isometric cyber-robot mascot character waving cheerfully beside a glowing cyan and gold neon badge reading \"e2x.ai\" in a sleek dark studio, smooth looping animation"
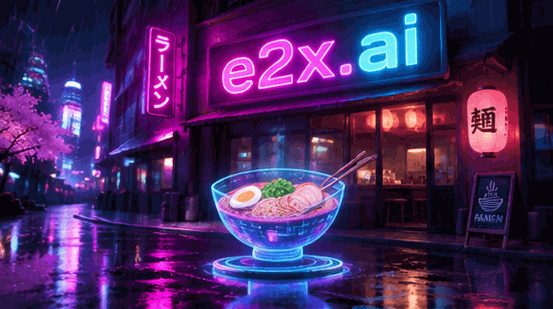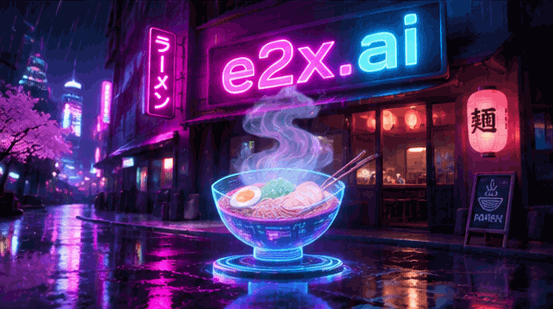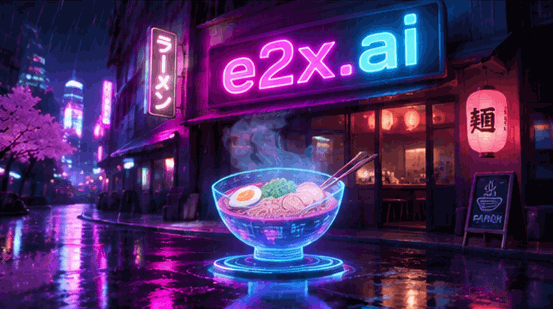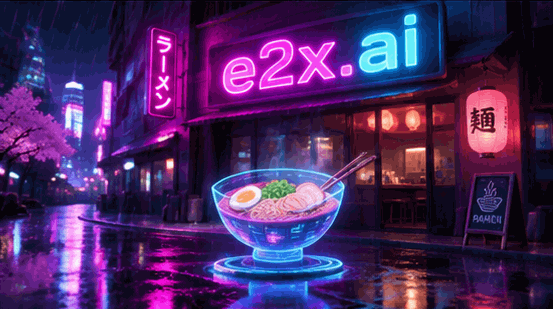
- Endpoint:
openai/gpt-image-2.6-flare/text-to-image (output_format: "gif", aspect_ratio: "16:9", 553×309)
- Prompt:
"Generate an animated GIF of a glowing neon cyberpunk ramen shop sign at night with animated rising steam from a holographic bowl and flickering magenta and cyan rain reflections, crisp neon text reading \"e2x.ai\", looping multi-frame animation"
Toma comercial de producto de alta velocidad: casco de fibra de carbono (aspect_ratio: "1:1")
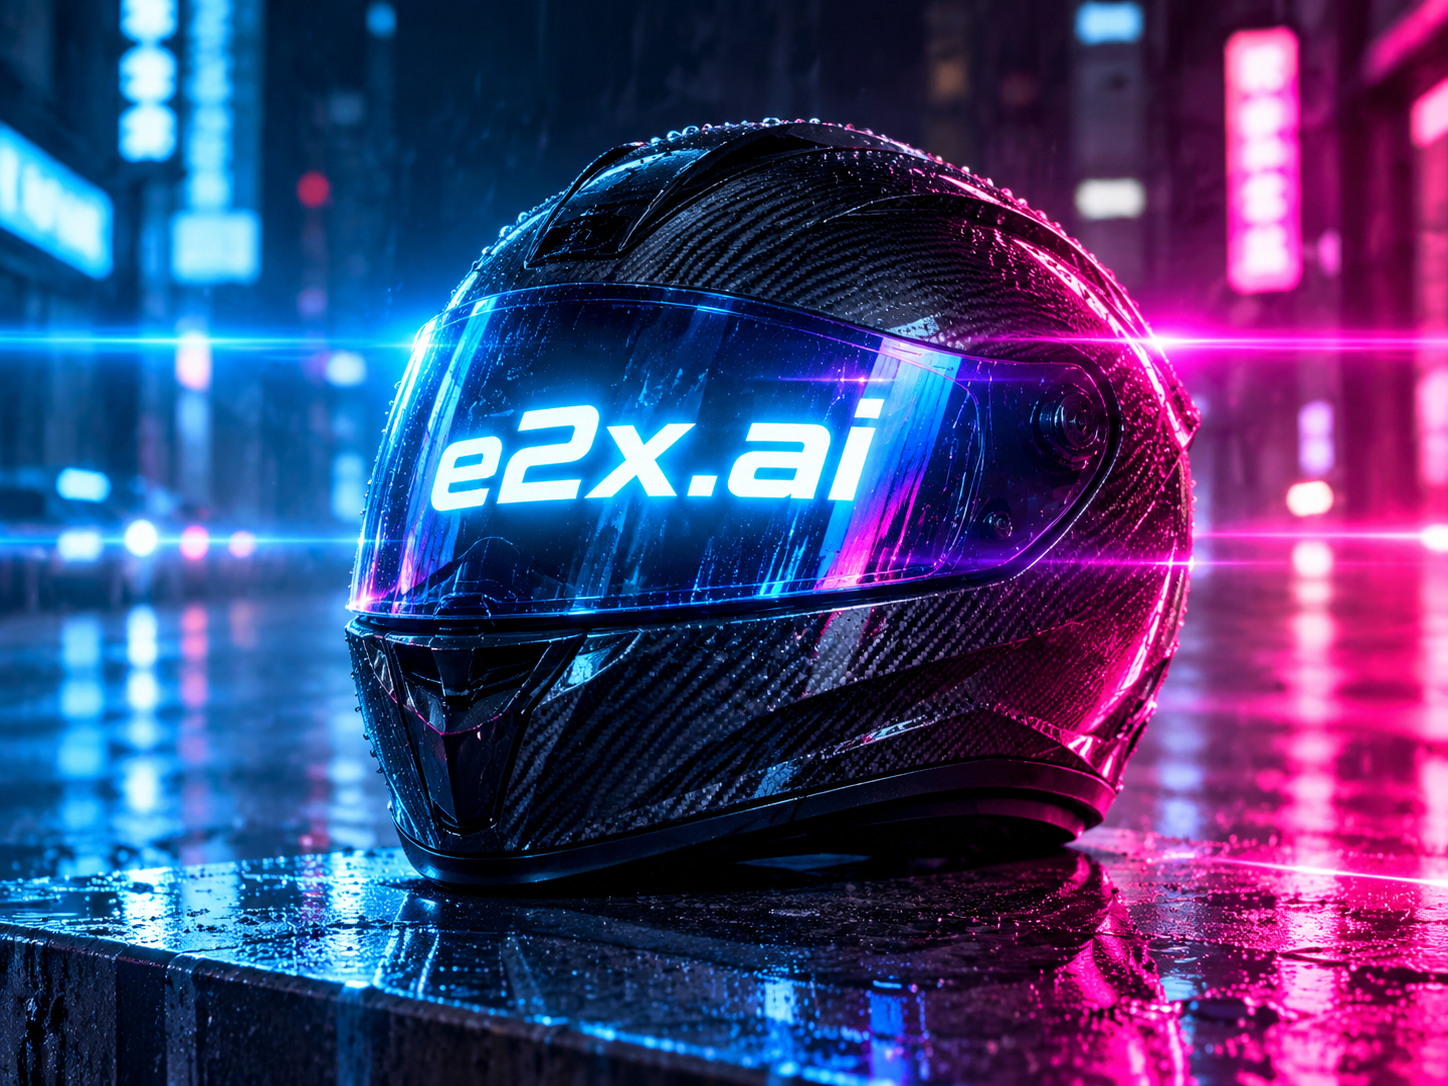
- Endpoint:
openai/gpt-image-2.6-flare/text-to-image (output_format: "png", aspect_ratio: "1:1", resolution: "1K", quality: "high")
- Prompt:
"An eye-catching editorial cyberpunk night photograph of a sleek futuristic matte-black carbon-fiber motorcycle helmet resting on a rain-slicked neon street podium in the center of the frame, with bold, crisp, ultra-legible glowing cyan-white LED typography reading \"e2x.ai\" illuminated across the curved iridescent visor. Dramatic electric blue and vibrant magenta anamorphic horizontal lens flares streak across the frame with neon bokeh reflections on the wet asphalt. Photorealistic 8K commercial shot."
- Formato de salida:
output_format: "svg" (aspect_ratio: "1:1", 1024×1024 XML <svg> escalable)
- Prompt:
"Clean geometric vector emblem badge for \"e2x.ai\" featuring a stylized radiant sunburst prism and orbital rings in vibrant gold, cyan, and deep obsidian navy, crisp flat vector paths"
Comparación lado a lado entre Sunburst Max y Flare High (aspect_ratio: "16:9")
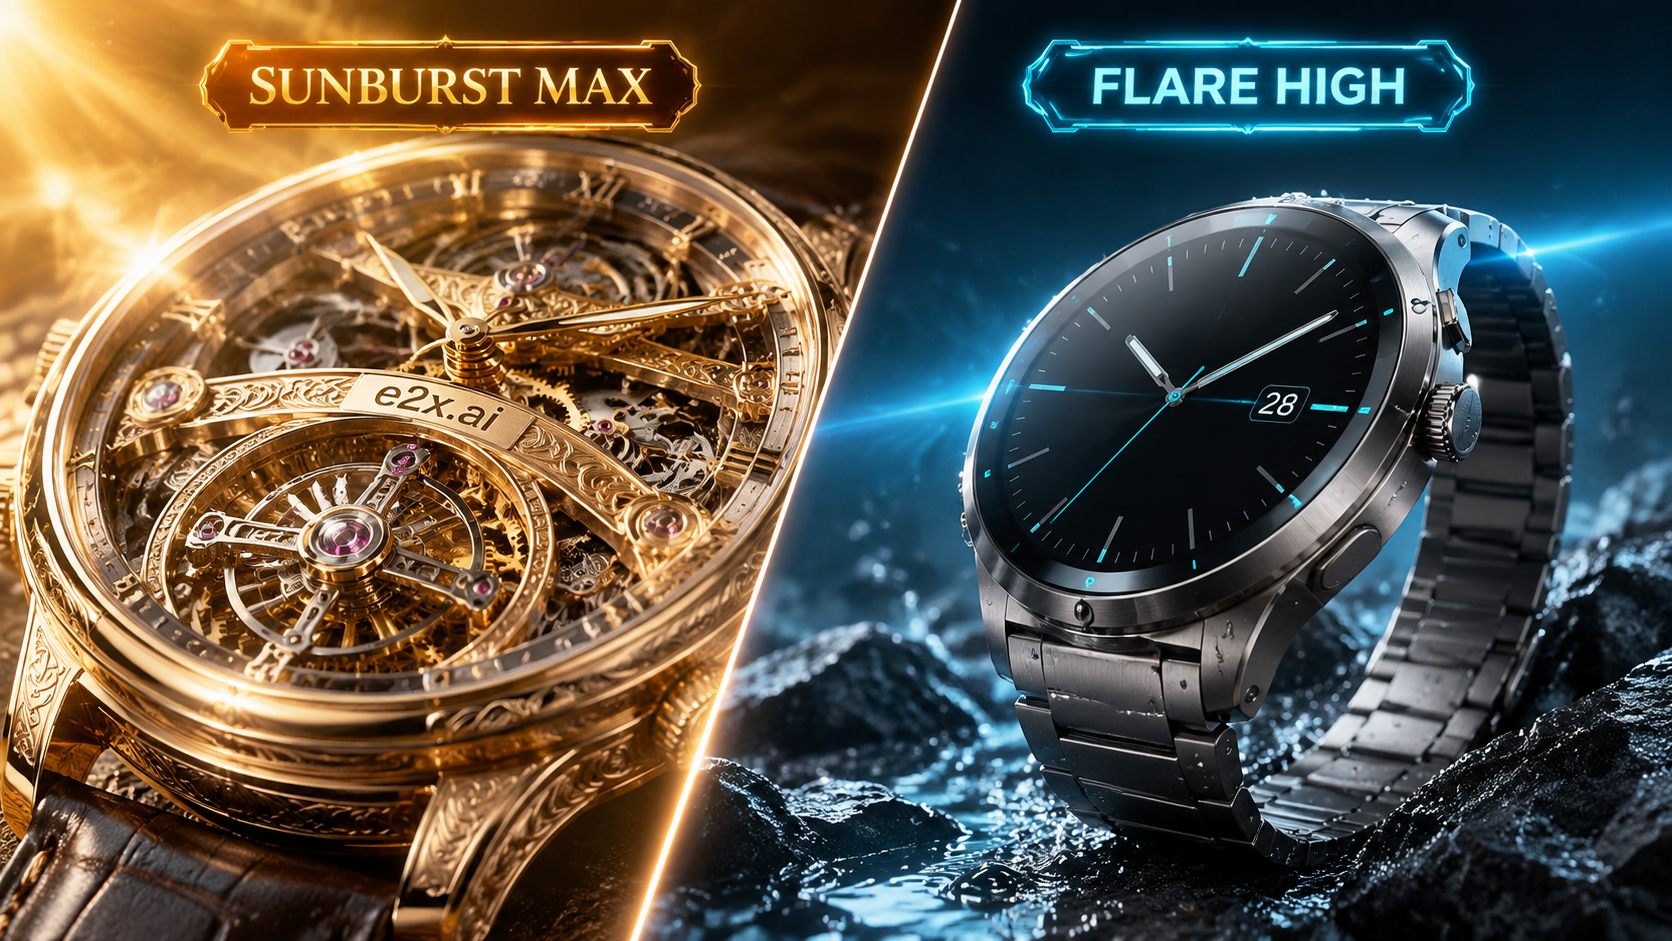
- Comparación visual (
16:9, 1672×941): Detalle macro de tourbillon calado en Sunburst Max frente a fotografía comercial de producto en titanio de alto contraste en Flare High.
- Prompt:
"Split-screen visual comparison in a luxury studio: on the left side under a warm golden badge reading \"SUNBURST MAX\", an ultra-intricate macro photograph of an open-worked tourbillon mechanical watch with engraved gold bridges reading \"e2x.ai\" and warm sunburst lighting; on the right side under a sleek cyan badge reading \"FLARE HIGH\", a high-contrast commercial product shot of a matte titanium smartwatch on wet dark basalt with electric cyan lens flare"
Cómo afectan los multiplicadores de resolución y calidad a tu factura
Cada llamada a openai/gpt-image-2.6-flare/text-to-image parte de una tarifa base de lista de $0.03 (30,000 microcentavos), reducida mediante nuestro descuento global permanente del 75 % a una base con descuento de $0.0075 (7,500 microcentavos), y luego se multiplica por dos factores del esquema:
- Multiplicador de
resolution: 1K (por defecto) es ×1, 2K es ×2 y 4K es ×3.
- Multiplicador de
quality: low, medium (por defecto) y high aplican todos un multiplicador ×7.
Dado que todos los valores de quality (low, medium, high) multiplican la base con descuento de $0.0075 por 7, resolution es el único parámetro que cambia el costo por imagen. Enviar quality: "low" cobra los mismos $0.0525 en 1K que high, por lo que debes elegir low únicamente cuando busques la menor latencia posible de vista previa (~6 s), y usar high por defecto para activos de producción sin cargo adicional.
Aquí tienes la tabla de tarifas verificada el 6 de noviembre de 2026 frente a las tarifas bajo demanda de fal.ai:
| Resolución | Multiplicador | Precio de lista E2X ($0.03 × 7) | Precio E2X (75 % dto.) | fal.ai (nivel alto) | Ahorro en E2X |
|---|
1K (por defecto) | ×1 × 7 | $0.21 | $0.0525 | $0.211 | 75 % menor |
2K | ×2 × 7 | $0.42 | $0.1050 | $0.222 | 53 % menor |
4K | ×3 × 7 | $0.63 | $0.1575 | $0.401 | 61 % menor |
Esa curva define cómo conviene estructurar un flujo iterativo. Mantén resolution en 1K ($0.0525) mientras pruebas la composición, la iluminación y el texto entre comillas en high. Diez iteraciones en 1K más un único render maestro en 4K ($0.1575) suman $0.6825 en total, frente a $1.7325 si ejecutaras las once llamadas en 4K.
Los precios y las condiciones de los productos pueden cambiar. Consulta los precios vigentes de cada proveedor antes de tomar una decisión de compra. Los precios de Google Batch o Flex no son directamente equivalentes a una solicitud de API estándar bajo demanda porque difieren las condiciones de programación, disponibilidad y procesamiento; por lo tanto, se excluyen de esta comparación. Esta es una comparación acotada, no una afirmación de que E2X sea la opción más barata del mundo en todas las configuraciones.
Qué cambió en GPT Image 2.6 Flare frente a Sunburst y 2.5
El precio es idéntico en GPT Image 2.6 Flare, GPT Image 2.6 Sunburst y GPT Image 2.5 Flare ($0.0525 en 1K, $0.105 en 2K, $0.1575 en 4K), por lo que la elección depende de cuatro mejoras arquitectónicas en la versión 2.6:
- Salida nativa de
.gif animado y .svg vectorial (output_format). Junto con png (por defecto), jpeg y webp, openai/gpt-image-2.6-flare/text-to-image acepta output_format: "gif" y output_format: "svg". Configurar "gif" genera animaciones en bucle multifotograma directamente desde un prompt de texto (los esquemas admiten de 2 a 16 fotogramas y de 20 a 2,000 ms de duración por fotograma, ajustando las dimensiones a múltiplos de 16). Configurar "svg" genera gráficos vectoriales XML <svg> limpios y escalables para iconos, insignias e ilustraciones de interfaz.
- Inferencia 2×–2.5× más rápida en 3 niveles de calidad (
low, medium, high). GPT Image 2.6 Flare se centra en la generación de alto rendimiento (~6 segundos en calidad low) en low, medium (por defecto) y high. Cuando necesites los niveles de calidad xhigh o max para cortes mecánicos complejos o pósteres densos de varios párrafos, cambia a GPT Image 2.6 Sunburst exactamente por el mismo precio de $0.0525 (1K).
- 15 relaciones de aspecto fijas y planificación espacial. GPT Image 2.6 Flare admite 15 relaciones de aspecto (
1:1, 1:2, 2:1, 1:3, 3:1, 2:3, 3:2, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 9:21, 21:9), con 1:1 por defecto, respaldadas por planificación espacial previa al dibujo (complexity: low, medium, high).
- Hasta 16 imágenes de referencia en
edit-image. La ruta complementaria GPT Image 2.6 Flare edit-image amplía image_urls de 10 a 16 imágenes de referencia con prompts de edición de 50,000 caracteres, inpainting con máscara (mask_image) y guía mediante marcas visuales (markup_image).
Todos los modelos en E2X utilizan la misma cola de trabajos asíncrona. Envía una carga JSON mediante POST a https://api.e2x.ai/v1/jobs/submit con tu token Bearer y consulta https://api.e2x.ai/v1/jobs/{jobId} hasta que el estado alcance completed, o pasa un webhookUrl en la solicitud de envío.
Solo prompt es obligatorio (hasta 32,000 caracteres). Aquí tienes un ejemplo con curl que genera una mascota en .gif animado a resolución 1K y calidad high ($0.0525):
curl -X POST https://api.e2x.ai/v1/jobs/submit \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.6-flare/text-to-image",
    "input": {
      "prompt": "A cute 3D isometric cyber-robot mascot character waving cheerfully beside a glowing cyan and gold neon badge reading \"e2x.ai\" in a sleek dark studio, smooth looping animation",
      "aspect_ratio": "1:1",
      "resolution": "1K",
      "quality": "high",
      "output_format": "gif"
    }
  }'
Para generación raster de alta resolución o vectorial .svg, configura output_format en "png", "webp" o "svg" y sube resolution a 2K ($0.105) o 4K ($0.1575) en tu código Node.js:
const headers = {
  Authorization: `Bearer ${process.env.E2X_API_KEY}`,
  "Content-Type": "application/json",
};

const submitRes = await fetch("https://api.e2x.ai/v1/jobs/submit", {
  method: "POST",
  headers,
  body: JSON.stringify({
    model: "openai/gpt-image-2.6-flare/text-to-image",
    input: {
      prompt: 'Editorial cyberpunk night photograph of a matte-black carbon-fiber motorcycle helmet on a neon street podium with glowing cyan-white LED typography reading "e2x.ai" across the visor, electric blue anamorphic lens flare.',
      aspect_ratio: "16:9",
      resolution: "2K",
      quality: "high",
      output_format: "png",
    },
  }),
});

const { data: submitted } = await submitRes.json();

for (let poll = 0; poll < 120; poll++) {
  await new Promise((r) => setTimeout(r, 3000));
  const statusRes = await fetch(
    `https://api.e2x.ai/v1/jobs/${submitted.jobId}`,
    { headers }
  );
  const { data: job } = await statusRes.json();

  if (job.status === "completed") {
    console.log("Generated asset URL:", job.outputs[0].url);
    break;
  }
  if (job.status === "failed" || job.status === "cancelled") {
    throw new Error(job.error?.message || `Job ended with status ${job.status}`);
  }
}
Dos detalles de implementación importantes: los valores de resolution deben ir en mayúsculas (1K, 2K, 4K) y las URL de salida devueltas en data.outputs deben copiarse a tu propio bucket de almacenamiento si planeas servirlas a largo plazo. El esquema completo está publicado en nuestra especificación del modelo legible por máquina, y las bibliotecas cliente oficiales se encuentran en la página de SDK de E2X.
Cómo elegir el modelo de texto a imagen adecuado en E2X
Elige entre nuestros endpoints de OpenAI y Google según si tu pipeline prioriza la velocidad, el detalle xhigh/max, la síntesis nativa .gif y .svg, los recortes PNG transparentes o los banners 4K económicos:
| Modelo | Precio 1K | Precio 4K | Resolución máx. | Formatos de salida | Mejor caso de uso |
|---|
| GPT Image 2.6 Flare | $0.0525 | $0.1575 | 4K | png, jpeg, webp, gif, svg | Generación de alta velocidad en 3 niveles (low, medium, high), GIF animados, SVG vectoriales, feeds de UI interactivos |
| GPT Image 2.6 Sunburst | $0.0525 | $0.1575 | 4K | png, jpeg, webp, gif, svg | Calidad insignia de 5 niveles (xhigh y max sin costo extra) para tipografía densa y detalle macro |
| GPT Image 2.5 Flare | $0.0525 | $0.1575 | 4K | png, jpeg, webp | Flujos heredados 2.5 que requieren aspect_ratio: "auto" |
| GPT Image 2 | $0.0525 | $0.1575 | 4K | png, jpeg, webp | Recortes PNG transparentes nativos (background: "transparent") al mismo precio |
| Nano Banana 2.1 | $0.0300 | $0.0900 | 4K | png, jpeg, webp | El precio 4K más bajo ($0.09) y relaciones extremas de banner 8:1 / 1:8 |
| Nano Banana 2 Lite | $0.0238 | — | 1K | png, jpeg, webp | Generación por lotes 1K de alto volumen por menos de 2.5 centavos |
Compara todas las capacidades lado a lado en la categoría de texto a imagen o explora el catálogo completo de modelos de E2X.
Límites y notas operativas
- Límites de tasa y concurrencia: El endpoint permite hasta 100 solicitudes por minuto, 5,000 solicitudes por hora, 50,000 solicitudes por día y 100 trabajos simultáneos por cuenta.
- Tiempo de procesamiento: Las vistas previas en 1K de nivel bajo pueden completarse en ~6 segundos, mientras que la calidad
high, la generación de .gif multifotograma y el escalado a 2K/4K promedian entre 15 y 60 segundos. Utiliza webhooks o un intervalo de sondeo de 3 segundos en producción.
- Límites de relación de aspecto: Las 15 proporciones admitidas van desde formatos horizontales
3:1 y 21:9 hasta formatos verticales 1:3 y 9:21 (1:1, 1:2, 2:1, 1:3, 3:1, 2:3, 3:2, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 9:21, 21:9). Si un diseño requiere encabezados tipo cinta 4:1 o 8:1, envía ese trabajo a Nano Banana 2.1.
- Metadatos de procedencia: Las salidas de la familia de imágenes de OpenAI incluyen metadatos de procedencia C2PA estándar y marcadores de atribución a nivel de píxel que las plataformas sociales leen para mostrar etiquetas de generación por IA.
Consejos de prompting para GPT Image 2.6 Flare
Con un límite de 32,000 caracteres, escribe oraciones declarativas directas ordenadas desde el sujeto principal hasta la iluminación y las indicaciones de formato:
- Sujeto y acabado de superficie primero: Nombra el objeto central, la textura de su material y el ángulo de cámara ("casco de motocicleta de fibra de carbono negro mate centrado sobre un podio callejero de neón mojado por la lluvia").
- Texto exacto entre comillas: Coloca el texto de insignias, letreros de tiendas o etiquetas de UI entre comillas dobles y solicita
quality: "high" para que las letras se rendericen limpiamente sin desviación de caracteres.
- Bucles de movimiento para
output_format: "gif": Especifica un objeto de anclaje estático más una acción cíclica continua ("saludando alegremente junto a una insignia de neón brillante, animación fluida en bucle") para obtener bucles GIF multifotograma limpios.
- Estructura vectorial para
output_format: "svg": Pide formas geométricas planas, contornos definidos y paletas de colores sólidos ("insignia de emblema vectorial geométrico limpio, trazados vectoriales planos y nítidos") al exportar archivos SVG escalables.
Para un análisis más detallado de cómo los modelos de OpenAI y Google interpretan la estructura del prompt, consulta nuestra guía de selección de generadores de imágenes y nuestra guía de pipelines de generación automatizada de imágenes.
Preguntas frecuentes
¿Cuánto cuesta el texto a imagen de GPT Image 2.6 Flare en E2X?
Con nuestro descuento del 75 %, GPT Image 2.6 Flare cuesta $0.0525 por imagen en resolution: "1K" (valor por defecto), $0.105 por imagen en resolution: "2K" y $0.1575 por imagen en resolution: "4K", sin importar si seleccionas calidad low, medium o high, o formato de salida png, jpeg, webp, gif o svg.
¿Cómo se calcula el precio de $0.0525 a partir de la tarifa base?
La tarifa base de lista es de $0.03 por solicitud, que nuestro descuento global del 75 % reduce a $0.0075. Cada ajuste de quality (low, medium, high) aplica un multiplicador ×7 ($0.0075 × 7 = $0.0525), y resolution multiplica el resultado (1K = ×1, 2K = ×2, 4K = ×3).
¿Cambiar la calidad de low o medium a high cuesta más?
No. Los tres niveles de calidad (low, medium, high) tienen el mismo multiplicador ×7 en E2X ($0.0525 en 1K). Solo resolution (1K, 2K, 4K) modifica el costo por imagen. Utiliza low cuando quieras borradores rápidos en ~6 segundos y utiliza high para los renders finales. Si necesitas los niveles de calidad xhigh o max, usa GPT Image 2.6 Sunburst exactamente con la misma tarifa.
¿Cómo genero GIF animados y SVG vectoriales con GPT Image 2.6 Flare?
Configura "output_format": "gif" en la carga de entrada para sintetizar un GIF animado multifotograma en bucle a partir de tu prompt de texto, o configura "output_format": "svg" para obtener gráficos de trazados vectoriales XML <svg> limpios. También se admiten los formatos raster estándar ("png", "jpeg", "webp").
¿En qué se diferencia GPT Image 2.6 Flare de GPT Image 2.6 Sunburst?
GPT Image 2.6 Flare está optimizado para velocidad y producción de alto volumen en tres niveles de calidad (low, medium, high), ejecutándose hasta 2×–2.5× más rápido que 2.5 Flare. GPT Image 2.6 Sunburst añade los niveles de calidad xhigh y max para un razonamiento espacial más profundo y microtipografía densa. Ambos modelos cuestan exactamente los mismos $0.0525 en 1K en E2X.
¿Qué relaciones de aspecto admite GPT Image 2.6 Flare?
Acepta 15 relaciones de aspecto fijas, con 1:1 por defecto cuando se omite: 1:1, 1:2, 2:1, 1:3, 3:1, 2:3, 3:2, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 9:21 y 21:9.
¿Cuál es la longitud máxima del prompt y el límite de imágenes de referencia?
El campo prompt acepta hasta 32,000 caracteres en openai/gpt-image-2.6-flare/text-to-image. Si necesitas hasta 50,000 caracteres junto con hasta 16 imágenes de referencia (image_urls), utiliza el endpoint complementario GPT Image 2.6 Flare edit-image.
 Imagen
 openaiNuevo