API OpenAI GPT Image 2.5 sur E2X : qualité xhigh et max jusqu'en 4K dès $0.0525
L'architecture GPT Image 2.5 d'OpenAI est disponible sur l'API E2X à travers deux familles de modèles spécialisées — GPT Image 2.5 Sunburst et GPT Image 2.5 Flare — proposant chacune des routes dédiées de génération et d'édition :
- GPT Image 2.5 Sunburst (
openai/gpt-image-2.5-sunburst/text-to-imageetopenai/gpt-image-2.5-sunburst/edit-image) : prend en charge les résolutions1K,2Ket4Kainsi que les cinq paliers de qualité :low,medium,high,xhighetmax. - GPT Image 2.5 Flare (
openai/gpt-image-2.5-flare/text-to-imageetopenai/gpt-image-2.5-flare/edit-image) : prend en charge les résolutions1K,2Ket4Kavec les trois paliers de qualité standards :low,mediumethigh.
Avec notre remise permanente de 75 %, les deux familles de modèles affichent une tarification identique : une requête 1K est facturée $0.0525, une requête 2K $0.105 et une requête 4K $0.1575.
Ces tarifs restent fixes quel que soit le réglage quality choisi dans le schéma. Sur E2X, les paliers de qualité xhigh et max de Sunburst partagent exactement le même multiplicateur ×7 que low, medium et high sur Sunburst et Flare. Vous pouvez exécuter chaque tâche en xhigh ou max sur Sunburst sans ajouter un seul centime à votre facture.
Ce guide couvre l'intégration complète : comment le tarif de base et les multiplicateurs déterminent votre facture, le schéma d'entrée complet pour les quatre endpoints Sunburst et Flare, du code curl et TypeScript prêt pour la production pour le polling et les webhooks, ainsi que les prompts exacts derrière les rendus d'exemple de cette page.
Comment le tarif de $0.0525 est calculé
Comprendre la formule de facturation sur E2X évite deux erreurs fréquentes : payer pour une résolution 4K alors que vous testez encore la formulation d'un prompt, et baisser quality pour économiser de l'argent alors que quality ne modifie pas le prix.
Les quatre routes — openai/gpt-image-2.5-sunburst/text-to-image, openai/gpt-image-2.5-sunburst/edit-image, openai/gpt-image-2.5-flare/text-to-image et openai/gpt-image-2.5-flare/edit-image — partagent toutes un tarif de base catalogue de $0.03 (30,000 micro-cents dans la réponse de l'API). E2X applique une remise permanente de 75 % sur cette base, ramenant l'unité de départ à $0.0075 (7,500 micro-cents). À partir de là, le moteur de facturation multiplie par deux facteurs liés aux paramètres :
- Le facteur
quality:low,mediumethigh(la valeur par défaut du schéma sur Flare et Sunburst), ainsi quexhighetmax(sur Sunburst), utilisent chacun un multiplicateur ×7. Multiplier$0.0075par7donne$0.0525. - Le facteur
resolution:1K(la valeur par défaut du schéma) applique ×1,2Kapplique ×2 et4Kapplique ×3.
Comme toutes les valeurs de quality correspondent au même facteur ×7 dans la grille tarifaire dynamique, resolution est le seul paramètre qui fait varier votre coût par image. Vous ne verrez jamais de facturation non multipliée à $0.0075 sur une tâche terminée, car quality prend par défaut la valeur high (×7) dès que vous l'omettez. Et puisque xhigh et max sur Sunburst partagent ce facteur ×7, descendre à low ou medium n'économise aucun dollar. Réglez quality sur high (sur Flare ou Sunburst) ou sur xhigh / max (sur Sunburst) selon la densité visuelle de votre prompt et laissez low de côté.
| Résolution | Formule du multiplicateur | Tarif catalogue E2X ($0.03 × 7) | Tarif E2X (-75 %) | Micro-cents API | fal.ai à la demande (palier high) | Économie E2X |
|---|---|---|---|---|---|---|
1K (par défaut) | $0.0075 × 7 × 1 | $0.21 | $0.0525 | 52500 | $0.211 | 75% |
2K | $0.0075 × 7 × 2 | $0.42 | $0.1050 | 105000 | $0.222 | 53% |
4K | $0.0075 × 7 × 3 | $0.63 | $0.1575 | 157500 | $0.401 | 61% |
Comparaison tarifaire vérifiée le 4 novembre 2026 par rapport aux tarifs à la demande de fal.ai. Les tarifs et conditions des fournisseurs peuvent évoluer ; consultez notre page de tarification pour les chiffres en direct.
Pour les équipes qui travaillent par boucles de conception itératives, cette courbe de multiplicateurs simplifie la gestion du budget. Gardez resolution fixé sur "1K" pendant que vous affinez l'éclairage, l'angle de caméra et le texte intégré en "xhigh" ou "max" sur Sunburst. Huit générations de brouillons en 1K reviennent à $0.42 au total. Une fois la mise en page validée, lancez un seul rendu maître en "4K" pour $0.1575. L'ensemble de la séquence de neuf images revient à $0.5775, contre $1.4175 si chaque brouillon avait tourné en 4K.
Notez la cinquième colonne du tableau ci-dessus. Chaque champ monétaire renvoyé par l'API E2X est un entier exprimé en micro-cents, où 1,000,000 micro-cents équivalent à $1.00 USD. Une génération 1K renvoie 52500, une génération 2K renvoie 105000 et une génération 4K renvoie 157500. Stockez directement ces entiers dans votre table comptable et ne divisez par 1,000,000 qu'au moment de formater les chiffres pour un tableau de bord destiné aux utilisateurs.
Schéma complet des paramètres pour les endpoints Sunburst et Flare
Les routes GPT Image 2.5 Sunburst et Flare utilisent toutes l'enveloppe de tâche standard d'E2X via POST https://api.e2x.ai/v1/jobs/submit. Vous passez l'identifiant du modèle à la racine du corps JSON et placez tous les contrôles propres au modèle dans l'objet input.
| Paramètre | Disponibilité endpoint | Type | Requis | Défaut | Valeurs acceptées / limites |
|---|---|---|---|---|---|
prompt | Tous les endpoints | string | Oui | Aucun | Jusqu'à 32,000 caractères sur text-to-image ; jusqu'à 50,000 caractères sur edit-image. |
image_urls | edit-image uniquement | string[] | Oui (en édition) | Aucun | URL HTTPS publiquement accessibles pour le conditionnement par référence, le compositing ou l'édition. |
aspect_ratio | Tous les endpoints | string | Non | "1:1" | "auto", "1:1", "4:3", "3:4", "3:2", "2:3", "5:4", "4:5", "16:9", "9:16", "2:1", "1:2", "21:9", "9:21", "3:1", "1:3" (16 au total). |
resolution | Tous les endpoints | string | Non | "1K" | "1K", "2K", "4K" (doit être en majuscules). |
quality | Sunburst vs Flare | string | Non | "high" | Sunburst : "low", "medium", "high", "xhigh", "max". Flare : "low", "medium", "high". |
Trois détails du schéma méritent votre attention avant d'écrire votre couche de validation :
- Les chaînes
resolutionen majuscules sont obligatoires sur les modèles OpenAI. Passez"1K","2K"ou"4K". Si votre base de code appelle déjà des modèles Google de notre catalogue text-to-image où les résolutions sont en minuscules ("1k","2k","4k"), normalisez la casse selon le slug du modèle plutôt que de partager une constante unique. aspect_ratiovaut"1:1"par défaut et prend en charge"auto". Lorsque vous omettezaspect_ratio, GPT Image 2.5 génère un cadre carré. Lorsque vous passez explicitement"auto", le modèle sélectionne l'un des formats supportés en fonction du sujet décrit dans votre prompt (ou conserve le cadrage de votre image de référence principale suredit-image).- GPT Image 2.5 omet le paramètre
background. Ni les endpointsopenai/gpt-image-2.5-sunburst/*niopenai/gpt-image-2.5-flare/*n'incluent le champbackground("transparent","opaque","auto"). Si votre workflow nécessite un détourage PNG transparent avec canal alpha en un seul appel, orientez cette requête versopenai/gpt-image-2/text-to-imageouopenai/gpt-image-2/edit-imagepour le même tarif de$0.0525. Nous détaillons cette décision de routage dans notre comparatif GPT Image 2.5 vs GPT Image 2.
Générer votre première image avec curl
Comme les tâches GPT Image 2.5 prennent en moyenne environ 60 secondes, l'API E2X est asynchrone. Votre requête POST valide la charge utile, place le travail en file d'attente et renvoie immédiatement un jobId.
Voici une requête curl complète appelant openai/gpt-image-2.5-sunburst/text-to-image en résolution "1K" et qualité "xhigh" ($0.0525) :
curl -X POST https://api.e2x.ai/v1/jobs/submit \
  -H "Authorization: Bearer $E2X_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.5-sunburst/text-to-image",
    "input": {
      "prompt": "Overhead editorial photograph of an anodized aluminum mechanical keyboard on a dark walnut desk. Keycaps in matte charcoal with a single signal orange Esc key. Soft north-window daylight from the top left, crisp key legends.",
      "aspect_ratio": "3:2",
      "resolution": "1K",
      "quality": "xhigh"
    }
  }'
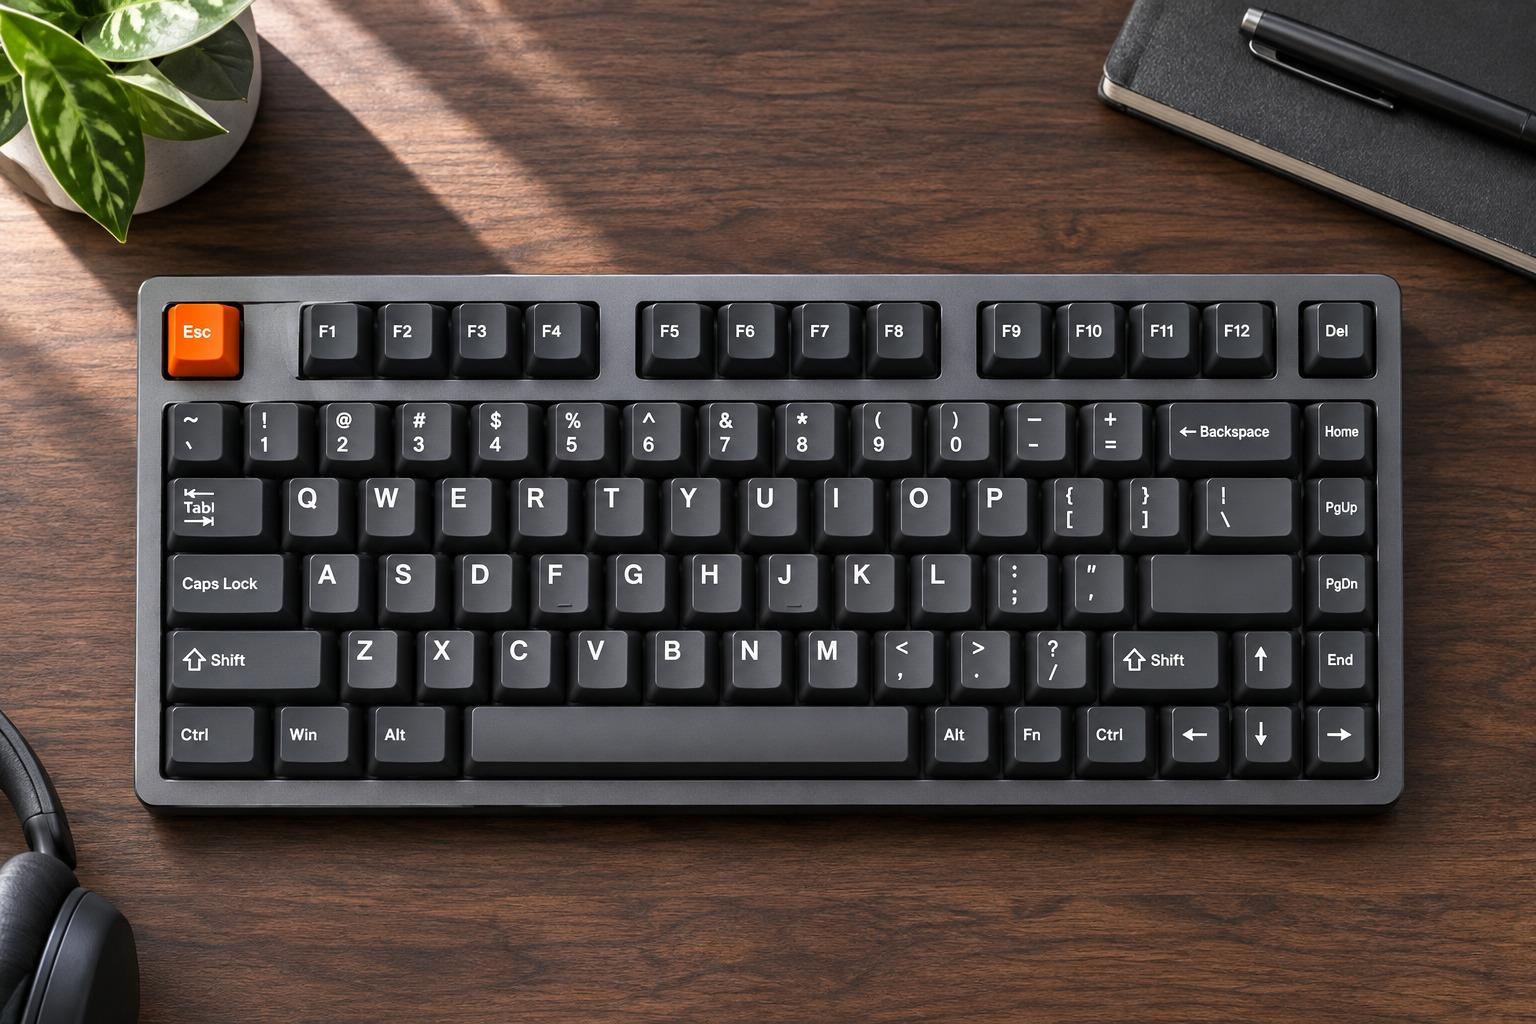
Prompt utilisé pour l'image ci-dessus :
"Overhead editorial photograph of an anodized aluminum mechanical keyboard on a dark walnut desk. Keycaps in matte charcoal with a single signal orange Esc key. Soft north-window daylight from the top left, crisp key legends."
Pourquoi ce prompt fonctionne particulièrement bien en qualité "xhigh" : les claviers mécaniques constituent un test de résistance classique pour les générateurs d'images, car un espacement irrégulier des touches, des rangées déformées ou des légendes bavantes gâchent immédiatement le cliché. Spécifier un angle de prise de vue plongeant, nommer précisément le matériau du boîtier (anodized aluminum), isoler une seule touche de couleur (single signal orange Esc key) et demander la qualité "xhigh" donne au modèle un budget d'échantillonnage suffisant pour garder la grille bien droite et les inscriptions sur les touches parfaitement nettes.
Lorsque l'appel de soumission réussit, l'API répond avec un code 200 OK et une enveloppe JSON contenant l'identifiant de votre tâche :
{
  "success": true,
  "data": {
    "jobId": "job_01J9X7K3M8P2Q4R6S8T0V2W4Y6",
    "status": "pending"
  }
}
Pour vérifier le statut depuis votre terminal, appelez GET https://api.e2x.ai/v1/jobs/{jobId} avec le même en-tête Authorization :
curl -s https://api.e2x.ai/v1/jobs/job_01J9X7K3M8P2Q4R6S8T0V2W4Y6 \
  -H "Authorization: Bearer $E2X_API_KEY"
Lorsque data.status passe de pending à processing puis enfin à completed, l'URL de l'image finale se trouve dans data.outputs[0].url.
Typographie et mise en page d'affiche en qualité max
L'une des meilleures raisons de passer de high à xhigh ou max sur GPT Image 2.5 Sunburst est le rendu du texte au sein de mises en page graphiques structurées. Les affiches, couvertures de livres, patrons d'emballage et cartes d'interface utilisateur exigent un alignement strict sur la ligne de base et des formes de lettres nettes.
Voici la configuration de prompt et de paramètres utilisée pour générer une affiche d'exposition suisse au format 2:3 en résolution "2K" et qualité "max" ($0.105) :
'Minimalist museum poster on textured cotton paper. Centered Swiss grid typography reading "ZURICH DESIGN WERKSCHAU 2026" in bold black grotesque type above a cobalt blue geometric arch.'
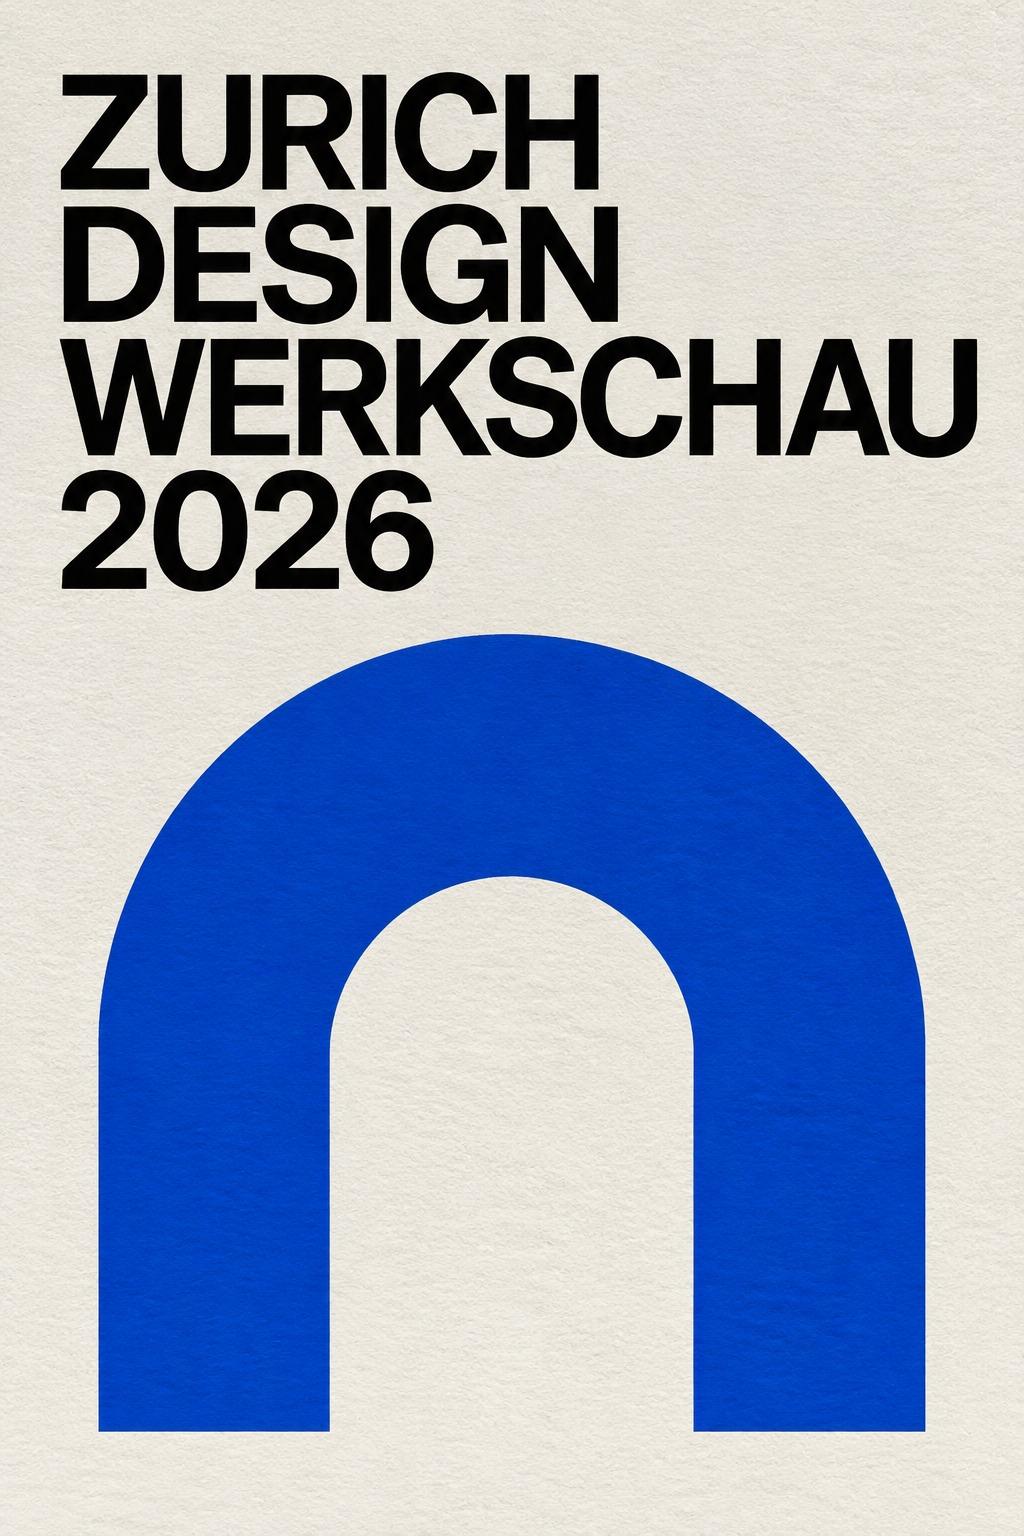
Trois règles pratiques rendent le lettrage intégré aux images fiable sur GPT Image 2.5 :
- Mettez la chaîne exacte à afficher entre guillemets. Tout ce qui se trouve entre les guillemets est traité comme du texte littéral à rendre sur le canevas, tandis que les mots environnants décrivent la police (
bold black grotesque type), le support (textured cotton paper) et le placement (Centered Swiss grid typography). - Utilisez
xhighoumaxsur Sunburst dès que le lettrage est le point focal. Comme E2X facturemaxau même multiplicateur ×7 quehigh, demander"quality": "max"offre le crénage le plus précis et les contours les plus propres sans augmenter votre coût. - Choisissez le format d'image final dès le départ. Une affiche se conçoit en
"2:3"ou"3:4". Générer en"1:1"pour recadrer ensuite coupe les marges dont dépend l'équilibre de la grille.
Intégration TypeScript en production : polling et stockage
Dans un backend Node.js ou TypeScript, votre intégration doit accomplir trois opérations proprement : soumettre la tâche, interroger le statut à une cadence raisonnable (environ 3 secondes correspondent à l'intervalle de nos workers) et copier le fichier final depuis l'URL de livraison temporaire d'E2X vers votre propre bucket S3, R2 ou GCS.
Ne sautez pas l'étape de téléchargement. L'URL renvoyée dans data.outputs[0].url est un lien de livraison à courte durée de vie. Stocker cette chaîne directement dans la base de données de votre application entraînera des images brisées dès l'expiration de l'objet de livraison.
import { writeFile, mkdir } from "node:fs/promises";
import path from "node:path";

const E2X_BASE_URL = "https://api.e2x.ai/v1";
const API_KEY = process.env.E2X_API_KEY;

if (!API_KEY) {
  throw new Error("Missing E2X_API_KEY environment variable");
}

type GptImageResolution = "1K" | "2K" | "4K";
type GptImageQuality = "low" | "medium" | "high" | "xhigh" | "max";

interface SubmitTextToImageInput {
  prompt: string;
  aspect_ratio?: string;
  resolution?: GptImageResolution;
  quality?: GptImageQuality;
  webhookUrl?: string;
}

const headers = {
  Authorization: `Bearer ${API_KEY}`,
  "Content-Type": "application/json",
};

export async function submitGptImage25(
  options: SubmitTextToImageInput
): Promise<string> {
  const { webhookUrl, ...input } = options;

  const response = await fetch(`${E2X_BASE_URL}/jobs/submit`, {
    method: "POST",
    headers,
    body: JSON.stringify({
      model: "openai/gpt-image-2.5-sunburst/text-to-image",
      input: {
        prompt: input.prompt,
        aspect_ratio: input.aspect_ratio ?? "2:3",
        resolution: input.resolution ?? "2K",
        quality: input.quality ?? "max",
      },
      ...(webhookUrl ? { webhookUrl } : {}),
    }),
  });

  if (!response.ok) {
    throw new Error(`Submit failed (${response.status}): ${await response.text()}`);
  }

  const payload = (await response.json()) as { data: { jobId: string } };
  return payload.data.jobId;
}

export async function pollUntilComplete(
  jobId: string,
  timeoutMs = 300_000
): Promise<string> {
  const deadline = Date.now() + timeoutMs;
  let delayMs = 3000;

  while (Date.now() < deadline) {
    await new Promise((resolve) => setTimeout(resolve, delayMs));

    const response = await fetch(`${E2X_BASE_URL}/jobs/${jobId}`, { headers });
    if (!response.ok) {
      throw new Error(`Status check failed with HTTP ${response.status}`);
    }

    const { data } = (await response.json()) as {
      data: {
        status: string;
        outputs?: Array<{ url: string }>;
        error?: { message?: string };
      };
    };

    if (data.status === "completed" && data.outputs?.[0]?.url) {
      return data.outputs[0].url;
    }
    if (data.status === "failed" || data.status === "cancelled") {
      throw new Error(data.error?.message ?? `Job ended in ${data.status}`);
    }

    delayMs = Math.min(Math.round(delayMs * 1.25), 8000);
  }

  throw new Error(`Timed out waiting for job ${jobId}`);
}

async function saveImage(url: string, destination: string): Promise<void> {
  const res = await fetch(url);
  if (!res.ok) throw new Error(`Download failed: HTTP ${res.status}`);
  await mkdir(path.dirname(destination), { recursive: true });
  await writeFile(destination, Buffer.from(await res.arrayBuffer()));
}
Si vous préférez utiliser un client prêt à l'emploi plutôt que d'écrire vos propres wrappers fetch, consultez la page des SDK E2X pour découvrir les paquets officiels et des exemples de configuration.
Passer aux webhooks pour les traitements par lots
Tous les endpoints GPT Image 2.5 prennent en charge une limite de simultanéité de 100 tâches actives par compte, ainsi que des plafonds de débit de 100 appels par minute, 5 000 appels par heure et 50 000 appels par jour. Lorsque vous exécutez près de 100 tâches en parallèle, maintenir 100 boucles de polling ouvertes en mémoire mobilise vos processus workers et fragilise les déploiements.
Passer webhookUrl à la racine du corps de /v1/jobs/submit élimine la boucle de polling. Dès que la tâche atteint l'état completed, failed ou cancelled, E2X envoie une notification HTTP POST à votre serveur :
curl -X POST https://api.e2x.ai/v1/jobs/submit \
  -H "Authorization: Bearer $E2X_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.5-sunburst/text-to-image",
    "input": {
      "prompt": "Overhead editorial photograph of an anodized aluminum mechanical keyboard on a dark walnut desk. Keycaps in matte charcoal with a single signal orange Esc key. Soft north-window daylight from the top left, crisp key legends.",
      "aspect_ratio": "3:2",
      "resolution": "1K",
      "quality": "xhigh"
    },
    "webhookUrl": "https://api.yourcompany.com/webhooks/e2x-image"
  }'
Dans votre gestionnaire de webhook, enregistrez le jobId entrant, vérifiez l'état en appelant GET /v1/jobs/{jobId} avec votre clé API, téléchargez l'image depuis data.outputs[0].url vers votre stockage objet permanent, puis marquez la ligne correspondante en base de données comme terminée.
Édition et compositing avec openai/gpt-image-2.5-sunburst/edit-image
Lorsque vous disposez déjà d'une photo de produit, d'une maquette d'emballage ou d'un rendu architectural et que vous devez modifier des zones précises ou combiner plusieurs références, passez le slug du modèle sur openai/gpt-image-2.5-sunburst/edit-image (ou openai/gpt-image-2.5-flare/edit-image pour les paliers low, medium et high).
La tarification est identique à celle de text-to-image (1K à $0.0525, 2K à $0.105, 4K à $0.1575), et deux règles du schéma changent :
image_urlsest obligatoire. Passez un tableau d'une ou plusieurs URL HTTPS publiquement accessibles pointant vers vos images sources.- Le plafond de
promptpasse à 50 000 caractères. Cet espace supplémentaire (contre 32 000 surtext-to-image) permet aux pipelines de catalogue automatisés de transmettre des transcriptions OCR complètes, des contraintes strictes de couleurs de marque et des règles de placement par image de référence sans rencontrer d'erreur de longueur.
Voici une requête curl qui transmet deux images sources dans image_urls et les assemble en résolution "1K" et qualité "max" ($0.0525) :
curl -X POST https://api.e2x.ai/v1/jobs/submit \
  -H "Authorization: Bearer $E2X_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.5-sunburst/edit-image",
    "input": {
      "prompt": "Place the brushed titanium chronograph watch from image 1 onto the wet dark slate surface from image 2. Preserve the exact dial markings, hands, and bezel knurling from image 1, and match the cool cyan rim reflections from image 2.",
      "image_urls": [
        "https://your-cdn.example.com/catalog/chronograph-cutout.png",
        "https://your-cdn.example.com/backdrops/wet-slate-studio.jpg"
      ],
      "aspect_ratio": "1:1",
      "resolution": "1K",
      "quality": "max"
    }
  }'
Lorsque vous rédigez des prompts pour edit-image, indiquez explicitement ce qui doit changer et ce qui doit rester verrouillé, et désignez vos entrées par leur position (indexée à partir de 1) dans image_urls (image 1, image 2). Nous abordons en détail l'indexation multi-images, le remplacement d'étiquettes d'emballage et les modèles de prompts de 50K caractères dans notre guide d'édition multi-images avec GPT Image 2.5.
Comment GPT Image 2.5 s'intègre dans le catalogue de modèles E2X
Vous pouvez parcourir tous les modèles d'image que nous hébergeons dans le catalogue de modèles E2X ou filtrer spécifiquement par la catégorie text-to-image et la catégorie image-to-image. Comme chaque modèle sur E2X partage le même contrat /v1/jobs/submit, passer d'un modèle OpenAI à un modèle Google nécessite uniquement de modifier la chaîne model et d'adapter la casse de resolution.
- Choisissez GPT Image 2.5 Sunburst (
1Kà$0.0525,4Kà$0.1575) lorsque vous recherchez le respect des prompts et le rendu typographique d'OpenAI associés aux paliers de qualitéxhighoumaxet àaspect_ratio: "auto". - Choisissez GPT Image 2.5 Flare (
1Kà$0.0525,4Kà$0.1575) lorsque votre flux utilise les paliers standardslow,mediumouhighen1K,2Kou4K. - Choisissez GPT Image 2 (
1Kà$0.0525,4Kà$0.1575) lorsque votre pipeline nécessite des détourages PNG natifs avec canal alpha viabackground: "transparent". - Choisissez Google Nano Banana 2.1 (
1Kà$0.03,2Kà$0.04,4Kà$0.09) lorsque vous avez besoin du tarif de génération 4K le plus bas sur E2X ou de formats panoramiques extrêmes comme8:1et1:8. - Choisissez Google Nano Banana Pro (
1K/2Kà$0.075,4Kà$0.15) lorsque vous avez besoin d'une cohérence de personnage multi-références séparée par rôle.
Questions fréquentes
Pourquoi xhigh et max coûtent-ils le même prix que low et high sur E2X ?
Dans le schéma tarifaire d'E2X pour openai/gpt-image-2.5-sunburst/text-to-image et openai/gpt-image-2.5-sunburst/edit-image (ainsi que pour les routes flare), toutes les valeurs de quality (low, medium, high, xhigh, max) sont associées au même multiplicateur ×7 appliqué au coût de base remisé de $0.0075. Vous obtenez ainsi $0.0525 (1K), $0.105 (2K) et $0.1575 (4K) quel que soit le niveau de qualité choisi.
Quelle est la différence entre les endpoints Sunburst et Flare ainsi qu'entre text-to-image et edit-image ?
Sunburst (openai/gpt-image-2.5-sunburst/*) prend en charge les cinq paliers de qualité (low, medium, high, xhigh, max), tandis que Flare (openai/gpt-image-2.5-flare/*) prend en charge les trois paliers standards (low, medium, high). Sur les deux familles, text-to-image génère de nouvelles images à partir d'un simple prompt textuel (limite de 32 000 caractères), et edit-image requiert à la fois prompt (limite de 50 000 caractères) et image_urls (URL des images sources) pour modifier, restyler ou assembler des visuels existants. Tous les endpoints partagent exactement la même tarification et les mêmes limites de débit.