Continuità tra inquadrature su Gemini Omni 1.1 Flash: quale endpoint corregge quale deriva
Google ha pubblicato due frasi su questo modello nello stesso lancio, e puntano in direzioni opposte.
La prima sta nell'annuncio: quando Omni prosegue una clip, ora legge "fino a 10 secondi di contesto precedente — un salto rispetto ai modelli precedenti, che facevano riferimento solo all'ultimo secondo." Dieci volte la memoria. La seconda sta nella scheda modello di DeepMind, tra i limiti: "mantenere una coerenza completa lungo le modifiche, generare scene con movimento complesso o rendere testo perfettamente accurato resta una sfida."
Sono vere entrambe, e insieme descrivono il lavoro. Qui la continuità non è un interruttore da attivare ma un insieme di scelte fatte all'ingresso: quale endpoint chiama, cosa fissa con un'immagine, quali frasi ripete parola per parola. Il costo di una sequenza in quattro parti è un discorso a parte che non rifaremo.
Quattro endpoint, quattro cose diverse tenute ferme
Su E2X gemini-omni-1.1-flash arriva come quattro capability a un solo prezzo: $0.18 al secondo a 4K, qualunque sia quella che chiama. Questo cambia il modo di pensarle: sceglierne una non è mai una decisione di budget, solo di mestiere.
Cosa fissa ciascuna:
| Capability | Cosa tiene ferma | Cosa non terrà |
|---|---|---|
| text-to-video | Nulla se non le Sue parole | Tutto ciò che non ha scritto |
| image-to-video | Il fotogramma d'apertura, esattamente | Tutto ciò che viene dopo circa il primo secondo |
| start-end-frame-to-video | Entrambe le estremità dell'inquadratura | Il percorso tra le due |
| reference-to-video | Identità e aspetto del soggetto | Inquadratura, messa in scena, posizione di camera |
Lo legga come una diagnosi e non come un elenco di funzionalità: nomini la deriva che sta vedendo, poi scelga l'endpoint che la affronta.
L'inquadratura comincia male. Il Suo secondo angolo apre su una stanza diversa, oppure il personaggio entra già a metà di un gesto. Le dia un fotogramma: image-to-video prende un fermo immagine e parte da lì, quindi l'inquadratura due può aprire su un frame estratto dall'ultimo fotogramma dell'inquadratura uno, o su un render fisso che aveva già approvato. È la correzione di continuità più economica che il modello offra.
L'inquadratura finisce male. Il movimento è giusto e l'atterraggio no: la mano va verso la porta e la porta è altrove. Per questo c'è start-end-frame-to-video. Fornisce start_frame_url e end_frame_url, il modello riempie l'intervallo, e il fotogramma che il Suo stacco successivo deve raccordare è uno che ha scelto Lei invece di uno che Le è stato consegnato.
La persona cambia. Non l'inquadratura, non la messa in scena: il volto, i capelli, la giacca. Per questo c'è reference-to-video, l'unica delle quattro il cui scopo è l'identità. Il nostro array image_urls accetta da un minimo di una a un massimo di sette immagini; Runware documenta lo stesso tetto — "fino a 7 immagini" — mentre il riferimento di Google non dichiara alcun numero, anche se il suo esempio lavorato usa sei tag. Tratti il sette come consenso di terze parti, non come garanzia pubblicata.
I riferimenti video sono limitati più duramente, e quei numeri Google li pubblica: "i riferimenti video supportano un massimo di 3 clip, fino a 3 secondi ciascuna", accanto a "il riferimento o il ragionamento attraverso più video non è supportato" — tre è un tetto a cui ci si avvicina, non un obiettivo da riempire. Su cosa debba stare in un'immagine di riferimento la documentazione di Runware è più precisa di quella di Google, e raccomanda un ritratto a mezza figura pulito — inquadratura fino alla vita, sfondo neutro, dettagli identificativi visibili — perché "figure intere, sfondi affollati o angolazioni estreme diluiscono la lettura del personaggio da parte del modello."
Cosa fissa il seed, e cosa no
Su questo endpoint non c'è alcun sampler. La documentazione di Google è netta: "istruzioni di sistema, temperature, top_p, sequenze di stop e prompt negativi non sono supportati." Nessuna superficie di campionamento significa un solo controllo di riproducibilità, ed è seed, un intero opzionale che tutti e quattro i nostri schemi di capability accettano.
Vale la pena sapere da dove viene quel campo, perché nel riferimento di Google non c'è affatto. La documentazione 1.1 di Runware porta un seed e descrive la restituzione del "seed generato casualmente" quando non se ne fornisce uno; noi esponiamo il campo su ogni capability; Google, sulla pagina che si controllerebbe per prima, non dice nulla. Lo usi, ma non lo tratti come un contratto.
La parte che frega: il seed fissa il campione, non il soggetto. Stesso seed e prompt identico byte per byte è una ripetizione. Stesso seed e una parola modificata è una nuova estrazione: campionamento da capo, non un aggiustamento. È l'opposto di una manopola di temperatura, e significa che l'abitudine presa dai modelli di immagine — tenere il seed mentre si mette a punto il prompt — non si trasferisce.
Il che lascia il seed utile per esattamente due cose in un lavoro a più inquadrature, e inutile per una terza:
- Ri-renderizzare un keeper a un tier superiore. Fa le bozze, trova la presa, poi lancia lo stesso prompt e lo stesso seed alla Sua risoluzione di consegna. Non è cambiato nulla, quindi non si ricampiona nulla.
- Isolare una variabile. Cambi la frase sull'illuminazione, tenga il seed, e ciò che si muove è attribuibile a quella frase. Non è un esperimento controllato, ma è più rapido del ricampionare alla cieca.
- Portare un volto tra due inquadrature diverse. Non lo farà. Due prompt sono due prompt; il seed non si ricorda del Suo personaggio. L'identità tra inquadrature viene dalle immagini di riferimento, non da un intero.
Annoti il seed accanto al prompt nel momento in cui una presa funziona. Non esiste alcuna cronologia da cui recuperarlo dopo.
Blocchi di lock: lo stesso paragrafo, ripetuto alla lettera
Poiché una chiamata text-to-video non ha memoria della Sua chiamata precedente, l'istruzione di continuità più diffusa in circolazione non è rivolta a nessuno: "Keep everything consistent with the previous shot" indica un'inquadratura che il modello non ha mai visto.
La soluzione non ha nulla di affascinante. Scriva un blocco di fatti su aspetto e ambiente e lo incolli in ogni prompt della sequenza, invariato: non parafrasato, non stretto, non riordinato. Una nuova descrizione è una nuova estrazione.
Ecco due versioni della stessa seconda inquadratura in una sequenza di due. Prima quella che deriva:
Continuing the same scene, a tighter shot of the same man at his
workbench in the garage. Cinematic lighting, moody atmosphere,
highly detailed, professional colour grading. He lifts the machined
part into the light and turns it slowly while his colleague watches
from the right. Keep the characters and the location consistent
with the previous shot. Single continuous shot, no scene cuts.
Sound design: workshop room tone and quiet handling noise.
Conti cosa quel prompt lascia non fissato e ottiene l'elenco delle cose libere di cambiare: il verde esatto della giacca, se il polsino è sfilacciato, se c'è affatto una bandana, cosa pende dal pannello forato, da dove arriva la luce. Niente di tutto ciò è scritto, quindi niente di tutto ciò Le è dovuto: un'inquadratura ben fatta di un altro pomeriggio è una risposta corretta a quanto è stato chiesto.
La riscrittura tiene l'azione e spende le sue parole in fatti anziché in aggettivi:
In a single continuous shot, no scene cuts. Medium two-shot in a
cluttered garage workshop, 40mm lens at f/4, both subjects sharp.

[Lock - repeat verbatim in every shot of this sequence]
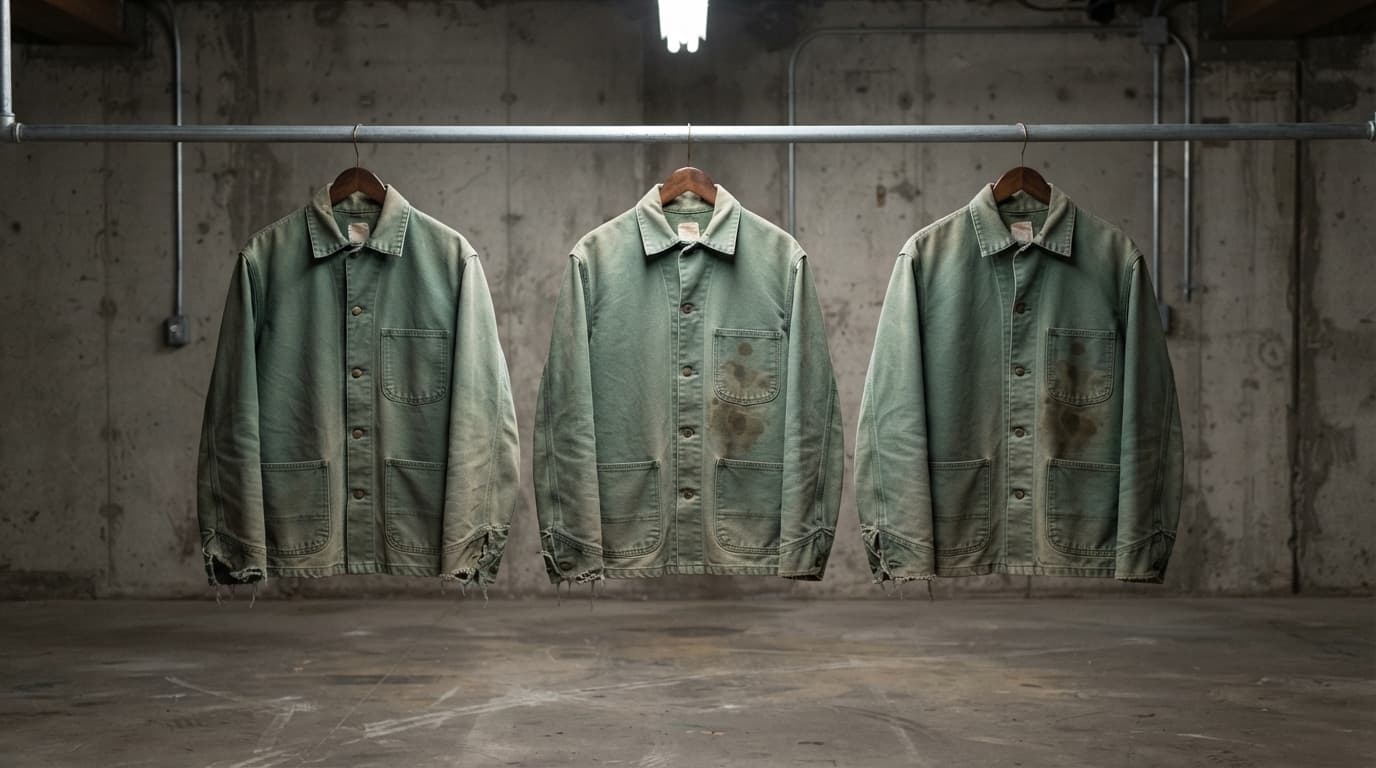
Man: mid-forties, close-cropped grey hair parted on his left, faded
green canvas work jacket, frayed left cuff, oil stain on the right
pocket, steel watch on his left wrist. Woman: thirties, dark hair
tied back, grey knit sweater, red bandana at her neck, clipboard in
her right hand. Set: steel workbench, pegboard behind with three
wrenches hanging left of centre, one overhead fluorescent tube,
cold white key from above, no window light.

Action: he lifts a machined aluminium part into the light and turns
it once; she does not move. Sound design: fluorescent hum, the part
clicking down onto steel. No dialogue.
L'etichetta tra parentesi quadre è per Lei, non per il modello: segna la regione da copiare. Quello che si guadagna un posto nel blocco è tutto ciò che è asimmetrico o danneggiato: da che lato è la riga dei capelli, quale polsino è sfilacciato, quale polso porta l'orologio, quale mano tiene la cartellina. La simmetria è dove si nasconde la deriva, perché un dettaglio simmetrico specchiato sembra corretto da solo e sbagliato in uno stacco. I nomi dei colori ci appartengono, e così la luce: direzione, durezza, e l'assenza esplicita di una sorgente che non vuole.
Una cosa da tenere fuori dal blocco: etichette stampate, insegne, testo leggibile sugli oggetti di scena. La scheda modello elenca il testo accurato tra i problemi aperti, quindi un oggetto che deve leggersi uguale in due inquadrature è l'ancoraggio meno affidabile a disposizione. Si ancori invece a forma e macchia.
L'estensione va in avanti, quindi pianifichi all'indietro
La formulazione di Google non lascia margini: "l'estensione video è limitata all'aggiunta in coda a un video; anteporre o estendere la parte centrale di una clip non è supportato." Le continuazioni procedono a passi di dieci secondi "fino a una lunghezza totale di 40s", e una clip caricata deve essere "di 10 secondi o meno" prima di poterla estendere.
La conseguenza per la pianificazione è più grande di quanto sembri: una catena non ha annullamento. L'inquadratura uno fissa palette, luce e grammatica di camera per tutto ciò che vi si appende, quindi un errore lì è una sequenza da ricostruire e non un'inquadratura da ri-renderizzare. E l'inquadratura più rischiosa — il gesto difficile, il riflesso complicato — di solito sta nel mezzo, esattamente dove non può arrivare.
C'è dunque una scelta strutturale da fare prima della prima chiamata:
- Una catena di estensione Le compra una continuazione autentica da fotogramma a fotogramma e dieci secondi di contesto che il modello legge davvero. Le costa la possibilità di correggere qualsiasi cosa che non sia la coda.
- Generazioni indipendenti cucite in montaggio, ciascuna ancorata da un'immagine di riferimento o da un fotogramma iniziale, Le costano la giunzione invisibile e Le comprano la possibilità di rilanciare trenta volte l'inquadratura tre senza toccare la uno e la due.
Per un'azione che non deve staccare visibilmente, estenda. Per una sequenza che comunque contiene stacchi, generi separatamente: è anche l'opzione che sopravvive a una nota del cliente, e quasi tutte le sequenze ne ricevono una.
Quella clip è una sola generazione che porta una riquadratura, non due inquadrature unite:
A two-shot in a cluttered garage workshop, 40mm lens at f/4, both
subjects sharp. A man in a faded green work jacket with a torn left
cuff stands at the bench; a woman in a grey knit sweater with a red
bandana tied at her neck stands to his right holding a clipboard.
The camera holds the wide two-shot for four seconds while he lifts
a machined aluminium part into the light and turns it. Then the
camera pushes in and reframes to a tighter two-shot from the same
axis - same jacket, same torn cuff, same bandana, same bench clutter
behind them, same overhead fluorescent light. No cut, no wardrobe
change, no relight. Sound: fluorescent hum and the part clicking
down onto steel.
I punti di stacco sono anche stacchi audio
L'audio è generato insieme all'immagine e non c'è alcun interruttore per rifiutarlo. Di solito la cosa si archivia sotto sound design; per la continuità è un vincolo, perché il Suo stacco cade in mezzo a una colonna sonora che non ha composto e che non può tagliare alla fonte.
Ne seguono due regole. Descriva l'ambiente con parole identiche su entrambi i lati di uno stacco, allo stesso modo in cui ripete il blocco del guardaroba: "fluorescent hum" in entrambi i prompt, non "fluorescent hum" e poi "the buzz of the overhead light". Un rumore di fondo che si sposta alla giunzione è più difficile da ignorare di una giacca che cambia tonalità, perché l'orecchio non ha un confine di inquadratura dietro cui nascondersi.
Poi scelga dove staccare pensando al suono. Staccare a metà gesto pretende che il modello riproduca lo stesso vettore di movimento dall'altra parte: esattamente il caso di "movimento complesso" che la scheda modello segnala. Staccare su una posa ferma, il pezzo appoggiato e la mano immobile, dà alla generazione successiva una condizione di partenza non ambigua e all'audio una cucitura naturale. Costa un tempo di ritmo e compra una giunzione che regge.
Una decisione viene prima di tutto questo: il rapporto d'aspetto. Il modello offre 16:9 e 9:16 e nient'altro. Poiché l'estensione aggiunge solo in coda e le immagini di riferimento ereditano l'inquadratura in cui sono state scattate, cambiare orientamento a metà sequenza non è un cambio di impostazione: invalida ogni asset a monte. Scelga l'orientamento pensando alla consegna, all'inquadratura uno.
Quanto costa una sequenza di quattro inquadrature
Gli strumenti di continuità di questo modello sono gratis. Una chiamata reference-to-video con sette immagini costa quanto una chiamata text-to-video nuda; i fotogrammi che passa a start-end-frame-to-video non aggiungono nulla. Paga secondi e risoluzione.
Quattro inquadrature da otto secondi fanno trentadue secondi. Al tier più alto:
| Dove | 32 s a 4K |
|---|---|
| E2X | $5.76 |
| Google, dalle tariffe a token pubblicate | $9.73 |
| fal | $9.60 |
| Runware | $10.24 |
| WaveSpeed | $12.48 |
Quel divario è una storia di moltiplicatori, non di sconti. Entrambe le scale salgono allo stesso modo da 360p a 1080p; all'ultimo gradino Google triplica la sua tariffa 720p e noi raddoppiamo la nostra, quindi lo scarto è più ampio esattamente dove le sequenze finite vengono consegnate. Il conto tier per tier, incluso il perché il tier più alto sia un upscale, sta nel nostro articolo sul 4K.
Ora lo applichi a come va davvero il lavoro di continuità. Nessuno porta a casa quattro inquadrature in quattro generazioni. Se l'inquadratura tre richiede sei tentativi e la quattro tre, sono quindici lavori: $21.60 qui contro $36.49 in diretta a 4K. Ed è l'argomento più forte a favore delle generazioni indipendenti rispetto a una catena unica: un rilancio costa un'inquadratura, non la coda della sequenza. Faccia i test di continuità a 360p, un sesto della tariffa 4K al secondo, e promuova la presa.
Dove ancora scivola
La versione onesta, dato che la scheda modello ce ne fornisce il lessico.
La divisione discende da ciò che i due meccanismi possono codificare. Una frase e una fotografia di riferimento portano proprietà grossolane e nominabili: silhouette e colore del capo, lunghezza e colore dei capelli, geometria della stanza, palette, direzione e durezza della luce, collocazione approssimativa degli oggetti grandi. Quelle un blocco di lock può dichiararle e un'immagine di riferimento può mostrarle.
Quello che nessuno dei due porta è la precisione sotto il livello di un nome: geometria facciale esatta tra inquadrature lontane tra loro, gioielli, piccoli oggetti di sfondo, dettagli fini del tessuto, e qualsiasi cosa stampata, che la scheda modello elenca a parte come inaffidabile. Google nomina lo schema solo in termini generali, e i recensori terzi lo descrivono come più marcato ai cambi di scena e ai movimenti di camera che dentro un'inquadratura tenuta. È la nostra lettura della documentazione e delle recensioni, non una misura; non abbiamo montato un banco che permetta di metterci un numero.
In pratica: una sequenza con un primo piano importante ha bisogno che quel primo piano sia generato da un set di riferimenti anziché ereditato da un campo lungo, perché l'identità sopravvive meglio a una riquadratura che a un cambio di scala. La tecnica del volto nella singola inquadratura è un articolo a sé, e il vocabolario di camera che tiene due inquadrature sullo stesso asse sta in quello sulla camera.
Nessuno dovrebbe vendere una narrazione da trenta inquadrature su questo modello promettendo un volto che non si muove mai. Quello che si può vendere è una sequenza in cui la deriva è abbastanza piccola da stare dentro uno stacco: raggiungibile con riferimenti, blocchi di lock e punti di stacco scelti sull'immobilità.
Parta dalla tabella in cima: nomini la deriva, scelga lo strumento, scriva il blocco una volta, lo ripeta esattamente. Il riferimento API di Google porta le forme di tag per legare i riferimenti per nome, e le pagine delle capability portano tariffe e schemi correnti.
Prezzi e condizioni di prodotto cambiano. Verifichi i prezzi correnti di ciascun fornitore prima di prendere una decisione d'acquisto.
Domande frequenti
Come si mantiene coerente un personaggio tra inquadrature in Gemini Omni 1.1 Flash?
Due meccanismi insieme. Passi il personaggio come immagini di riferimento tramite reference-to-video — il nostro schema ne accetta da una a sette, e Runware documenta lo stesso tetto — e ripeta in ogni prompt un blocco identico di fatti sull'aspetto, copiato e non parafrasato. I riferimenti portano l'identità; il testo ripetuto porta guardaroba, oggetti di scena e luce. La scheda modello di Google dice esplicitamente che la coerenza completa lungo le modifiche resta un problema aperto, quindi nessuno dei due basta da solo.
Il seed mantiene lo stesso personaggio tra due prompt di Gemini Omni?
No. Il seed fissa un campione, non un soggetto. Due prompt diversi sono due estrazioni diverse a prescindere dal seed, e una parola modificata in un prompt per il resto identico è un campione nuovo e non una variazione. Il seed si guadagna il posto per ri-renderizzare una presa approvata a una risoluzione superiore e per isolare una frase modificata. L'identità tra inquadrature viene dalle immagini di riferimento.
Quale capability Omni conviene usare per un'inquadratura che deve finire su un fotogramma preciso?
start-end-frame-to-video. Fornisce un'immagine iniziale e una finale, il modello genera l'intervallo, e il fotogramma che il Suo stacco successivo deve raccordare è quello che ha scelto Lei. Su E2X costa al secondo quanto un semplice text-to-video, quindi non c'è alcuna ragione di prezzo per evitarlo.
Gemini Omni 1.1 Flash può estendere un video all'indietro?
No. La documentazione di Google dice che l'estensione aggiunge solo in coda a una clip, senza modo di anteporre o di estendere la parte centrale. Le continuazioni procedono a passi di dieci secondi fino a un totale di quaranta, e la clip che estende deve essere di dieci secondi o meno. Quindi la prima generazione fissa l'aspetto di tutto ciò che segue, e un errore iniziale non si ripara senza ricostruire la catena.
Quante immagini di riferimento accetta Gemini Omni 1.1 Flash?
Il nostro schema reference-to-video ne accetta da una a sette, e la documentazione di Runware dichiara lo stesso massimo. Il riferimento di Google non pubblica alcun numero, anche se il suo esempio lavorato lega sei immagini taggate in un solo prompt: tratti quindi il sette come consenso di terze parti e non come garanzia documentata. I riferimenti video sono limitati a parte da Google a tre clip di massimo tre secondi ciascuna.
Qual è il punto migliore per staccare tra due inquadrature generate?
Sull'immobilità anziché a metà movimento. Una posa ferma dà alla generazione successiva una condizione di partenza non ambigua; uno stacco dentro un gesto chiede al modello di riprodurre un vettore di movimento, il caso di movimento complesso che la scheda modello di Google elenca come debolezza nota. E poiché ogni clip arriva con una colonna sonora che non può rifiutare, descriva l'ambiente con parole identiche su entrambi i lati della giunzione, altrimenti il rumore di fondo si sposta allo stacco.
Posso mescolare inquadrature 16:9 e 9:16 in una sola sequenza Omni?
Non utilmente. Quei due rapporti sono le uniche opzioni, l'estensione aggiunge nell'orientamento in cui è partita, e le immagini di riferimento portano l'inquadratura in cui sono state scattate: cambiare orientamento a metà strada invalida quindi ogni asset a monte. Decida orizzontale o verticale rispetto al formato di consegna, prima dell'inquadratura uno.
Conviene costruire una sequenza estendendo o generando inquadrature separate?
La tariffa al secondo è identica in entrambi i casi — l'estensione non porta sconti — quindi la differenza è quanto costa un rilancio. In una catena, correggere un'inquadratura iniziale butta via tutto ciò che vi è stato aggiunto. Con generazioni indipendenti ancorate da immagini di riferimento o fotogrammi iniziali, un'inquadratura sbagliata costa un'inquadratura. Su E2X trentadue secondi a 4K costano $5.76 contro $9.73 in diretta da Google, e quel divario si allarga con ogni presa che scarta.