OpenAI GPT Image 2.5 API auf E2X: xhigh- und max-Qualität bis 4K ab $0.0525
OpenAIs GPT Image 2.5 wird auf der E2X API über zwei spezialisierte Modellfamilien bereitgestellt:
- GPT Image 2.5 Sunburst (
openai/gpt-image-2.5-sunburst/text-to-image&openai/gpt-image-2.5-sunburst/edit-image): Unterstützt die Auflösungen1K,2Kund4Ksowie alle fünf Qualitätsstufen:low,medium,high,xhighundmax. - GPT Image 2.5 Flare (
openai/gpt-image-2.5-flare/text-to-image&openai/gpt-image-2.5-flare/edit-image): Unterstützt die Auflösungen1K,2Kund4Kmit den drei Standard-Qualitätsstufen:low,mediumundhigh.
Mit unserem dauerhaften Rabatt von 75 % kostet eine 1K-Anfrage $0.0525, eine 2K-Anfrage $0.105 und eine 4K-Anfrage $0.1575.
Diese Preise gelten pauschal für jede quality-Einstellung im Schema. Auf E2X nutzen die Qualitätsstufen xhigh und max auf Sunburst exakt denselben ×7-Multiplikator wie low, medium und high auf Sunburst und Flare. Sie können jeden Auftrag mit xhigh oder max ausführen, ohne dass Ihre Rechnung um einen einzigen Cent steigt.
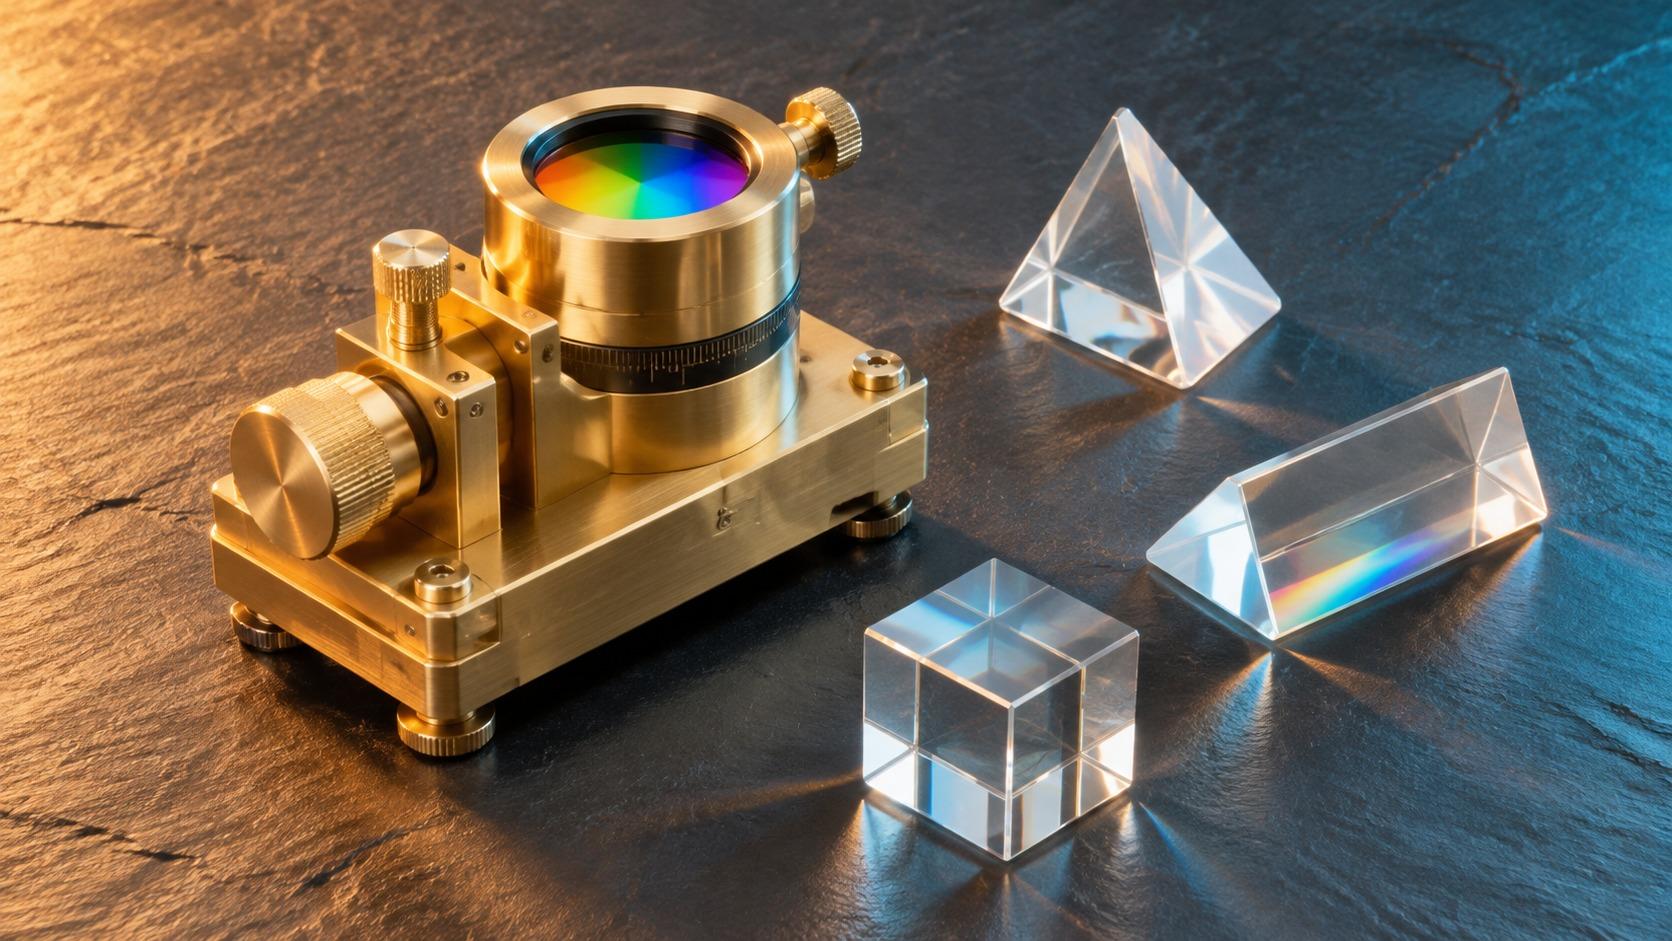
Dieser Leitfaden behandelt die vollständige Integration: wie Basispreis und Multiplikatoren Ihre Rechnung bestimmen, das komplette Eingabeschema für alle Routen, produktionsreifen curl- und TypeScript-Code für Polling und Webhooks sowie die exakten Prompts hinter den Beispiel-Renderings auf dieser Seite.
Wie der Preis von $0.0525 berechnet wird
Wer die Abrechnungsformel auf E2X kennt, vermeidet zwei häufige Fehler: für 4K-Auflösung zu bezahlen, während noch an der Prompt-Formulierung gefeilt wird, und quality herunterzusetzen, um Geld zu sparen, obwohl quality den Preis gar nicht verändert.
Sowohl openai/gpt-image-2.5-sunburst/text-to-image und openai/gpt-image-2.5-flare/text-to-image als auch deren Bearbeitungsrouten openai/gpt-image-2.5-sunburst/edit-image und openai/gpt-image-2.5-flare/edit-image teilen sich einen Listen-Basispreis von $0.03 (30,000 Mikro-Cent in der API-Antwort). E2X wendet darauf einen dauerhaften Rabatt von 75 % an, wodurch die Ausgangseinheit auf $0.0075 (7,500 Mikro-Cent) sinkt. Von dort aus multipliziert die Abrechnungs-Engine mit zwei Parameterfaktoren:
- Dem
quality-Faktor:low,medium,high(der Schema-Standardwert) sowiexhighundmax(auf Sunburst) verwenden jeweils einen ×7-Multiplikator. Die Multiplikation von$0.0075mit7ergibt$0.0525. - Dem
resolution-Faktor:1K(der Schema-Standardwert) wendet ×1 an,2Kwendet ×2 an und4Kwendet ×3 an.
Da alle quality-Werte in der dynamischen Preistabelle demselben ×7-Faktor zugeordnet sind, ist resolution der einzige Parameter, der Ihre Kosten pro Bild verändert. Sie sehen bei einem abgeschlossenen Auftrag niemals eine unmultiplizierte Gebühr von $0.0075, da quality standardmäßig auf high (×7) gesetzt wird, sobald Sie den Parameter weglassen. Und weil xhigh und max denselben ×7-Faktor teilen, spart ein Wechsel auf low oder medium null Dollar. Wählen Sie high, xhigh oder max passend zur visuellen Detaildichte Ihres Prompts und lassen Sie low außen vor.
| Auflösung | Multiplikator-Formel | E2X-Listenpreis ($0.03 × 7) | E2X-Preis (75 % Rabatt) | API Mikro-Cent | fal.ai On-Demand (High-Stufe) | E2X-Ersparnis |
|---|---|---|---|---|---|---|
1K (Standard) | $0.0075 × 7 × 1 | $0.21 | $0.0525 | 52500 | $0.211 | 75% |
2K | $0.0075 × 7 × 2 | $0.42 | $0.1050 | 105000 | $0.222 | 53% |
4K | $0.0075 × 7 × 3 | $0.63 | $0.1575 | 157500 | $0.401 | 61% |
Preisvergleich geprüft am 4. November 2026 gegenüber den On-Demand-Preisen von fal.ai. Anbieterpreise und Konditionen können sich ändern; aktuelle Zahlen finden Sie auf unserer Preisseite.
Für Teams mit iterativen Design-Schleifen macht diese Multiplikatorkurve die Budgetplanung einfach. Belassen Sie resolution fest auf "1K", während Sie Beleuchtung, Kamerawinkel und eingebetteten Text auf "xhigh" oder "max" verfeinern. Acht 1K-Entwürfe kosten zusammen $0.42. Sobald das Layout steht, führen Sie ein einzelnes "4K"-Master-Rendering für $0.1575 aus. Die gesamte Sequenz aus neun Bildern kostet damit $0.5775, verglichen mit $1.4175, wenn jeder Entwurf in 4K gelaufen wäre.
Beachten Sie die fünfte Spalte in der obigen Tabelle. Jedes von der E2X API zurückgegebene Währungsfeld ist eine Ganzzahl in Mikro-Cent, wobei 1,000,000 Mikro-Cent genau $1.00 USD entsprechen. Eine 1K-Generierung liefert 52500, eine 2K-Generierung 105000 und eine 4K-Generierung 157500. Speichern Sie diese Ganzzahlen direkt in Ihrer Buchhaltungstabelle und teilen Sie erst bei der Anzeige in einem Dashboard durch 1,000,000.
Vollständiges Parameterschema für Sunburst- und Flare-Endpunkte
Alle GPT Image 2.5 Routen (openai/gpt-image-2.5-sunburst/* und openai/gpt-image-2.5-flare/*) liegen hinter dem standardmäßigen E2X-Job-Umschlag unter POST https://api.e2x.ai/v1/jobs/submit. Sie übergeben die Modell-ID auf der obersten Ebene des JSON-Bodys und platzieren alle modellspezifischen Parameter innerhalb des input-Objekts.
| Parameter | Endpunkt-Verfügbarkeit | Typ | Erforderlich | Standard | Akzeptierte Werte / Limits |
|---|---|---|---|---|---|
prompt | Alle Endpunkte | string | Ja | Keiner | Bis zu 32,000 Zeichen bei text-to-image; bis zu 50,000 Zeichen bei edit-image. |
image_urls | Nur edit-image | string[] | Ja (bei Edit) | Keiner | Öffentlich erreichbare HTTPS-URLs für Referenz-Konditionierung, Compositing oder Bildbearbeitung. |
aspect_ratio | Alle Endpunkte | string | Nein | "1:1" | "auto", "1:1", "4:3", "3:4", "3:2", "2:3", "5:4", "4:5", "16:9", "9:16", "2:1", "1:2", "21:9", "9:21", "3:1", "1:3" (insgesamt 16). |
resolution | Alle Endpunkte | string | Nein | "1K" | "1K", "2K", "4K" (muss großgeschrieben sein). |
quality | Alle Endpunkte | string | Nein | "high" | Sunburst: "low", "medium", "high", "xhigh", "max". Flare: "low", "medium", "high". |
Drei Schema-Details verdienen besondere Beachtung, bevor Sie Ihre Validierungsschicht schreiben:
- Großgeschriebene
resolution-Strings sind bei OpenAI-Modellen zwingend erforderlich. Übergeben Sie"1K","2K"oder"4K". Wenn Ihre Codebasis bereits Google-Modelle aus unserem Text-zu-Bild-Katalog aufruft, bei denen Auflösungen kleingeschrieben werden ("1k","2k","4k"), normalisieren Sie die Groß-/Kleinschreibung pro Modell-Slug, anstatt eine einzige String-Konstante zu teilen. aspect_ratioist standardmäßig"1:1"und unterstützt"auto". Wenn Sieaspect_ratioweglassen, rendert GPT Image 2.5 ein quadratisches Bild. Wenn Sie explizit"auto"übergeben, wählt das Modell eines der unterstützten Seitenverhältnisse basierend auf dem im Prompt beschriebenen Motiv aus (oder behält beiedit-imageden Bildausschnitt Ihres primären Referenzbildes bei).- GPT Image 2.5 verzichtet auf den Parameter
background. Wederopenai/gpt-image-2.5-sunburst/*nochopenai/gpt-image-2.5-flare/*enthält das Feldbackground("transparent","opaque","auto"). Wenn Ihr Workflow einen transparenten PNG-Freisteller mit Alphakanal in einem einzigen API-Aufruf benötigt, leiten Sie diese Anfrage zum selben Preis von$0.0525anopenai/gpt-image-2/text-to-imageoderopenai/gpt-image-2/edit-imageweiter. Diese Routing-Entscheidung erläutern wir im Detail in unserem Vergleich GPT Image 2.5 vs. GPT Image 2.
Ihr erstes Bild mit curl generieren
Da Aufträge mit GPT Image 2.5 im Durchschnitt rund 60 Sekunden dauern, arbeitet die E2X API asynchron. Ihr POST-Aufruf validiert die Payload, reiht den Auftrag in die Warteschlange ein und gibt sofort eine jobId zurück.
Hier ist ein vollständiger curl-Aufruf an openai/gpt-image-2.5-sunburst/text-to-image mit der Auflösung "1K" und der Qualität "xhigh" ($0.0525):
curl -X POST https://api.e2x.ai/v1/jobs/submit \
  -H "Authorization: Bearer $E2X_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.5-sunburst/text-to-image",
    "input": {
      "prompt": "Overhead editorial photograph of an anodized aluminum mechanical keyboard on a dark walnut desk. Keycaps in matte charcoal with a single signal orange Esc key. Soft north-window daylight from the top left, crisp key legends.",
      "aspect_ratio": "3:2",
      "resolution": "1K",
      "quality": "xhigh"
    }
  }'
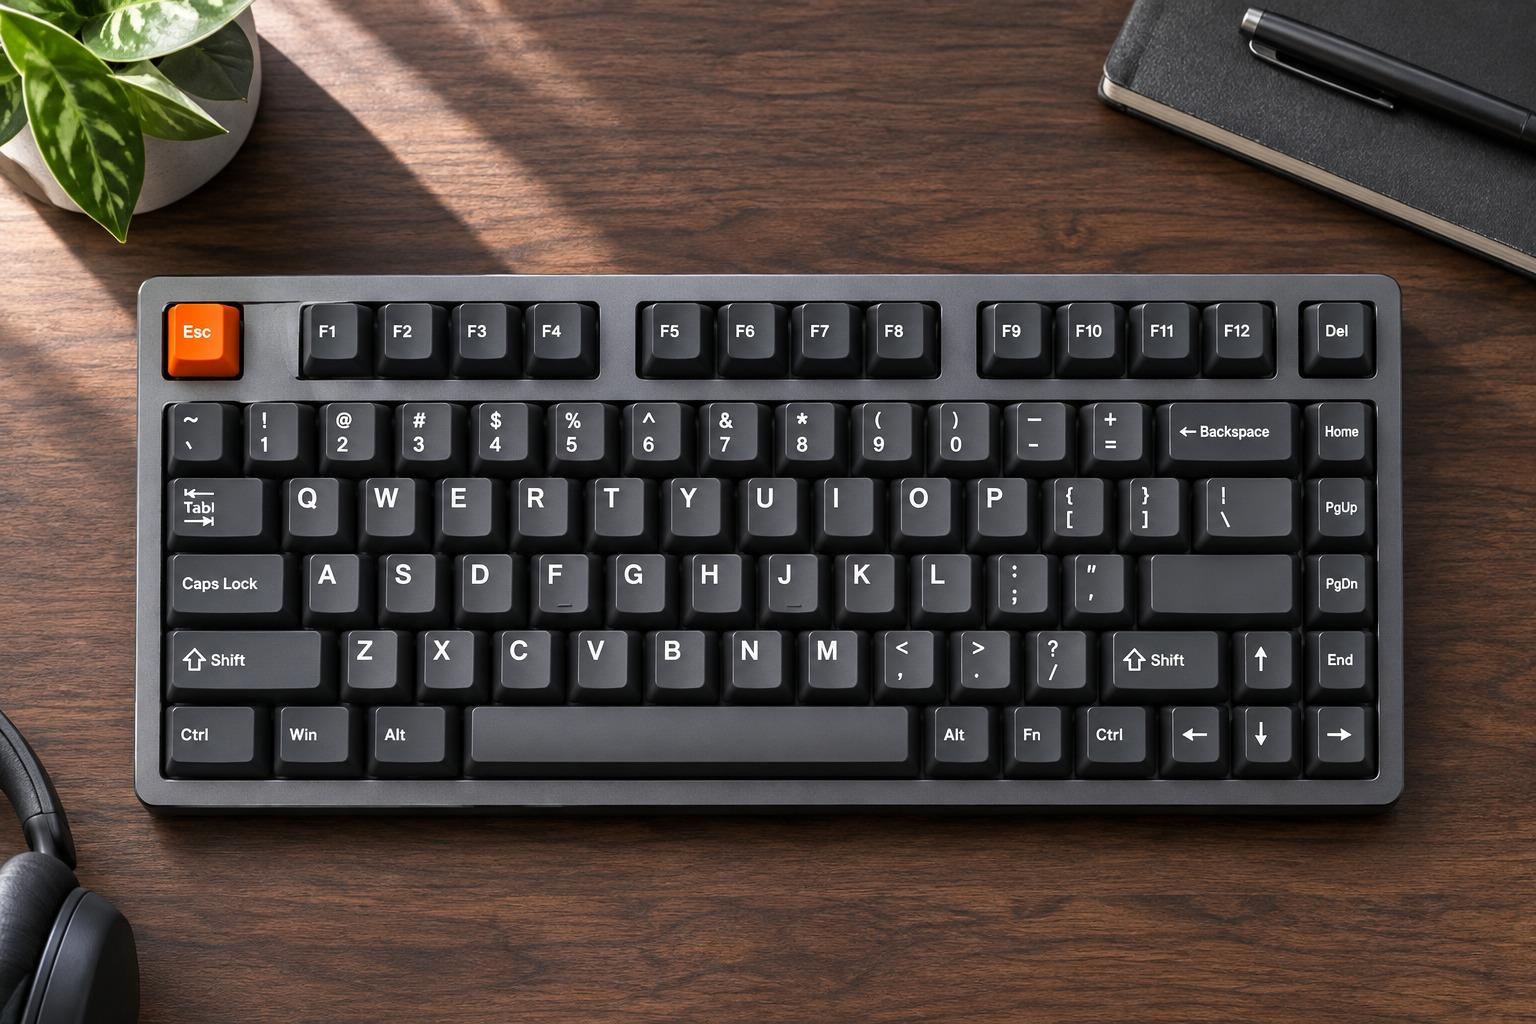
Für das obige Bild verwendeter Prompt:
"Overhead editorial photograph of an anodized aluminum mechanical keyboard on a dark walnut desk. Keycaps in matte charcoal with a single signal orange Esc key. Soft north-window daylight from the top left, crisp key legends."
Warum dieser Prompt bei der Qualität "xhigh" so gut funktioniert: Mechanische Tastaturen sind ein klassischer Härtetest für Bildgeneratoren, da unregelmäßige Tastenabstände, verzogene Reihen oder verschmierte Beschriftungen die Aufnahme sofort unbrauchbar machen. Durch die Vorgabe einer Perspektive direkt von oben, die genaue Benennung des Gehäusematerials (anodized aluminum), die Isolierung eines einzelnen Farbakzents (single signal orange Esc key) und die Anforderung der Qualität "xhigh" erhält das Modell genügend Sampling-Budget, um das Tastenraster gerade und die Tastenbeschriftungen gestochen scharf zu halten.
Wenn der Submit-Aufruf erfolgreich ist, antwortet die API mit 200 OK und einem JSON-Umschlag, der Ihre Job-ID enthält:
{
  "success": true,
  "data": {
    "jobId": "job_01J9X7K3M8P2Q4R6S8T0V2W4Y6",
    "status": "pending"
  }
}
Um den Status über Ihr Terminal abzufragen, rufen Sie GET https://api.e2x.ai/v1/jobs/{jobId} mit demselben Authorization-Header auf:
curl -s https://api.e2x.ai/v1/jobs/job_01J9X7K3M8P2Q4R6S8T0V2W4Y6 \
  -H "Authorization: Bearer $E2X_API_KEY"
Sobald data.status von pending über processing schließlich auf completed wechselt, befindet sich die fertige Bild-URL unter data.outputs[0].url.
Typografie und Poster-Layout auf der Qualitätsstufe max
Einer der wichtigsten Gründe für den Wechsel von high auf xhigh oder max bei GPT Image 2.5 Sunburst ist die Textdarstellung innerhalb strukturierter Grafik-Layouts. Poster, Buchcover, Verpackungsabwicklungen und UI-Karten erfordern eine präzise Grundlinienausrichtung und saubere Buchstabenformen.
Hier ist die Prompt- und Parameterkonfiguration, mit der ein Schweizer Ausstellungsposter im Format 2:3 bei "2K"-Auflösung und "max"-Qualität ($0.105) erstellt wurde:
'Minimalist museum poster on textured cotton paper. Centered Swiss grid typography reading "ZURICH DESIGN WERKSCHAU 2026" in bold black grotesque type above a cobalt blue geometric arch.'
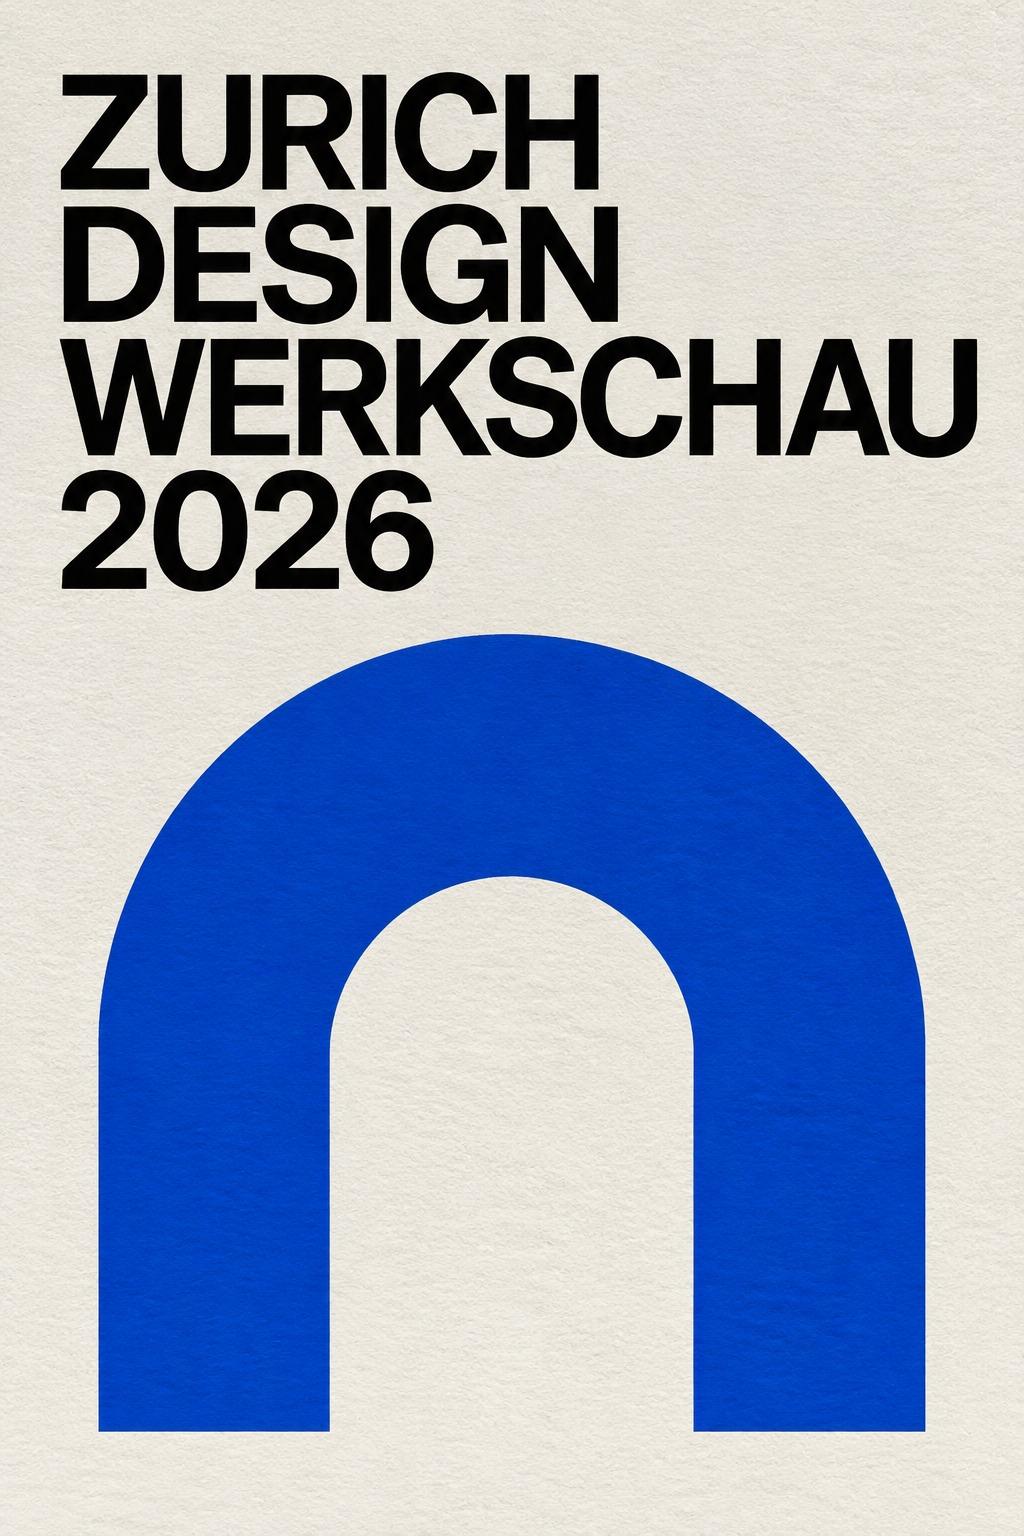
Drei praktische Regeln machen Schriften im Bild mit GPT Image 2.5 zuverlässig:
- Setzen Sie den exakten Anzeigetext in Anführungszeichen. Alles innerhalb der Anführungszeichen wird als wörtlicher Text behandelt, der auf die Leinwand gerendert werden soll, während die umgebenden Wörter die Schriftart (
bold black grotesque type), das Trägermaterial (textured cotton paper) und die Platzierung (Centered Swiss grid typography) beschreiben. - Nutzen Sie
xhighodermax, wann immer Schrift im Mittelpunkt steht. Da E2Xmaxmit demselben ×7-Multiplikator wiehighabrechnet, liefert"quality": "max"die präziseste Laufweite (Kerning) und die saubersten Buchstabenkanten ohne Mehrkosten. - Wählen Sie das endgültige Seitenverhältnis von Anfang an. Ein Poster gehört in
"2:3"oder"3:4". Wer zuerst in"1:1"generiert und später zuschneidet, schneidet die Ränder ab, auf denen das Rasterlayout aufbaut.
Produktive TypeScript-Integration: Polling und Speicherung
In einem Node.js- oder TypeScript-Backend muss Ihre Integration drei Aufgaben sauber erledigen: den Auftrag absenden, in einem sinnvollen Intervall abfragen (etwa 3 Sekunden entsprechen unserem Worker-Poll-Intervall) und die fertige Datei von der temporären E2X-Auslieferungs-URL in Ihren eigenen S3-, R2- oder GCS-Bucket kopieren.
Überspringen Sie den Download-Schritt nicht. Die unter data.outputs[0].url zurückgegebene URL ist ein kurzlebiger Auslieferungslink. Wenn Sie diesen String direkt in Ihrer Anwendungsdatenbank speichern, führt dies zu defekten Bildern, sobald das Auslieferungsobjekt abläuft.
import { writeFile, mkdir } from "node:fs/promises";
import path from "node:path";

const E2X_BASE_URL = "https://api.e2x.ai/v1";
const API_KEY = process.env.E2X_API_KEY;

if (!API_KEY) {
  throw new Error("Missing E2X_API_KEY environment variable");
}

type GptImageResolution = "1K" | "2K" | "4K";
type GptImageQuality = "low" | "medium" | "high" | "xhigh" | "max";

interface SubmitTextToImageInput {
  prompt: string;
  aspect_ratio?: string;
  resolution?: GptImageResolution;
  quality?: GptImageQuality;
  webhookUrl?: string;
}

const headers = {
  Authorization: `Bearer ${API_KEY}`,
  "Content-Type": "application/json",
};

export async function submitGptImage25(
  options: SubmitTextToImageInput
): Promise<string> {
  const { webhookUrl, ...input } = options;

  const response = await fetch(`${E2X_BASE_URL}/jobs/submit`, {
    method: "POST",
    headers,
    body: JSON.stringify({
      model: "openai/gpt-image-2.5-sunburst/text-to-image",
      input: {
        prompt: input.prompt,
        aspect_ratio: input.aspect_ratio ?? "2:3",
        resolution: input.resolution ?? "2K",
        quality: input.quality ?? "max",
      },
      ...(webhookUrl ? { webhookUrl } : {}),
    }),
  });

  if (!response.ok) {
    throw new Error(`Submit failed (${response.status}): ${await response.text()}`);
  }

  const payload = (await response.json()) as { data: { jobId: string } };
  return payload.data.jobId;
}

export async function pollUntilComplete(
  jobId: string,
  timeoutMs = 300_000
): Promise<string> {
  const deadline = Date.now() + timeoutMs;
  let delayMs = 3000;

  while (Date.now() < deadline) {
    await new Promise((resolve) => setTimeout(resolve, delayMs));

    const response = await fetch(`${E2X_BASE_URL}/jobs/${jobId}`, { headers });
    if (!response.ok) {
      throw new Error(`Status check failed with HTTP ${response.status}`);
    }

    const { data } = (await response.json()) as {
      data: {
        status: string;
        outputs?: Array<{ url: string }>;
        error?: { message?: string };
      };
    };

    if (data.status === "completed" && data.outputs?.[0]?.url) {
      return data.outputs[0].url;
    }
    if (data.status === "failed" || data.status === "cancelled") {
      throw new Error(data.error?.message ?? `Job ended in ${data.status}`);
    }

    delayMs = Math.min(Math.round(delayMs * 1.25), 8000);
  }

  throw new Error(`Timed out waiting for job ${jobId}`);
}

async function saveImage(url: string, destination: string): Promise<void> {
  const res = await fetch(url);
  if (!res.ok) throw new Error(`Download failed: HTTP ${res.status}`);
  await mkdir(path.dirname(destination), { recursive: true });
  await writeFile(destination, Buffer.from(await res.arrayBuffer()));
}
Wenn Sie lieber einen vorgefertigten Client verwenden möchten, anstatt eigene fetch-Wrapper zu schreiben, finden Sie auf der E2X SDKs-Seite offizielle Pakete und Konfigurationsbeispiele.
Wechsel zu Webhooks für Batch-Workloads
Alle GPT Image 2.5 Endpunkte unterstützen ein Parallelitätslimit von 100 aktiven Jobs pro Konto sowie Ratenbegrenzungen von 100 Aufrufen pro Minute, 5.000 Aufrufen pro Stunde und 50.000 Aufrufen pro Tag. Wenn Sie nahezu 100 Jobs parallel ausführen, blockieren 100 offene Polling-Schleifen im Arbeitsspeicher Ihre Worker-Prozesse und machen Deployments anfällig.
Durch die Übergabe von webhookUrl auf der obersten Ebene des /v1/jobs/submit-Bodys entfällt die Polling-Schleife. Sobald der Job den Status completed, failed oder cancelled erreicht, sendet E2X eine HTTP-POST-Benachrichtigung an Ihren Server:
curl -X POST https://api.e2x.ai/v1/jobs/submit \
  -H "Authorization: Bearer $E2X_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.5-sunburst/text-to-image",
    "input": {
      "prompt": "Overhead editorial photograph of an anodized aluminum mechanical keyboard on a dark walnut desk. Keycaps in matte charcoal with a single signal orange Esc key. Soft north-window daylight from the top left, crisp key legends.",
      "aspect_ratio": "3:2",
      "resolution": "1K",
      "quality": "xhigh"
    },
    "webhookUrl": "https://api.yourcompany.com/webhooks/e2x-image"
  }'
Erfassen Sie in Ihrem Webhook-Handler die eingehende jobId, verifizieren Sie den Status durch einen Aufruf von GET /v1/jobs/{jobId} mit Ihrem API-Schlüssel, laden Sie das Bild von data.outputs[0].url in Ihren permanenten Objektspeicher herunter und markieren Sie den Datenbankeintrag als abgeschlossen.
Bearbeiten und Compositing mit openai/gpt-image-2.5-sunburst/edit-image
Wenn Sie bereits ein Produktfoto, ein Verpackungslayout oder ein Architektur-Rendering vorliegen haben und bestimmte Bereiche ändern oder mehrere Referenzen zusammenführen müssen, wechseln Sie den Modell-Slug auf openai/gpt-image-2.5-sunburst/edit-image (oder openai/gpt-image-2.5-flare/edit-image).
Die Preisgestaltung entspricht exakt text-to-image (1K kostet $0.0525, 2K kostet $0.105, 4K kostet $0.1575), wobei sich zwei Schemaregeln ändern:
image_urlsist erforderlich. Übergeben Sie ein Array mit einer oder mehreren öffentlich erreichbaren HTTPS-URLs, die auf Ihre Quellbilder verweisen.- Das
prompt-Limit steigt auf 50.000 Zeichen. Dieser zusätzliche Platz (gegenüber 32.000 Zeichen beitext-to-image) ermöglicht es automatisierten Katalog-Pipelines, vollständige OCR-Transkripte, strikte Markenfarbvorgaben und Platzierungsregeln pro Referenzbild zu übergeben, ohne an ein Längenlimit zu stoßen.
Hier ist ein curl-Aufruf, der zwei Quellbilder in image_urls übergibt und sie bei "1K"-Auflösung und "max"-Qualität ($0.0525) zusammenfügt:
curl -X POST https://api.e2x.ai/v1/jobs/submit \
  -H "Authorization: Bearer $E2X_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.5-sunburst/edit-image",
    "input": {
      "prompt": "Place the brushed titanium chronograph watch from image 1 onto the wet dark slate surface from image 2. Preserve the exact dial markings, hands, and bezel knurling from image 1, and match the cool cyan rim reflections from image 2.",
      "image_urls": [
        "https://your-cdn.example.com/catalog/chronograph-cutout.png",
        "https://your-cdn.example.com/backdrops/wet-slate-studio.jpg"
      ],
      "aspect_ratio": "1:1",
      "resolution": "1K",
      "quality": "max"
    }
  }'
Geben Sie beim Schreiben von Prompts für edit-image explizit an, was geändert werden soll und was unverändert bleiben muss, und referenzieren Sie Ihre Eingabebilder über ihre 1-basierte Position in image_urls (image 1, image 2). Multi-Image-Indizierung, den Austausch von Verpackungsetiketten und 50K-Prompt-Vorlagen behandeln wir ausführlich in unserem Leitfaden zur Multi-Referenz-Bildbearbeitung mit GPT Image 2.5.
Wie sich GPT Image 2.5 in den E2X-Modellkatalog einfügt
Sie können alle von uns gehosteten Bildmodelle im E2X-Modellkatalog durchsuchen oder gezielt nach der Kategorie Text-zu-Bild und der Kategorie Bild-zu-Bild filtern. Da jedes Modell auf E2X denselben /v1/jobs/submit-Vertrag nutzt, erfordert ein Wechsel zwischen OpenAI- und Google-Modellen lediglich das Ändern des model-Strings und das Anpassen der Groß-/Kleinschreibung von resolution.
- Wählen Sie GPT Image 2.5 Sunburst oder GPT Image 2.5 Flare (
1Kfür$0.0525,4Kfür$0.1575), wenn Sie OpenAIs Prompt-Treue und Typografie-Darstellung kombiniert mit den Qualitätsstufenxhighodermax(auf Sunburst) sowieaspect_ratio: "auto"wünschen. - Wählen Sie GPT Image 2 (
1Kfür$0.0525,4Kfür$0.1575), wenn Ihre Pipeline native PNG-Freisteller mit Alphakanal überbackground: "transparent"benötigt. - Wählen Sie Google Nano Banana 2.1 (
1Kfür$0.03,2Kfür$0.04,4Kfür$0.09), wenn Sie den günstigsten 4K-Generierungspreis auf E2X oder extreme Panorama-Seitenverhältnisse wie8:1und1:8benötigen. - Wählen Sie Google Nano Banana Pro (
1K/2Kfür$0.075,4Kfür$0.15), wenn Sie rollengetrennte Charakterkonsistenz über mehrere Referenzbilder hinweg benötigen.
Häufig gestellte Fragen
Warum kosten xhigh und max auf E2X genauso viel wie low und high?
Im Preisschema von E2X für openai/gpt-image-2.5-sunburst/text-to-image und openai/gpt-image-2.5-sunburst/edit-image (sowie für die flare-Endpunkte auf low, medium und high) werden alle quality-Werte (low, medium, high, xhigh, max) mit demselben ×7-Multiplikator auf den rabattierten Basispreis von $0.0075 angerechnet. Das ergibt $0.0525 (1K), $0.105 (2K) und $0.1575 (4K) über jede Qualitätseinstellung hinweg.
Was ist der Unterschied zwischen den Endpunkten text-to-image und edit-image?
openai/gpt-image-2.5-sunburst/text-to-image (und flare/text-to-image) generiert neue Bilder allein aus einem Text-prompt (Limit von 32.000 Zeichen). openai/gpt-image-2.5-sunburst/edit-image (und flare/edit-image) erfordert sowohl prompt (Limit von 50.000 Zeichen) als auch image_urls (Quellbild-URLs), um bestehende Grafiken zu bearbeiten, umzugestalten oder zusammenzusetzen. Alle Endpunkte teilen sich exakt dieselben Preise und Ratenbegrenzungen.