GPT Image 2.6 Sunburst Text-to-Image-API auf E2X
GPT Image 2.6 Sunburst ist OpenAIs Reasoning-gestütztes Flaggschiff für die Text-zu-Bild-Generierung auf E2X, bereitgestellt unter openai/gpt-image-2.6-sunburst/text-to-image. Zum Start im November 2026 auf Platz 1 des Design-Arena-Text-to-Image-Leaderboards geführt, behält der Endpunkt unseren dauerhaften Rabatt von 75 % bei ($0.0525 pro Bild bei resolution: "1K" gegenüber $0.211 für eine vergleichbare High-Tier-Anfrage auf fal.ai) und führt erstmals die native Generierung mehrbildiger animierter .gif-Dateien (output_format: "gif"), skalierbarer .svg-Vektorpfade (output_format: "svg") sowie fünf Qualitätsstufen (low, medium, high, xhigh, max) über die Auflösungen 1K, 2K und 4K hinweg ein. Da alle fünf Qualitätseinstellungen auf E2X denselben ×7-Multiplikator teilen, können Sie xhigh oder max bei 1K für exakt dieselben $0.0525 ausführen wie low oder medium.
Wenn Ihr Workflow mit vorhandenen Fotografien, Produkt-Packshots oder visuellen Annotationen statt einer leeren Leinwand beginnt, rufen Sie stattdessen GPT Image 2.6 Sunburst edit-image auf. Dieser Endpunkt rechnet nach exakt derselben Preisliste ab ($0.0525 bei 1K, $0.105 bei 2K, $0.1575 bei 4K) und akzeptiert bis zu 16 Referenzbilder über image_urls zusammen mit bis zu 50.000 Zeichen langen Delta-Prompts. Für Hochgeschwindigkeits-Produktionslasten, bei denen Antwortzeiten unter 10 Sekunden Vorrang vor xhigh/max-Feinabstimmung haben, nutzen Sie GPT Image 2.6 Flare text-to-image (edit-image), das die drei schlanken Stufen (low, medium, high) bereitstellt.
Visuelle und animierte GIF-Showcase-Galerie
Jedes der folgenden Beispiele wurde direkt über die GPT Image 2.6-Pipeline generiert und über das E2X-CDN (assets.e2x.ai) ausgeliefert. Die Auswahl umfasst mehrbildige geloopte .gif-Synthese, native XML-.svg-Vektorpfade, dichte technische Typografie und Subsurface-Scattering-Hautrendering.
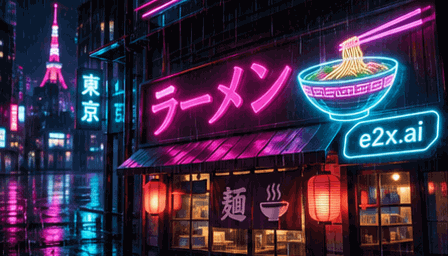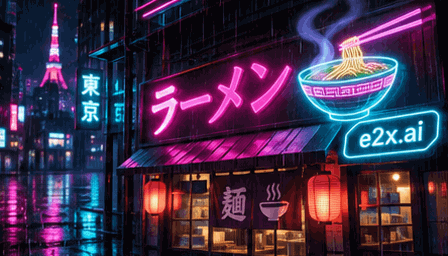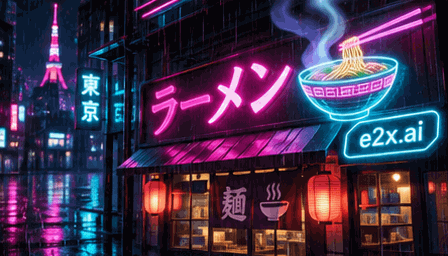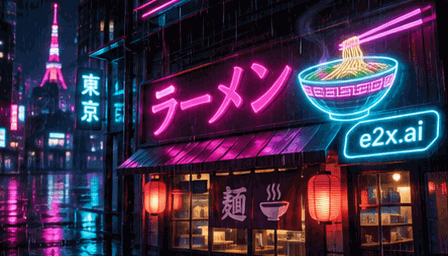
- Endpunkt:
openai/gpt-image-2.6-sunburst/text-to-image (output_format: "gif", aspect_ratio: "16:9", frame_count: 9, frame_duration_ms: 140, 448×256)
- Prompt:
"A glowing neon cyberpunk ramen shop sign at night in Tokyo with animated rising steam from a holographic noodle bowl, flickering magenta and cyan rain reflections, and crisp neon badge reading \"e2x.ai\", smooth looping multi-frame animation"
- Endpunkt:
openai/gpt-image-2.6-sunburst/text-to-image (output_format: "svg", aspect_ratio: "1:1", 1024×1024 skalierbares XML-<svg>)
- Prompt:
"Clean geometric vector emblem badge for \"e2x.ai\" featuring a stylized radiant sunburst prism and orbital rings in vibrant gold, cyan, and deep obsidian navy, crisp flat vector paths"
Dichte technische Typografie und Blaupausen-Layout (aspect_ratio: "3:2")
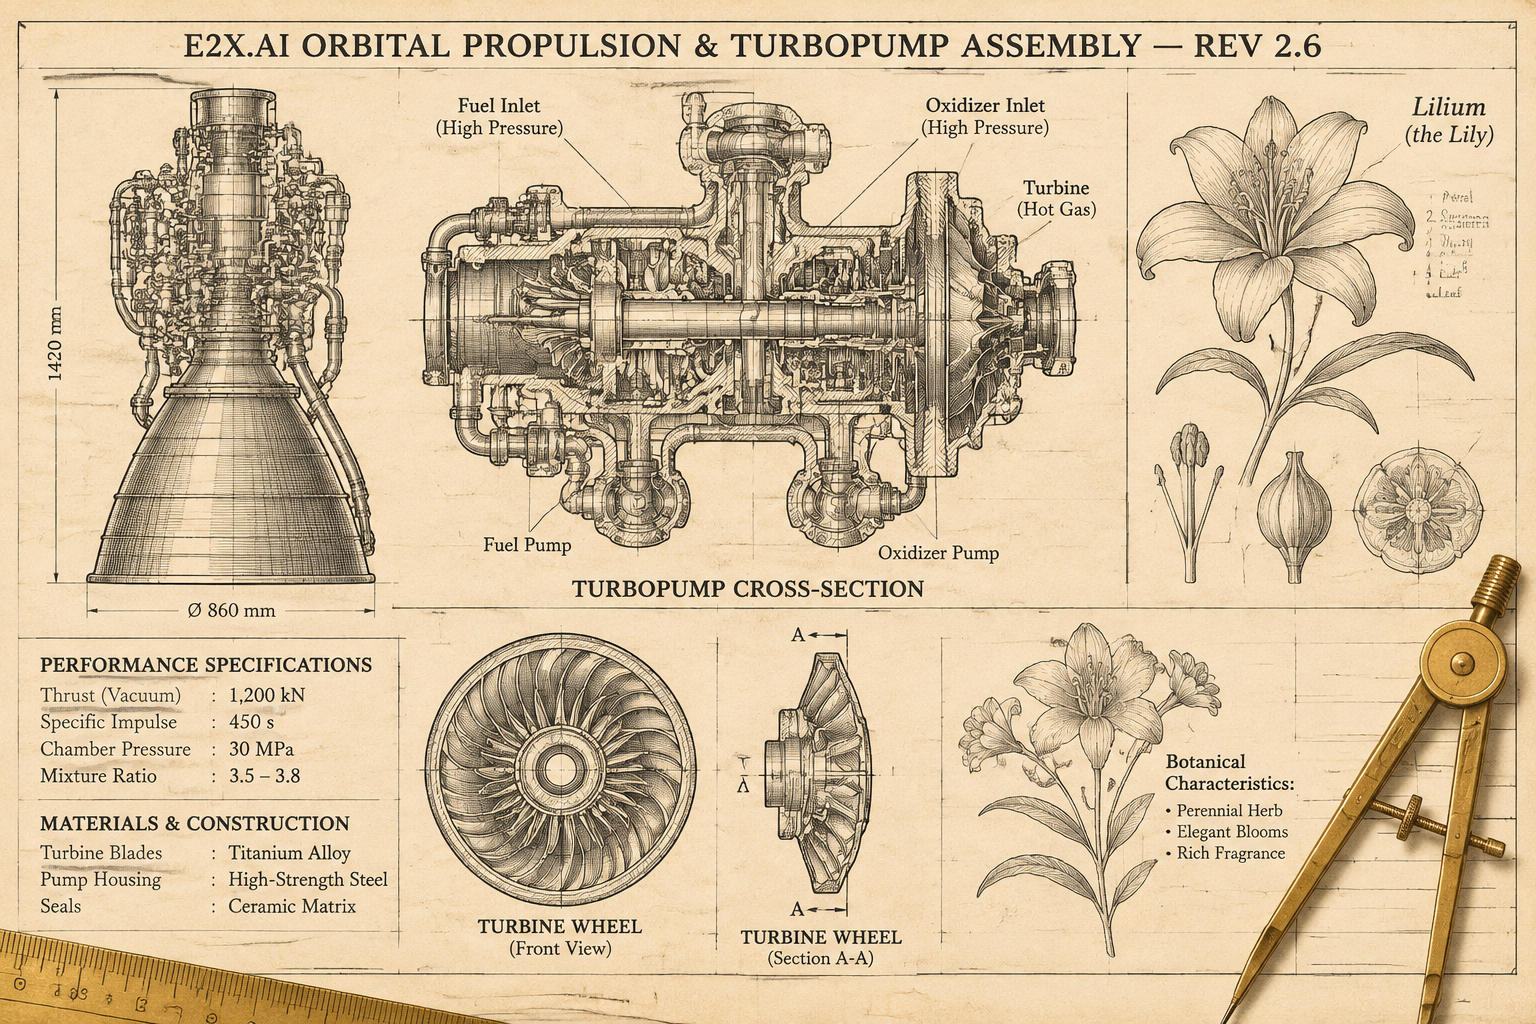
- Endpunkt:
openai/gpt-image-2.6-sunburst/text-to-image (output_format: "png", aspect_ratio: "3:2", 1536×1024)
- Prompt:
"Intricate vintage aerospace propulsion blueprint and botanical encyclopedia poster on aged cream archival paper with crisp multi-line technical typography reading \"E2X.AI ORBITAL PROPULSION & TURBOPUMP ASSEMBLY — REV 2.6\", detailed cross-section turbine diagrams, callout labels, and brass drafting compasses"
Fotorealistisches Porträt und Subsurface Scattering (aspect_ratio: "4:5")
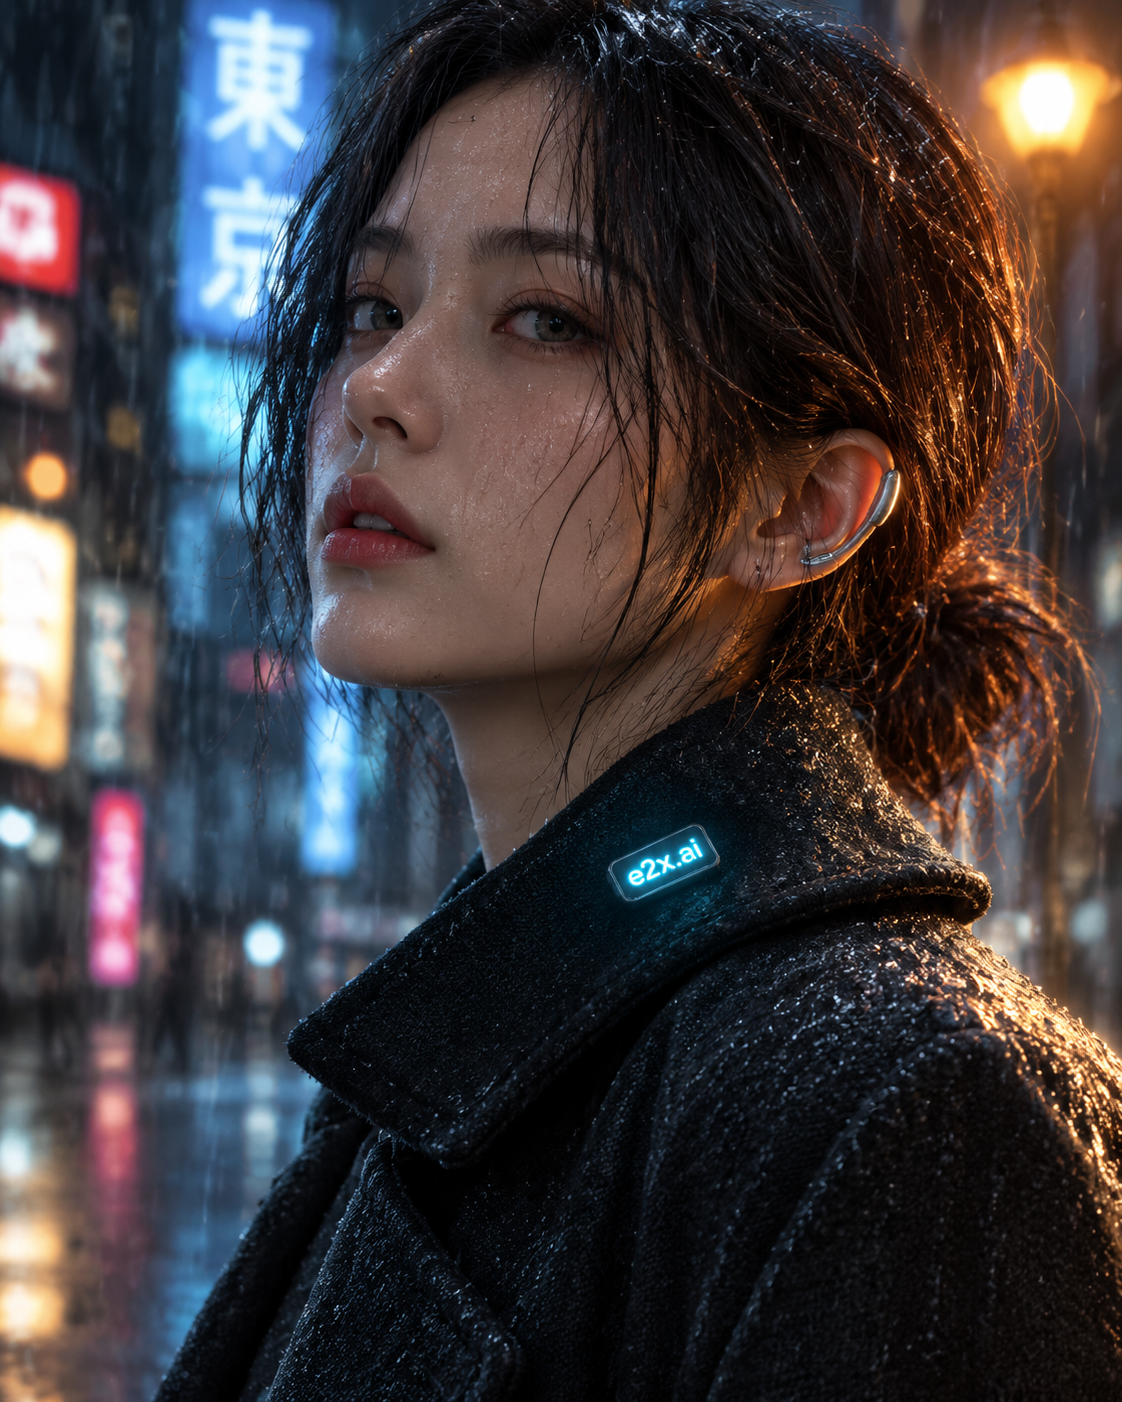
- Endpunkt:
openai/gpt-image-2.6-sunburst/text-to-image (output_format: "png", aspect_ratio: "4:5", 1122×1402)
- Prompt:
"Editorial close-up portrait of a cybernetic artisan in rain-soaked dark wool coat under neon Tokyo streetlamps, natural skin micro-texture, water droplets on eyelashes, warm amber subsurface scattering on the ear, and a subtle glowing cyan collar pin reading \"e2x.ai\", shallow depth of field 85mm f/1.4 lens"
Sunburst Max vs. Flare High im direkten Vergleich (aspect_ratio: "16:9")
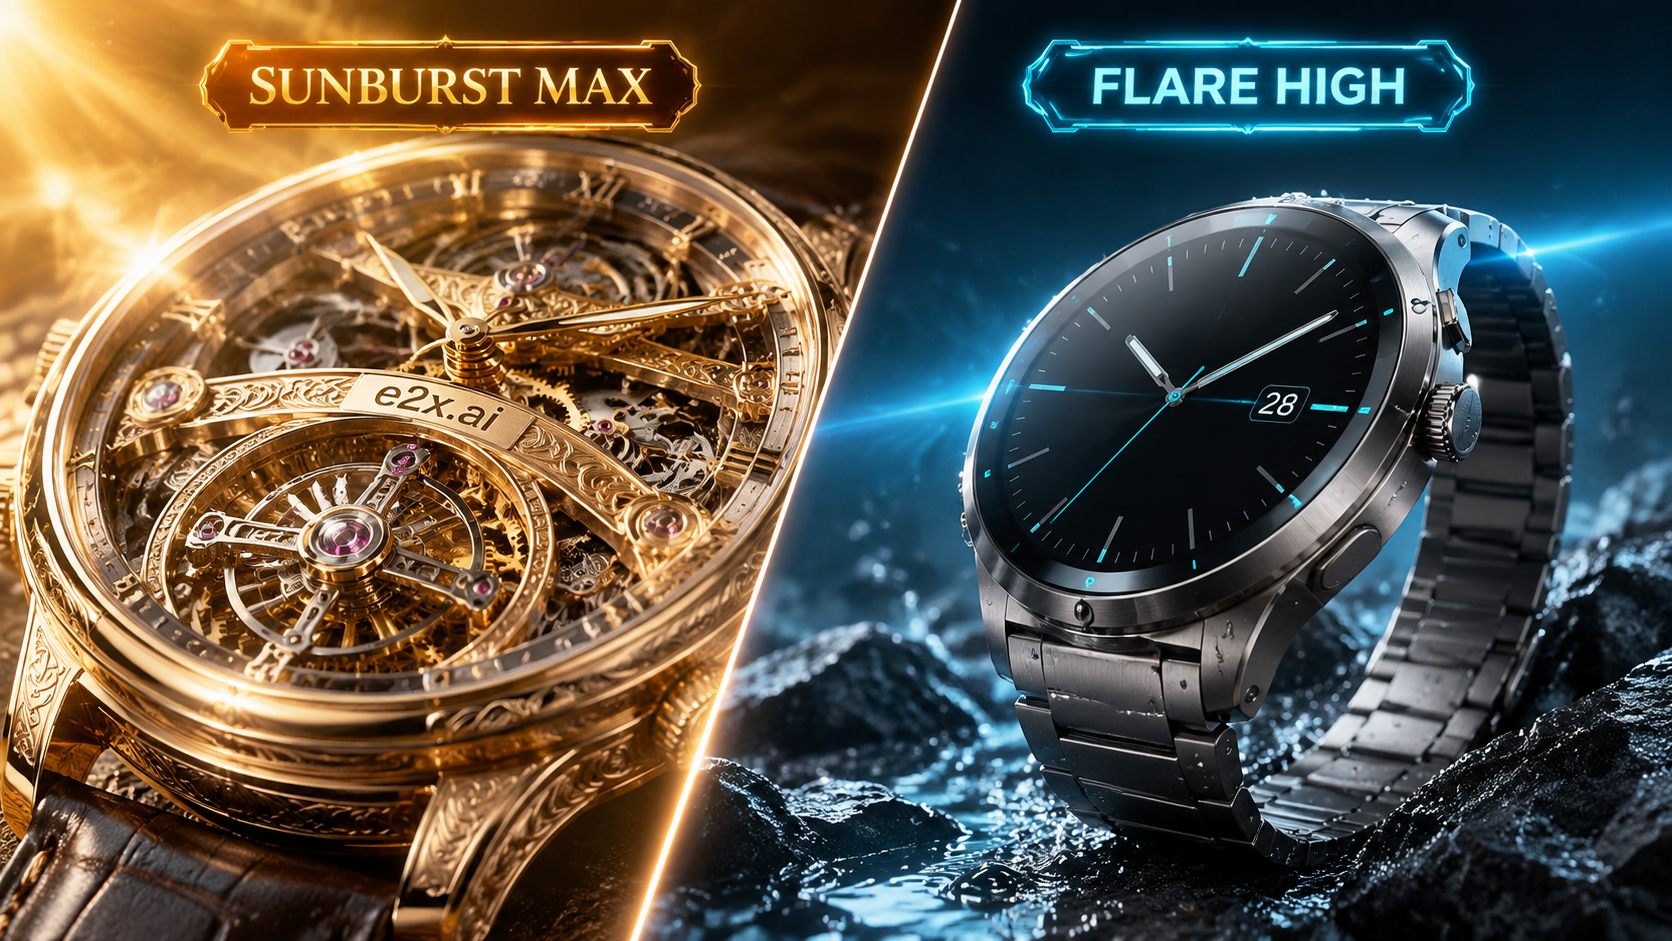
- Endpunkt:
openai/gpt-image-2.6-sunburst/text-to-image (output_format: "png", aspect_ratio: "16:9", 1672×941)
- Prompt:
"Split-screen visual comparison in a luxury studio: on the left side under a warm golden badge reading \"SUNBURST MAX\", an ultra-intricate macro photograph of an open-worked tourbillon mechanical watch with engraved gold bridges reading \"e2x.ai\" and warm sunburst lighting; on the right side under a sleek cyan badge reading \"FLARE HIGH\", a high-contrast commercial product shot of a matte titanium smartwatch on wet dark basalt with electric cyan lens flare"
Wie Auflösungs- und Qualitätsmultiplikatoren Ihre Abrechnung beeinflussen
Jeder Aufruf an openai/gpt-image-2.6-sunburst/text-to-image beginnt bei einem Listen-Basispreis von $0.03 (30,000 Mikro-Cent), der durch unseren dauerhaften globalen Rabatt von 75 % auf eine rabattierte Basis von $0.0075 (7,500 Mikro-Cent) gesenkt und anschließend mit zwei Schemafaktoren multipliziert wird:
resolution-Multiplikator: 1K (Standard) ist ×1, 2K ist ×2 und 4K ist ×3.quality-Multiplikator: low, medium (Standard), high, xhigh und max tragen alle denselben ×7-Multiplikator.
Bei tokenbasiert abgerechneten Upstream-APIs ($5/1M Text-Input, $8/1M Bild-Input, $30/1M Bild-Output) sowie Drittanbieter-Wrappern, deren Qualitätsmultiplikatoren von 1× auf bis zu 12× steigen ($0.90 pro Bild bei max), vervielfacht ein Wechsel auf xhigh oder max Ihre Kosten pro Rendering. Auf E2X multipliziert jeder quality-Wert die rabattierte Basis von $0.0075 mit 7, sodass resolution der einzige Parameter bleibt, der Ihren Preis verändert. Eine Anfrage mit quality: "max" kostet bei 1K exakt dieselben $0.0525 wie low oder medium.
Hier ist die am 6. November 2026 gegen die On-Demand-Tarife von fal.ai geprüfte Preistabelle:
| Auflösung | Multiplikator | E2X-Listenpreis ($0.03 × 7) | E2X-Preis (75 % Rabatt) | fal.ai (High-Tier) | E2X-Ersparnis |
|---|
1K (Standard) | ×1 × 7 | $0.21 | $0.0525 | $0.211 | 75 % günstiger |
2K | ×2 × 7 | $0.42 | $0.1050 | $0.222 | 53 % günstiger |
4K | ×3 × 7 | $0.63 | $0.1575 | $0.401 | 61 % günstiger |
Diese Kostenkurve gibt vor, wie Sie eine iterative Pipeline strukturieren sollten. Belassen Sie resolution auf 1K ($0.0525), während Sie Bildkomposition, Lichtsetzung und Textelemente in Anführungszeichen bei high, xhigh oder max testen. Zehn 1K-Iterationen plus ein einzelnes 4K-Master-Rendering ($0.1575) kosten zusammen $0.6825 – verglichen mit $1.7325, wenn Sie alle elf Aufrufe direkt in 4K ausführen würden.
Preise und Produktbedingungen können sich ändern. Prüfen Sie vor einer Kaufentscheidung stets die aktuellen Preise des jeweiligen Anbieters. Google-Batch- oder Flex-Preise sind nicht direkt mit einer regulären On-Demand-API-Anfrage vergleichbar, da Zeitplanung, Verfügbarkeit und Verarbeitungsbedingungen abweichen; sie sind daher von diesem Vergleich ausgeschlossen. Dies ist ein abgegrenzter Vergleich und kein Anspruch darauf, dass E2X in jeder Konfiguration weltweit die günstigste Option darstellt.
Was sich in GPT Image 2.6 Sunburst gegenüber Flare und 2.5 geändert hat
Der Preis ist über GPT Image 2.6 Sunburst, GPT Image 2.6 Flare und GPT Image 2.5 Sunburst hinweg identisch ($0.0525 bei 1K, $0.105 bei 2K, $0.1575 bei 4K), sodass Ihre Modellwahl von vier Architektur-Upgrades in Version 2.6 abhängt:
- Native animierte
.gif- und Vektor-.svg-Ausgabe (output_format). Neben png (Standard), jpeg und webp akzeptiert openai/gpt-image-2.6-sunburst/text-to-image nun auch output_format: "gif" und output_format: "svg". Mit "gif" synthetisiert das Modell kohärente, mehrbildige Loop-Animationen direkt aus einem Text-Prompt (Upstream-Schemata unterstützen 2 bis 16 Frames bei 20 bis 2.000 ms Frame-Dauer und auf Vielfache von 16 gerasterte Abmessungen). Mit "svg" werden saubere, skalierbare XML-Vektorpfadgrafiken (<svg>) ausgegeben, die sofort für Logos, Badges, UI-Icons sowie Laser-Cut- oder Druck-Workflows einsetzbar sind.
- Sunburst (5 Qualitätsstufen) vs. Flare (3 Hochgeschwindigkeitsstufen). GPT Image 2.6 Sunburst bietet
low, medium (Standard), high, xhigh und max für maximale Mikrotextur, räumliches Layout-Reasoning und dichte mehrzeilige Typografie. GPT Image 2.6 Flare stellt low, medium und high bereit und arbeitet für latenzkritische interaktive Apps bis zu 2×–2.5× schneller als 2.5 Flare (~6 Sekunden bei low-Qualität).
- 15 feste Seitenverhältnisse und räumliche Vorab-Planung. Das 2.6-Schema standardisiert auf 15 explizite Formate (
1:1, 1:2, 2:1, 1:3, 3:1, 2:3, 3:2, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 9:21, 21:9) mit 1:1 als Standardwert. Intern nutzt GPT Image 2.6 eine räumliche Planung vor dem Zeichnen (complexity: low, medium, high), um Perspektivraster, Beschriftungs-Callouts und Beziehungen zwischen mehreren Objekten vor dem eigentlichen Pixel-Rendering festzulegen.
- Erweitertes Editing mit bis zu 16 Referenzbildern auf der Schwesterroute. Wenn Sie zu GPT Image 2.6 Sunburst edit-image wechseln, steigt das Limit von
image_urls von 10 auf 16 Referenzbilder – begleitet von 50.000-Zeichen-Delta-Prompts, Masken-Inpainting (mask_image) und visueller Markup-Steuerung (markup_image).
Einen Generierungsauftrag über die E2X-API absenden
Jedes Modell auf E2X verwendet dieselbe asynchrone Job-Queue. Senden Sie per POST ein JSON-Payload mit Ihrem Bearer-Token an https://api.e2x.ai/v1/jobs/submit und fragen Sie https://api.e2x.ai/v1/jobs/{jobId} ab, bis der Status completed erreicht, oder übergeben Sie eine webhookUrl im Submit-Payload.
Lediglich prompt ist erforderlich (bis zu 32.000 Zeichen). Hier ist ein curl-Beispiel, das ein 1K-Bild in max-Qualität ($0.0525) generiert oder output_format auf "gif" bzw. "svg" umstellt:
curl -X POST https://api.e2x.ai/v1/jobs/submit \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.6-sunburst/text-to-image",
    "input": {
      "prompt": "Intricate vintage aerospace propulsion blueprint on aged cream archival paper with crisp technical typography reading \"E2X.AI ORBITAL PROPULSION — REV 2.6\", cross-section turbine diagrams, and brass drafting compasses.",
      "aspect_ratio": "3:2",
      "resolution": "1K",
      "quality": "max",
      "output_format": "png"
    }
  }'
Sobald das Layout freigegeben ist, erhöhen Sie resolution auf 2K ($0.105) oder 4K ($0.1575) oder generieren Sie in Ihrem Node.js-Anwendungscode ein animiertes .gif bzw. Vektor-.svg:
const headers = {
  Authorization: `Bearer ${process.env.E2X_API_KEY}`,
  "Content-Type": "application/json",
};

const submitRes = await fetch("https://api.e2x.ai/v1/jobs/submit", {
  method: "POST",
  headers,
  body: JSON.stringify({
    model: "openai/gpt-image-2.6-sunburst/text-to-image",
    input: {
      prompt: 'A glowing neon cyberpunk ramen shop sign at night in Tokyo with animated rising steam from a holographic noodle bowl, flickering magenta and cyan rain reflections, and crisp neon badge reading "e2x.ai", smooth looping multi-frame animation',
      aspect_ratio: "16:9",
      resolution: "1K",
      quality: "xhigh",
      output_format: "gif",
    },
  }),
});

const { data: submitted } = await submitRes.json();

for (let poll = 0; poll < 120; poll++) {
  await new Promise((r) => setTimeout(r, 3000));
  const statusRes = await fetch(
    `https://api.e2x.ai/v1/jobs/${submitted.jobId}`,
    { headers }
  );
  const { data: job } = await statusRes.json();

  if (job.status === "completed") {
    console.log("Generated asset URL:", job.outputs[0].url);
    break;
  }
  if (job.status === "failed" || job.status === "cancelled") {
    throw new Error(job.error?.message || `Job ended with status ${job.status}`);
  }
}
Zwei wichtige Implementierungshinweise: resolution-Werte müssen großgeschrieben werden (1K, 2K, 4K), und die in data.outputs zurückgegebenen Ausgabe-URLs sollten in Ihren eigenen Storage-Bucket kopiert werden, wenn Sie diese langfristig ausliefern möchten. Das vollständige Schema ist in unserer maschinenlesbaren Modellspezifikation veröffentlicht, und offizielle Client-Bibliotheken finden Sie auf der E2X-SDK-Seite.
Das passende Text-to-Image-Modell auf E2X auswählen
Wählen Sie zwischen unseren OpenAI- und Google-Endpunkten danach aus, ob Ihr Prompt xhigh/max-Typografie, native .gif- und .svg-Ausgaben, Antwortzeiten unter 10 Sekunden, transparente PNG-Freisteller oder ultrabreite Bannerformate erfordert:
| Modell | 1K-Preis | 4K-Preis | Max. Auflösung | Ausgabeformate | Beste Eignung |
|---|
| GPT Image 2.6 Sunburst | $0.0525 | $0.1575 | 4K | png, jpeg, webp, gif, svg | #1 Design-Arena-Qualität (xhigh/max ohne Aufpreis), animierte GIFs, Vektor-SVGs, dichte Typografie |
| GPT Image 2.6 Flare | $0.0525 | $0.1575 | 4K | png, jpeg, webp, gif, svg | Schnelle 3-stufige (low, medium, high) Generierung plus native .gif- und .svg-Ausgabe |
| GPT Image 2.5 Sunburst | $0.0525 | $0.1575 | 4K | png, jpeg, webp | Bestehende 2.5-Workflows, die aspect_ratio: "auto" benötigen |
| GPT Image 2 | $0.0525 | $0.1575 | 4K | png, jpeg, webp | Transparente PNG-Freisteller in einem Aufruf (background: "transparent") zum selben Preis |
| Nano Banana 2.1 | $0.0300 | $0.0900 | 4K | png, jpeg, webp | Niedrigster 4K-Preis ($0.09) und extreme 8:1- / 1:8-Bannerformate |
| Nano Banana Pro | $0.0750 | $0.1500 | 4K | png, jpeg, webp | Gesichtsidentitäts-Konsistenz über mehrere Charaktere und suchgestützte Szenen |
Vergleichen Sie alle Funktionen direkt nebeneinander in der Text-to-Image-Kategorie oder durchsuchen Sie den gesamten E2X-Modellkatalog.
Grenzwerte und Hinweise zum Betrieb
- Rate-Limits und Parallelität: Der Endpunkt erlaubt bis zu 100 Anfragen pro Minute, 5.000 Anfragen pro Stunde, 50.000 Anfragen pro Tag und 100 gleichzeitige Jobs pro Konto.
- Verarbeitungszeit: Die geschätzte Fertigstellungszeit liegt bei rund 60 Sekunden. Höhere Qualitätsstufen (
xhigh, max), mehrbildige .gif-Synthese sowie 2K/4K-Upscaling-Schritte können länger dauern als ein medium/1K-Durchlauf. Nutzen Sie daher Webhooks oder ein 3-Sekunden-Polling-Intervall anstelle enger synchroner Timeouts.
- Seitenverhältnis-Grenzen: Die 15 unterstützten Formate reichen von horizontalen
3:1- und 21:9-Frames bis zu vertikalen 1:3- und 9:21-Frames (1:1, 1:2, 2:1, 1:3, 3:1, 2:3, 3:2, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 9:21, 21:9). Falls ein Layout 4:1- oder 8:1-Ribbon-Header erfordert, leiten Sie diesen Auftrag an Nano Banana 2.1 weiter.
- Herkunftsmetadaten (Provenance): Ausgaben der OpenAI-Bildfamilie enthalten standardmäßige C2PA-Herkunftsmetadaten und Attributionsmarkierungen auf Pixelebene, die von sozialen Plattformen ausgelesen werden, um KI-Kennzeichnungen anzuzeigen.
Prompting-Tipps für GPT Image 2.6 Sunburst
Mit einem Limit von 32.000 Zeichen und räumlicher Vorab-Planung empfiehlt es sich, vollständige Aussagesätze genau in der Reihenfolge zu formulieren, in der die Szene aufgebaut werden soll:
- Motiv und Material zuerst: Nennen Sie das Hauptobjekt, seine Oberflächenbeschaffenheit und seine exakte Position im Bild ("frosted crystal prism centered on a dark obsidian mirror floor").
- Exakter Text in Anführungszeichen: Setzen Sie Beschilderungen, Blaupausen-Callouts oder UI-Überschriften in doppelte Anführungszeichen und geben Sie Schriftfamilie, Schriftschnitt und Ausrichtung an. Wählen Sie
high, xhigh oder max als Qualität, damit dichte mehrzeilige Laufweiten gestochen scharf bleiben.
- Bewegungshinweise für
output_format: "gif": Beschreiben Sie sowohl das ruhende Hauptmotiv als auch die zyklische Bewegung ("animated rising steam from a holographic bowl, flickering neon rain reflections, smooth looping multi-frame animation"), damit die Frame-Übergänge sauber loopen.
- Pfadgeometrie für
output_format: "svg": Verlangen Sie flache Vektorfüllungen, klare geometrische Bézier-Pfade und begrenzte Farbpaletten ("clean geometric vector emblem badge, crisp flat vector paths in gold, cyan, and obsidian navy") anstelle fotografischer Tiefenunschärfe.
Eine tiefere Analyse dazu, wie OpenAI- und Google-Modelle Prompt-Strukturen interpretieren, finden Sie in unserem Leitfaden zur Auswahl von Bildgeneratoren sowie in unserem Leitfaden für automatisierte Bildgenerierungs-Pipelines.
Häufig gestellte Fragen
Was kostet GPT Image 2.6 Sunburst text-to-image auf E2X?
Mit unserem Rabatt von 75 % kostet GPT Image 2.6 Sunburst $0.0525 pro Bild bei resolution: "1K" (Standard), $0.105 pro Bild bei resolution: "2K" und $0.1575 pro Bild bei resolution: "4K" – unabhängig davon, ob Sie die Qualitätsstufe low, medium, high, xhigh oder max bzw. das Ausgabeformat png, jpeg, webp, gif oder svg wählen.
Wie berechnet sich der Preis von $0.0525 aus dem Basispreis?
Der Listen-Basispreis beträgt $0.03 pro Anfrage, was durch unseren globalen Rabatt von 75 % auf $0.0075 gesenkt wird. Jede quality-Einstellung (low, medium, high, xhigh, max) wendet einen ×7-Multiplikator an ($0.0075 × 7 = $0.0525), und resolution multipliziert darauf aufbauend (1K = ×1, 2K = ×2, 4K = ×3).
Kostet ein Wechsel der Qualität von medium auf xhigh oder max mehr?
Nein. Alle fünf Qualitätsstufen (low, medium, high, xhigh, max) tragen auf E2X denselben ×7-Multiplikator. Das bedeutet, dass xhigh und max bei 1K exakt dieselben $0.0525 kosten wie low oder medium. Lediglich resolution (1K, 2K, 4K) verändert Ihren Preis pro Bild.
Wie generiere ich animierte GIFs und Vektor-SVGs mit GPT Image 2.6 Sunburst?
Übergeben Sie "output_format": "gif" in Ihrem Input-Payload, um ein gelooptes mehrbildiges animiertes GIF direkt aus Ihrem Text-Prompt zu generieren, oder übergeben Sie "output_format": "svg", um skalierbare XML-<svg>-Vektorpfadgrafiken zu erhalten. Standard-Rasterformate ("png", "jpeg", "webp") werden ebenfalls unterstützt, wobei "png" der Standardwert ist.
Was ist der Unterschied zwischen GPT Image 2.6 Sunburst und GPT Image 2.6 Flare?
Beide Varianten teilen dieselben Preise von $0.0525 (1K), $0.105 (2K) und $0.1575 (4K), 15 Seitenverhältnisse sowie die Ausgabeformate png/jpeg/webp/gif/svg. GPT Image 2.6 Sunburst ist das Reasoning-gestützte Flaggschiff mit fünf Qualitätsstufen (low, medium, high, xhigh, max) für komplexe Typografie und Makrodetails. GPT Image 2.6 Flare ist die Hochgeschwindigkeits-Produktionsvariante mit drei Qualitätsstufen (low, medium, high), die bis zu 2×–2.5× schneller läuft.
Welche Seitenverhältnisse unterstützt GPT Image 2.6 Sunburst?
Das Modell akzeptiert 15 feste Seitenverhältnisse mit 1:1 als Standardwert bei Weglassen: 1:1, 1:2, 2:1, 1:3, 3:1, 2:3, 3:2, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 9:21 und 21:9.
Wie hoch sind die maximale Prompt-Länge und das Limit für Referenzbilder?
Das Feld prompt akzeptiert bis zu 32.000 Zeichen unter openai/gpt-image-2.6-sunburst/text-to-image. Wenn Sie bis zu 50.000 Zeichen zusammen mit bis zu 16 Referenzbildern (image_urls) benötigen, nutzen Sie den Schwester-Endpunkt GPT Image 2.6 Sunburst edit-image.
 Bild
 openaiNeu