API OpenAI GPT Image 2.5 su E2X: qualità xhigh e max fino a 4K da $0.0525
GPT Image 2.5 di OpenAI è attivo sull'API di E2X attraverso due route: openai/gpt-image-2.5-sunburst/text-to-image per generare scene a partire da un prompt scritto e openai/gpt-image-2.5-sunburst/edit-image per modificare o comporre foto di partenza. Con il nostro sconto fisso del 75% applicato, una richiesta in 1K costa $0.0525, una richiesta in 2K costa $0.105 e una richiesta in 4K costa $0.1575.
Queste tariffe rimangono invariate per qualsiasi impostazione di quality nello schema. Su E2X, i nuovi livelli di qualità xhigh e max condividono esattamente lo stesso moltiplicatore ×7 di low, medium e high. Puoi eseguire ogni job a xhigh o max senza aggiungere un solo centesimo alla fattura.
Questa guida copre l'integrazione completa: come la tariffa base e i moltiplicatori determinano la fattura, lo schema di input completo per entrambe le route, codice di produzione in curl e TypeScript per polling e webhook, e i prompt esatti utilizzati per i render di esempio in questa pagina.
Come viene calcolato il prezzo di $0.0525
Comprendere la formula di fatturazione su E2X evita due errori comuni: pagare per la risoluzione 4K mentre si sta ancora testando la formulazione del prompt e abbassare quality per risparmiare quando quality non modifica il prezzo.
Sia openai/gpt-image-2.5-sunburst/text-to-image che openai/gpt-image-2.5-sunburst/edit-image condividono un prezzo base di listino pari a $0.03 (30,000 micro-centesimi nella risposta API). E2X applica uno sconto fisso del 75% a tale base, riducendo l'unità di partenza a $0.0075 (7,500 micro-centesimi). A partire da lì, il motore di fatturazione moltiplica per due fattori legati ai parametri:
- Il fattore
quality:low,medium,high(il valore predefinito dello schema),xhighemaxutilizzano ciascuno un moltiplicatore ×7. Moltiplicando$0.0075per7si ottiene$0.0525. - Il fattore
resolution:1K(il valore predefinito dello schema) applica ×1,2Kapplica ×2 e4Kapplica ×3.
Poiché tutti e cinque i valori di quality corrispondono allo stesso fattore ×7 nella tabella dei prezzi dinamici, resolution è l'unico parametro che varia il costo per immagine. Non vedrai mai un addebito non moltiplicato di $0.0075 su un job completato perché quality assume per impostazione predefinita il valore high (×7) ogni volta che lo ometti. E poiché xhigh e max condividono quello stesso fattore ×7, scendere a low o medium non fa risparmiare nulla. Imposta quality su high, xhigh o max in base alla densità visiva del tuo prompt e ignora low.
| Risoluzione | Formula del moltiplicatore | Tariffa di listino E2X ($0.03 × 7) | Tariffa E2X (sconto 75%) | Micro-centesimi API | fal.ai on-demand (livello high) | Risparmio E2X |
|---|---|---|---|---|---|---|
1K (predefinito) | $0.0075 × 7 × 1 | $0.21 | $0.0525 | 52500 | $0.211 | 75% |
2K | $0.0075 × 7 × 2 | $0.42 | $0.1050 | 105000 | $0.222 | 53% |
4K | $0.0075 × 7 × 3 | $0.63 | $0.1575 | 157500 | $0.401 | 61% |
Confronto tariffe verificato il 4 novembre 2026 rispetto ai prezzi on-demand di fal.ai. Le tariffe e le condizioni dei provider possono variare; consulta la nostra pagina dei prezzi per i valori aggiornati in tempo reale.
Per i team che eseguono cicli di progettazione iterativi, questa curva di moltiplicatori rende la gestione del budget immediata. Mantieni resolution bloccata su "1K" mentre perfezioni l'illuminazione, l'angolazione della fotocamera e il testo incorporato a "xhigh" o "max". Otto generazioni di bozza in 1K costano in totale $0.42. Una volta definito il layout, esegui un singolo render master in "4K" per $0.1575. L'intera sequenza di nove immagini costa $0.5775, rispetto a $1.4175 se ogni bozza fosse eseguita in 4K.
Nota la quinta colonna nella tabella qui sopra. Ogni campo monetario restituito dall'API di E2X è un numero intero in micro-centesimi, dove 1,000,000 di micro-centesimi equivalgono a $1.00 USD. Una generazione in 1K restituisce 52500, una generazione in 2K restituisce 105000 e una generazione in 4K restituisce 157500. Salva direttamente questi numeri interi nella tua tabella contabile e dividi per 1,000,000 solo quando formatti i numeri per una dashboard destinata agli utenti.
Schema completo dei parametri per entrambi gli endpoint
Entrambe le route di GPT Image 2.5 utilizzano il formato standard dei job E2X su POST https://api.e2x.ai/v1/jobs/submit. Passi l'identificatore del modello al livello principale del corpo JSON e inserisci tutti i controlli specifici del modello all'interno dell'oggetto input. Su E2X, GPT Image 2.5 è disponibile in due varianti: GPT Image 2.5 Sunburst (openai/gpt-image-2.5-sunburst, che supporta risoluzioni 1K/2K/4K e i livelli di qualità low, medium, high, xhigh, max) e GPT Image 2.5 Flare (openai/gpt-image-2.5-flare, che supporta /models/openai/gpt-image-2.5-flare/text-to-image e /models/openai/gpt-image-2.5-flare/edit-image con risoluzioni 1K/2K/4K e i livelli di qualità low, medium, high).
| Parametro | Disponibilità endpoint | Tipo | Obbligatorio | Predefinito | Valori accettati / limiti |
|---|---|---|---|---|---|
prompt | Entrambi gli endpoint | string | Sì | Nessuno | Fino a 32,000 caratteri su text-to-image; fino a 50,000 caratteri su edit-image. |
image_urls | Solo edit-image | string[] | Sì (in modifica) | Nessuno | URL HTTPS pubblicamente raggiungibili per condizionamento tramite riferimento, composizione o modifica. |
aspect_ratio | Entrambi gli endpoint | string | No | "1:1" | "auto", "1:1", "4:3", "3:4", "3:2", "2:3", "5:4", "4:5", "16:9", "9:16", "2:1", "1:2", "21:9", "9:21", "3:1", "1:3" (16 in totale). |
resolution | Entrambi gli endpoint | string | No | "1K" | "1K", "2K", "4K" (deve essere in maiuscolo). |
quality | Entrambi gli endpoint | string | No | "high" | "low", "medium", "high", "xhigh", "max". |
Tre dettagli dello schema meritano attenzione prima di scrivere il livello di validazione:
- Sui modelli OpenAI sono richieste stringhe
resolutionin maiuscolo. Passa"1K","2K"o"4K". Se il tuo codice chiama già modelli Google nel nostro catalogo text-to-image, dove le risoluzioni sono in minuscolo ("1k","2k","4k"), normalizza le maiuscole/minuscole per ciascuno slug del modello anziché condividere un'unica costante stringa. aspect_ratioha come valore predefinito"1:1"e supporta"auto". Quando omettiaspect_ratio, GPT Image 2.5 genera un'inquadratura quadrata. Quando passi esplicitamente"auto", il modello seleziona uno dei rapporti supportati in base al soggetto descritto nel prompt (oppure preserva l'inquadratura dell'immagine di riferimento principale suedit-image).- GPT Image 2.5 omette il parametro
background. Néopenai/gpt-image-2.5-sunburst/text-to-imagenéopenai/gpt-image-2.5-sunburst/edit-imageincludono il campobackground("transparent","opaque","auto"). Se il tuo flusso di lavoro richiede uno scontorno PNG trasparente con canale alfa in una singola chiamata, indirizza la richiesta aopenai/gpt-image-2/text-to-imageoopenai/gpt-image-2/edit-imageallo stesso prezzo di$0.0525. Analizziamo nel dettaglio questa scelta di routing nel nostro confronto tra GPT Image 2.5 e GPT Image 2.
Generare la prima immagine con curl
Poiché i job di GPT Image 2.5 richiedono in media circa 60 secondi, l'API di E2X è asincrona. La richiesta POST valida il payload, mette in coda il lavoro e restituisce immediatamente un jobId.
Ecco una richiesta curl completa che chiama openai/gpt-image-2.5-sunburst/text-to-image con risoluzione "1K" e qualità "xhigh" ($0.0525):
curl -X POST https://api.e2x.ai/v1/jobs/submit \
  -H "Authorization: Bearer $E2X_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.5-sunburst/text-to-image",
    "input": {
      "prompt": "Overhead editorial photograph of an anodized aluminum mechanical keyboard on a dark walnut desk. Keycaps in matte charcoal with a single signal orange Esc key. Soft north-window daylight from the top left, crisp key legends.",
      "aspect_ratio": "3:2",
      "resolution": "1K",
      "quality": "xhigh"
    }
  }'
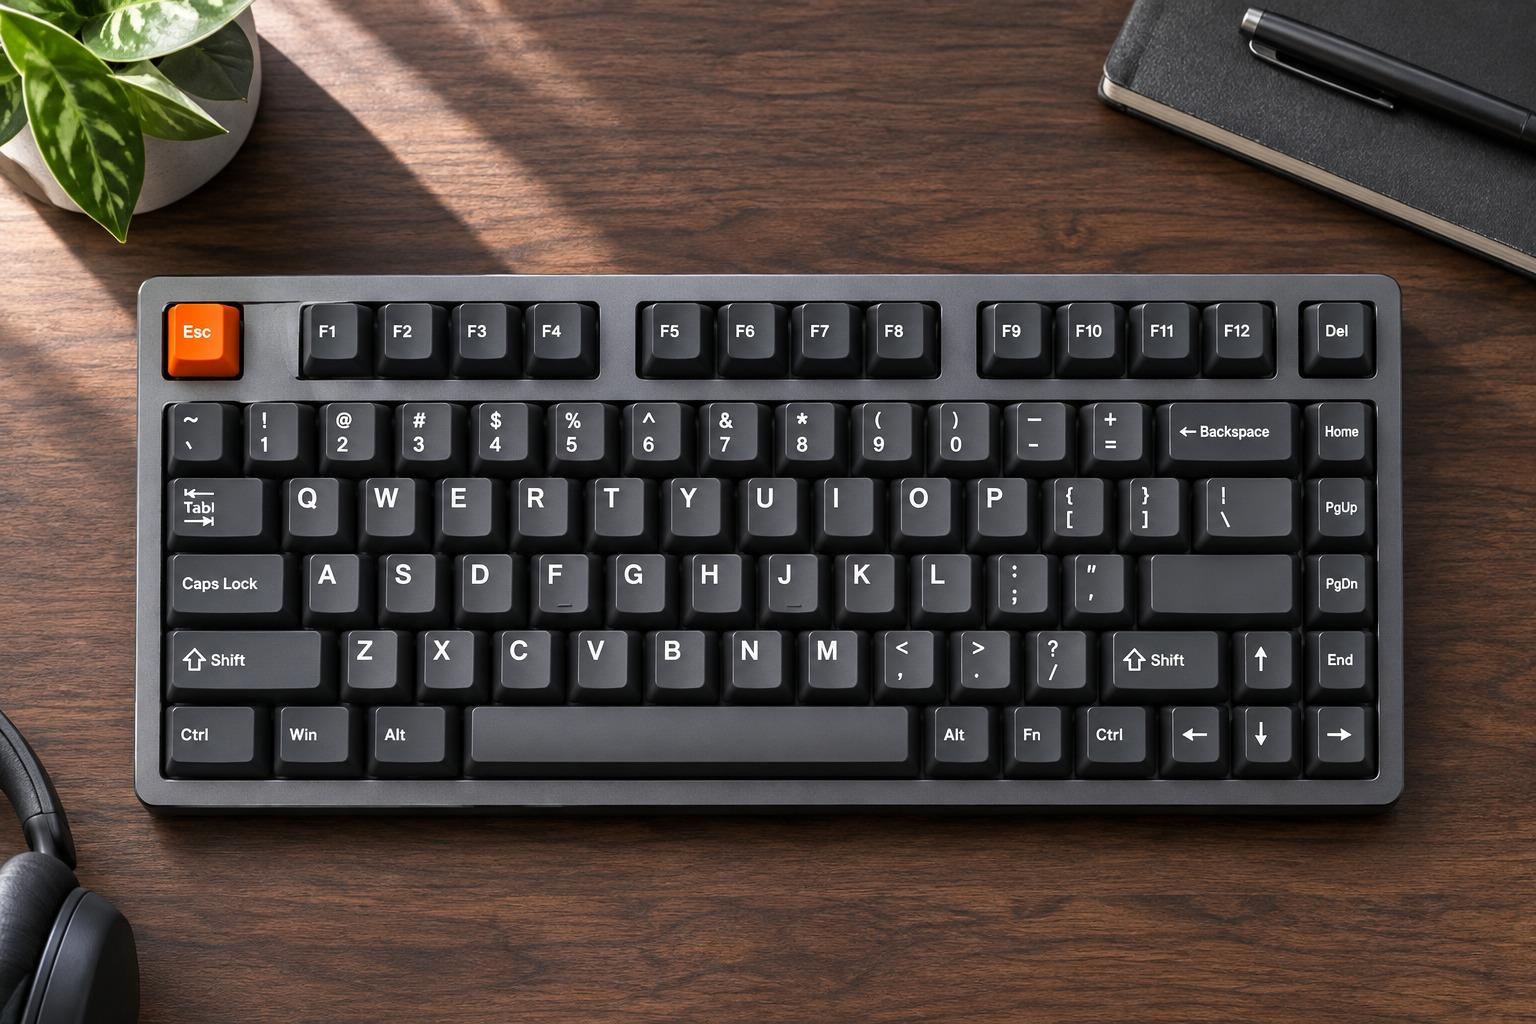
Prompt utilizzato per l'immagine qui sopra:
"Overhead editorial photograph of an anodized aluminum mechanical keyboard on a dark walnut desk. Keycaps in matte charcoal with a single signal orange Esc key. Soft north-window daylight from the top left, crisp key legends."
Perché questo prompt funziona bene a qualità "xhigh": le tastiere meccaniche sono uno stress test classico per i generatori di immagini, perché una spaziatura irregolare dei tasti, file deformate o scritte sfocate rovinano immediatamente lo scatto. Specificare un'inquadratura dall'alto (Overhead editorial photograph), indicare il materiale esatto della scocca (anodized aluminum), isolare un singolo accento di colore (single signal orange Esc key) e richiedere la qualità "xhigh" fornisce al modello un budget di campionamento sufficiente per mantenere dritta la griglia degli switch e nitide le scritte sui tasti.
Quando la chiamata di invio va a buon fine, l'API risponde con un 200 OK e un oggetto JSON contenente l'identificatore del job:
{
  "success": true,
  "data": {
    "jobId": "job_01J9X7K3M8P2Q4R6S8T0V2W4Y6",
    "status": "pending"
  }
}
Per controllare lo stato dal terminale, chiama GET https://api.e2x.ai/v1/jobs/{jobId} con lo stesso header Authorization:
curl -s https://api.e2x.ai/v1/jobs/job_01J9X7K3M8P2Q4R6S8T0V2W4Y6 \
  -H "Authorization: Bearer $E2X_API_KEY"
Quando data.status passa da pending a processing e infine a completed, l'URL dell'immagine completata si trova in data.outputs[0].url.
Tipografia e layout di poster alla qualità max
Uno dei motivi principali per passare da high a xhigh o max su GPT Image 2.5 è il rendering del testo all'interno di layout grafici strutturati. Poster, copertine di libri, fustelle di packaging e schede UI richiedono un allineamento rigoroso della linea di base e forme dei caratteri pulite.
Ecco il prompt e la configurazione dei parametri utilizzati per generare un poster espositivo in stile svizzero in formato 2:3 con risoluzione "2K" e qualità "max" ($0.105):
'Minimalist museum poster on textured cotton paper. Centered Swiss grid typography reading "ZURICH DESIGN WERKSCHAU 2026" in bold black grotesque type above a cobalt blue geometric arch.'
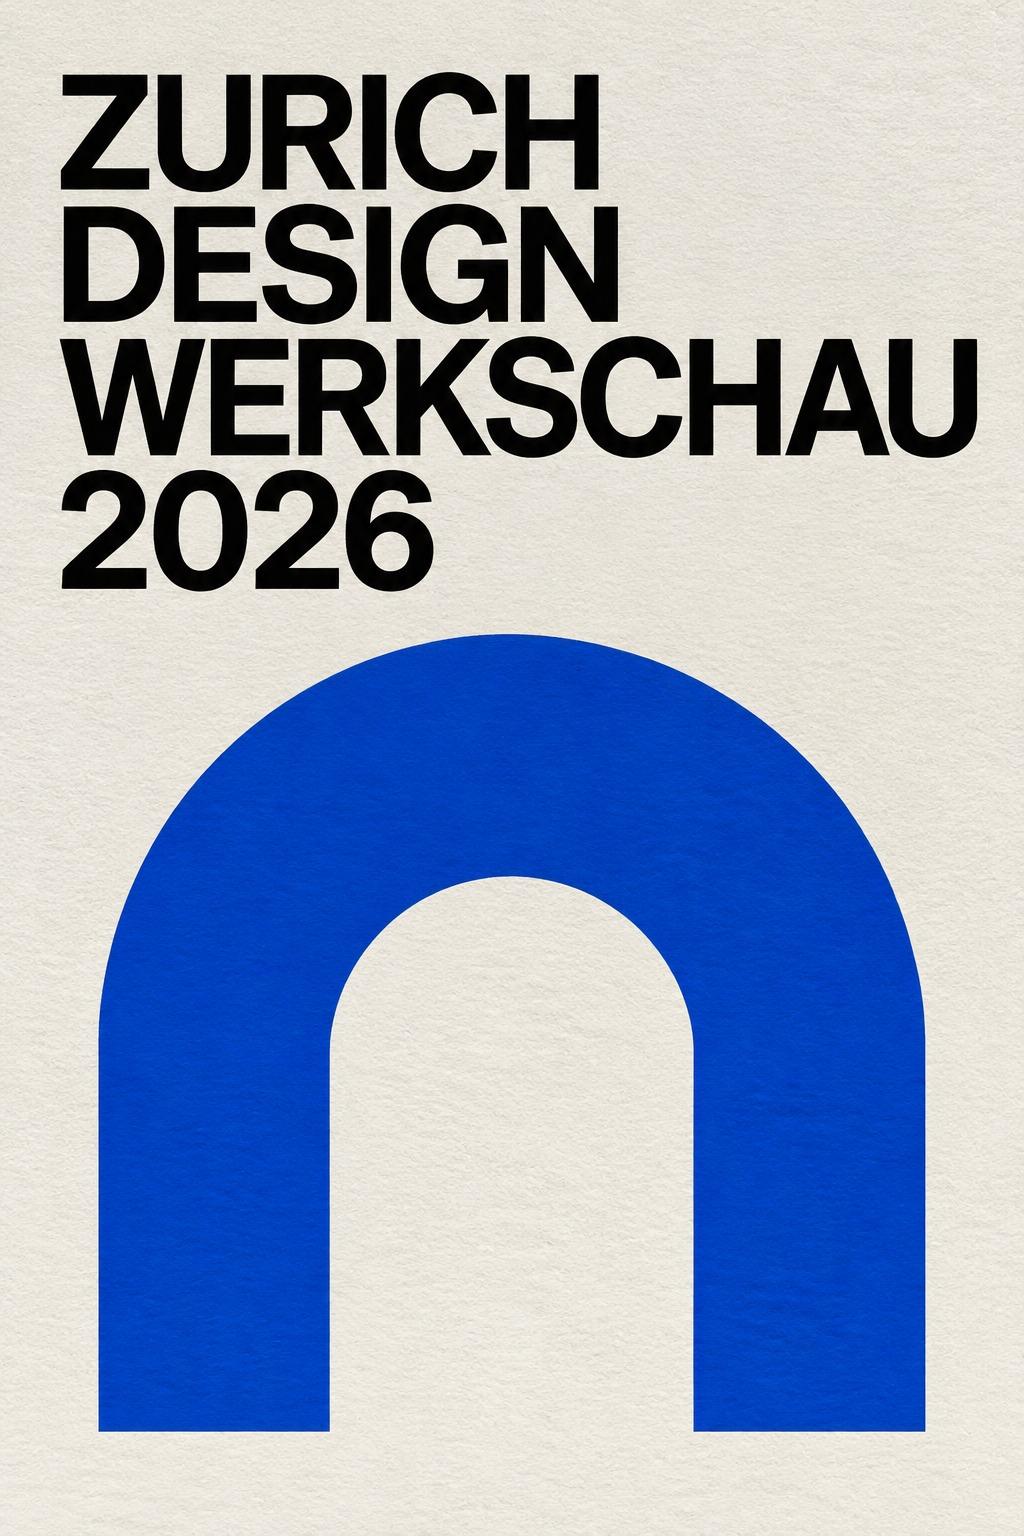
Tre regole pratiche rendono affidabile il testo all'interno delle immagini su GPT Image 2.5:
- Racchiudi la stringa esatta da visualizzare tra virgolette. Tutto ciò che si trova tra virgolette viene trattato come testo letterale da renderizzare sulla tela, mentre le parole circostanti descrivono il carattere tipografico (
bold black grotesque type), il supporto (textured cotton paper) e il posizionamento (Centered Swiss grid typography). - Usa
xhighomaxogni volta che il lettering è l'elemento centrale. Poiché E2X fatturamaxcon lo stesso moltiplicatore ×7 dihigh, richiedere"quality": "max"garantisce la crenatura più precisa e i bordi dei tratti più nitidi senza aumentare i costi. - Scegli fin da subito il rapporto d'aspetto finale. Un poster richiede
"2:3"o"3:4". Generare in"1:1"e ritagliare in seguito taglia fuori i margini da cui dipende il layout a griglia.
Integrazione TypeScript in produzione: polling e archiviazione
In un backend Node.js o TypeScript, la tua integrazione deve eseguire tre operazioni in modo pulito: inviare il job, effettuare il polling a una cadenza ragionevole (circa 3 secondi corrisponde all'intervallo di polling dei nostri worker) e copiare il file completato dall'URL di consegna temporaneo di E2X nel tuo bucket S3, R2 o GCS.
Non saltare il passaggio di download. L'URL restituito in data.outputs[0].url è un link di consegna a breve scadenza. Salvare direttamente quella stringa nel database della tua applicazione causerà immagini non funzionanti non appena l'oggetto di consegna scadrà.
import { writeFile, mkdir } from "node:fs/promises";
import path from "node:path";

const E2X_BASE_URL = "https://api.e2x.ai/v1";
const API_KEY = process.env.E2X_API_KEY;

if (!API_KEY) {
  throw new Error("Missing E2X_API_KEY environment variable");
}

type GptImageResolution = "1K" | "2K" | "4K";
type GptImageQuality = "low" | "medium" | "high" | "xhigh" | "max";

interface SubmitTextToImageInput {
  prompt: string;
  aspect_ratio?: string;
  resolution?: GptImageResolution;
  quality?: GptImageQuality;
  webhookUrl?: string;
}

const headers = {
  Authorization: `Bearer ${API_KEY}`,
  "Content-Type": "application/json",
};

export async function submitGptImage25(
  options: SubmitTextToImageInput
): Promise<string> {
  const { webhookUrl, ...input } = options;

  const response = await fetch(`${E2X_BASE_URL}/jobs/submit`, {
    method: "POST",
    headers,
    body: JSON.stringify({
      model: "openai/gpt-image-2.5-sunburst/text-to-image",
      input: {
        prompt: input.prompt,
        aspect_ratio: input.aspect_ratio ?? "2:3",
        resolution: input.resolution ?? "2K",
        quality: input.quality ?? "max",
      },
      ...(webhookUrl ? { webhookUrl } : {}),
    }),
  });

  if (!response.ok) {
    throw new Error(`Submit failed (${response.status}): ${await response.text()}`);
  }

  const payload = (await response.json()) as { data: { jobId: string } };
  return payload.data.jobId;
}

export async function pollUntilComplete(
  jobId: string,
  timeoutMs = 300_000
): Promise<string> {
  const deadline = Date.now() + timeoutMs;
  let delayMs = 3000;

  while (Date.now() < deadline) {
    await new Promise((resolve) => setTimeout(resolve, delayMs));

    const response = await fetch(`${E2X_BASE_URL}/jobs/${jobId}`, { headers });
    if (!response.ok) {
      throw new Error(`Status check failed with HTTP ${response.status}`);
    }

    const { data } = (await response.json()) as {
      data: {
        status: string;
        outputs?: Array<{ url: string }>;
        error?: { message?: string };
      };
    };

    if (data.status === "completed" && data.outputs?.[0]?.url) {
      return data.outputs[0].url;
    }
    if (data.status === "failed" || data.status === "cancelled") {
      throw new Error(data.error?.message ?? `Job ended in ${data.status}`);
    }

    delayMs = Math.min(Math.round(delayMs * 1.25), 8000);
  }

  throw new Error(`Timed out waiting for job ${jobId}`);
}

async function saveImage(url: string, destination: string): Promise<void> {
  const res = await fetch(url);
  if (!res.ok) throw new Error(`Download failed: HTTP ${res.status}`);
  await mkdir(path.dirname(destination), { recursive: true });
  await writeFile(destination, Buffer.from(await res.arrayBuffer()));
}
Se preferisci utilizzare un client già pronto invece di scrivere wrapper fetch manuali, consulta la pagina degli SDK E2X per i pacchetti ufficiali e gli esempi di configurazione.
Passare ai webhook per i carichi di lavoro batch
Entrambi gli endpoint di GPT Image 2.5 supportano un limite di concorrenza di 100 job attivi per account, insieme a limiti di frequenza di 100 chiamate al minuto, 5,000 chiamate all'ora e 50,000 chiamate al giorno. Quando esegui quasi 100 job in parallelo, mantenere aperti 100 cicli di polling in memoria blocca i processi worker e rende fragili i deployment.
Passare webhookUrl alla radice del corpo di /v1/jobs/submit elimina il ciclo di polling. Non appena il job raggiunge lo stato completed, failed o cancelled, E2X invia una notifica HTTP POST al tuo server:
curl -X POST https://api.e2x.ai/v1/jobs/submit \
  -H "Authorization: Bearer $E2X_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.5-sunburst/text-to-image",
    "input": {
      "prompt": "Overhead editorial photograph of an anodized aluminum mechanical keyboard on a dark walnut desk. Keycaps in matte charcoal with a single signal orange Esc key. Soft north-window daylight from the top left, crisp key legends.",
      "aspect_ratio": "3:2",
      "resolution": "1K",
      "quality": "xhigh"
    },
    "webhookUrl": "https://api.yourcompany.com/webhooks/e2x-image"
  }'
Nel tuo gestore del webhook, registra il jobId in arrivo, verifica lo stato chiamando GET /v1/jobs/{jobId} con la tua chiave API, scarica l'immagine da data.outputs[0].url nel tuo object storage permanente e contrassegna la riga del database come completata.
Modifica e composizione con openai/gpt-image-2.5-sunburst/edit-image
Quando hai già una foto di prodotto, un layout di packaging o un render architettonico e devi modificare regioni specifiche o combinare più riferimenti, cambia lo slug del modello in openai/gpt-image-2.5-sunburst/edit-image.
I prezzi corrispondono a quelli di text-to-image (1K costa $0.0525, 2K costa $0.105, 4K costa $0.1575), mentre cambiano due regole dello schema:
image_urlsè obbligatorio. Passa un array di uno o più URL HTTPS pubblicamente raggiungibili che puntano alle tue immagini sorgente.- Il limite massimo di
promptsale a 50,000 caratteri. Questo spazio aggiuntivo (rispetto ai 32,000 sutext-to-image) consente alle pipeline di catalogo automatizzate di passare trascrizioni OCR complete, rigorosi vincoli sui colori del brand e regole di posizionamento per singolo riferimento senza incorrere in errori di lunghezza.
Ecco una richiesta curl che passa due immagini sorgente in image_urls e le compone a risoluzione "1K" e qualità "max" ($0.0525):
curl -X POST https://api.e2x.ai/v1/jobs/submit \
  -H "Authorization: Bearer $E2X_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.5-sunburst/edit-image",
    "input": {
      "prompt": "Place the brushed titanium chronograph watch from image 1 onto the wet dark slate surface from image 2. Preserve the exact dial markings, hands, and bezel knurling from image 1, and match the cool cyan rim reflections from image 2.",
      "image_urls": [
        "https://your-cdn.example.com/catalog/chronograph-cutout.png",
        "https://your-cdn.example.com/backdrops/wet-slate-studio.jpg"
      ],
      "aspect_ratio": "1:1",
      "resolution": "1K",
      "quality": "max"
    }
  }'
Quando scrivi prompt per edit-image, indica esplicitamente cosa deve cambiare e cosa deve rimanere bloccato, e fai riferimento ai tuoi input in base alla loro posizione a partire da 1 in image_urls (image 1, image 2). Approfondiamo l'indicizzazione multi-immagine, la sostituzione delle etichette di packaging e i template di prompt da 50K nella nostra guida alla modifica multi-immagine con GPT Image 2.5.
Come si inserisce GPT Image 2.5 nel catalogo modelli di E2X
Puoi esplorare tutti i modelli di immagine che ospitiamo nel catalogo modelli di E2X oppure filtrare specificamente per la categoria text-to-image e la categoria image-to-image. Poiché ogni modello su E2X condivide lo stesso contratto /v1/jobs/submit, passare dai modelli OpenAI a quelli Google richiede solo la modifica della stringa model e l'adeguamento di maiuscole/minuscole in resolution.
- Scegli GPT Image 2.5 (
1Ka$0.0525,4Ka$0.1575) quando desideri la fedeltà al prompt e la resa tipografica di OpenAI abbinate ai livelli di qualitàxhighomaxeaspect_ratio: "auto". - Scegli GPT Image 2 (
1Ka$0.0525,4Ka$0.1575) quando la tua pipeline richiede scontorni PNG nativi con canale alfa tramitebackground: "transparent". - Scegli Google Nano Banana 2.1 (
1Ka$0.03,2Ka$0.04,4Ka$0.09) quando hai bisogno del prezzo di generazione 4K più basso su E2X o di rapporti panoramici estremi come8:1e1:8. - Scegli Google Nano Banana Pro (
1K/2Ka$0.075,4Ka$0.15) quando hai bisogno di coerenza dei personaggi multi-riferimento separati per ruolo.
Domande frequenti
Perché xhigh e max costano quanto low e high su E2X?
Nello schema tariffario di E2X per openai/gpt-image-2.5-sunburst/text-to-image e openai/gpt-image-2.5-sunburst/edit-image, tutti e cinque i valori di quality (low, medium, high, xhigh, max) applicano lo stesso moltiplicatore ×7 al costo base scontato di $0.0075. Questo ti garantisce $0.0525 (1K), $0.105 (2K) e $0.1575 (4K) con qualsiasi impostazione di qualità.
Qual è la differenza tra gli endpoint text-to-image ed edit-image?
openai/gpt-image-2.5-sunburst/text-to-image genera nuove immagini esclusivamente a partire da un prompt testuale (limite di 32,000 caratteri). openai/gpt-image-2.5-sunburst/edit-image richiede sia prompt (limite di 50,000 caratteri) sia image_urls (URL delle immagini sorgente) per modificare, ridefinire lo stile o comporre elementi visivi esistenti. Entrambi gli endpoint condividono esattamente gli stessi prezzi e limiti di frequenza.