Come scrivere prompt per GPT Image 2.5: tipografia, spazio negativo e scelta tra high, xhigh o max
La maggior parte dei prompt inefficaci inviati a GPT Image 2.5 text-to-image fallisce per lo stesso motivo: sono scritti per i modelli di diffusione del 2022 anziché per un'architettura condizionata dal linguaggio del 2026. Quando inserisci parole chiave separate da virgole ("coffee dripper, 8k, hyperrealistic, octane render, studio lighting, award winning") in un endpoint che accetta 32,000 caratteri di linguaggio naturale, lasci il 90% delle decisioni spaziali dell'inquadratura al caso statistico.
GPT Image 2.5 non ha bisogno di aggettivi sulla qualità. Ha bisogno di un brief spaziale chiaro scritto con frasi dichiarative complete, abbinato alle giuste impostazioni dello schema (aspect_ratio, resolution e quality: high, xhigh o max). E quando passi da /models/openai/gpt-image-2.5-sunburst/text-to-image a /models/openai/gpt-image-2.5-sunburst/edit-image, le regole si invertono: ridescrivere l'intera scena in una chiamata di modifica provoca alterazioni indesiderate, mentre un prompt delta mirato blocca l'immagine di riferimento esattamente al suo posto.
Di seguito trovi l'esatta struttura del prompt in quattro parti che utilizziamo nelle pipeline di produzione su E2X, completa di riscritture prima e dopo, regole di formattazione tipografica, riserva dello spazio negativo e una guida pratica per scegliere tra high, xhigh e max considerando che tutti e cinque i livelli di qualità costano gli stessi $0.0525 a 1K.
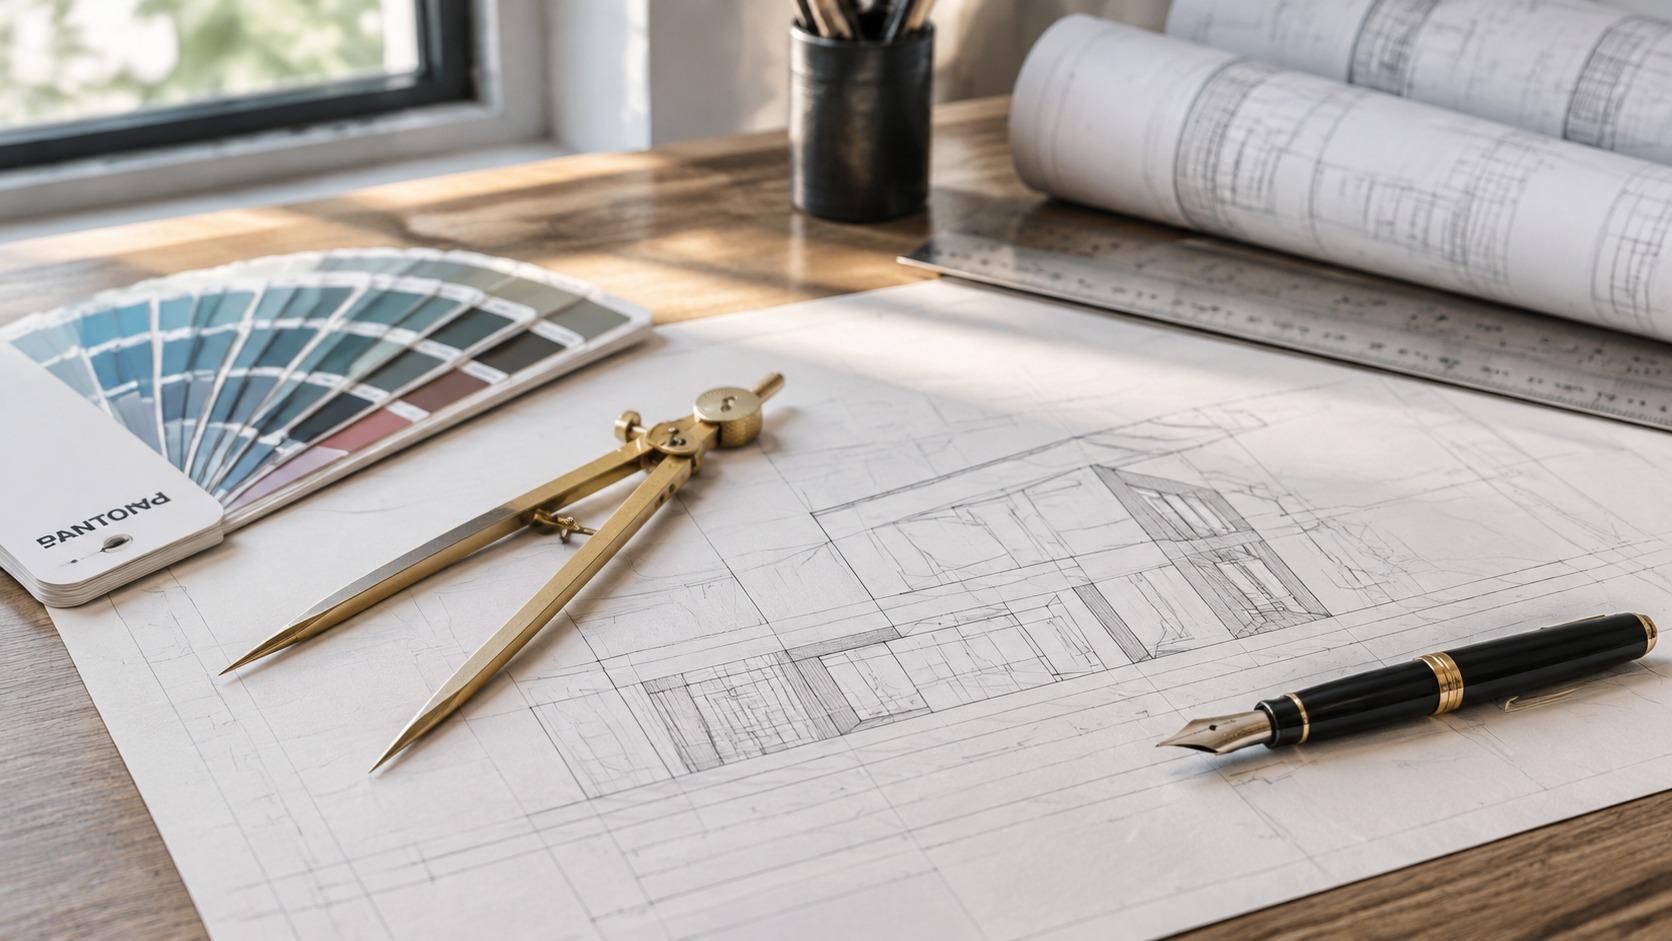
La struttura della frase in 4 parti che GPT Image 2.5 segue meglio
Con un limite di 32,000 caratteri su GPT Image 2.5 text-to-image e 50,000 caratteri su GPT Image 2.5 edit-image, non hai mai bisogno di comprimere le istruzioni in frammenti telegrafici. Scrivi frasi complete nell'esatta sequenza in cui desideri che venga costruita la tela. Le prime proposizioni ancorano la geometria della fotocamera e l'oggetto principale; le proposizioni successive rifiniscono l'illuminazione, la tipografia e i margini vuoti.
Segui questo ordine in quattro parti:
- Soggetto + materiale + posizione: Indica il mezzo e l'oggetto principale, la sua finitura superficiale tattile e dove si colloca nell'inquadratura (
"Matte ceramic pour-over coffee dripper centered on a brushed steel digital scale on a pale ash wood counter"). - Fonte di luce fisica + direzione: Specifica cosa genera la luce, da quale angolazione proviene e come cadono le ombre (
"afternoon sunlight from camera left casting sharp shadows across the brackets"). - Testo tra virgolette + trattamento del font e della superficie: Quando l'inquadratura include insegne, etichette o elementi UI, racchiudi i caratteri esatti tra doppie virgolette e descrivi lo stile dei caratteri e il supporto materiale (
"crisp white sans-serif lettering reading \"PLATFORM 4 — EXPRESS TO GENEVA\" on deep Prussian blue enamel"). - Riserva esplicita dello spazio negativo: Indica al modello quale terzo o metà della tela deve rimanere vuoto affinché il team di design possa sovrapporre testi HTML o Figma in un secondo momento (
"Keep the right third of the frame an uncluttered warm plaster wall for headline copy").
Prima e dopo: elenco di parole chiave contro brief spaziale dichiarativo
Confronta cosa succede quando sostituisci un elenco generico di tag con la struttura della frase in quattro parti in tre comuni attività commerciali.
Attività 1: Hero banner e-commerce con spazio per il testo
Weak prompt (keyword soup):
pour-over coffee maker, digital scale, minimalist kitchen, copy space on right,
product photography, 8k, photorealistic, soft lighting, clean background
Strong prompt (declarative brief):
Matte ceramic pour-over coffee dripper centered on a brushed steel digital scale on a pale ash wood counter. Keep the right third of the frame an uncluttered warm plaster wall for headline copy.
Perché la riscrittura funziona: "copy space on right" all'interno di un elenco separato da virgole raramente impedisce a un modello di immagine di aggiungere una mensola, una pianta o l'infisso di una finestra in quell'angolo. Nominare il materiale esatto della regione vuota ("an uncluttered warm plaster wall") fornisce al modello una superficie concreta da renderizzare lungo il terzo destro della tela.
Attività 2: Insegna architettonica con testo incorporato
Weak prompt (unquoted text and vague style):
vintage blue train station sign that says platform 4 express to geneva,
retro typography, brass brackets, sunny day, ultra detailed
Strong prompt (exact quotes and surface physics):
Vintage enamel railway station platform sign in deep Prussian blue with crisp white sans-serif lettering reading "PLATFORM 4 — EXPRESS TO GENEVA", weathered brass mounting brackets, afternoon sunlight.
Perché la riscrittura funziona: Lasciare le parole target in minuscolo e senza virgolette (says platform 4 express to geneva) spinge il modello a parafrasare, omettere la punteggiatura o inventare nomi di stazioni aggiuntivi. Racchiudere "PLATFORM 4 — EXPRESS TO GENEVA" tra doppie virgolette e specificare "crisp white sans-serif lettering" blocca sia le maiuscole sia la geometria dei glifi.
Attività 3: Layout da tavolo con più oggetti
Weak prompt (flat inventory list):
desk flatlay with anodized keyboard, walnut desk, orange escape key,
notebook, brass pen, daylight, sharp legends
Strong prompt (spatial hierarchy):
Overhead editorial photograph of an anodized aluminum mechanical keyboard centered on a dark walnut desk. Keycaps in matte charcoal with a single signal-orange Esc key at the top left corner of the board. Closed cream linen notebook resting parallel to the right edge of the keyboard, brass fountain pen centered on the cover. Soft north-window daylight from the upper left, crisp key legends, no other props.
Perché la riscrittura funziona: Ogni oggetto secondario è ancorato rispetto al soggetto principale ("at the top left corner of the board", "parallel to the right edge"), evitando geometrie sovrapposte.
Riservare spazio negativo per titoli e sovrapposizioni UI
Uno degli errori più costosi nelle pipeline automatizzate per annunci e landing page è generare una composizione quadrata centrata in 16:9 sperando che uno sviluppatore frontend possa posizionare del testo bianco sopra il margine sinistro o destro. A meno che tu non rivendichi lo spazio vuoto nel prompt, GPT Image 2.5 riempirà l'intera larghezza dell'inquadratura con oggetti di scena secondari, elementi sfocati sullo sfondo o gradienti d'ombra marcati che compromettono il contrasto del testo.
Ecco il prompt del dripper per caffè pour-over renderizzato su GPT Image 2.5, che dimostra come risponde il modello quando assegni esplicitamente una superficie muraria al terzo destro dell'inquadratura:
Matte ceramic pour-over coffee dripper centered on a brushed steel digital scale on a pale ash wood counter. Keep the right third of the frame an uncluttered warm plaster wall for headline copy.
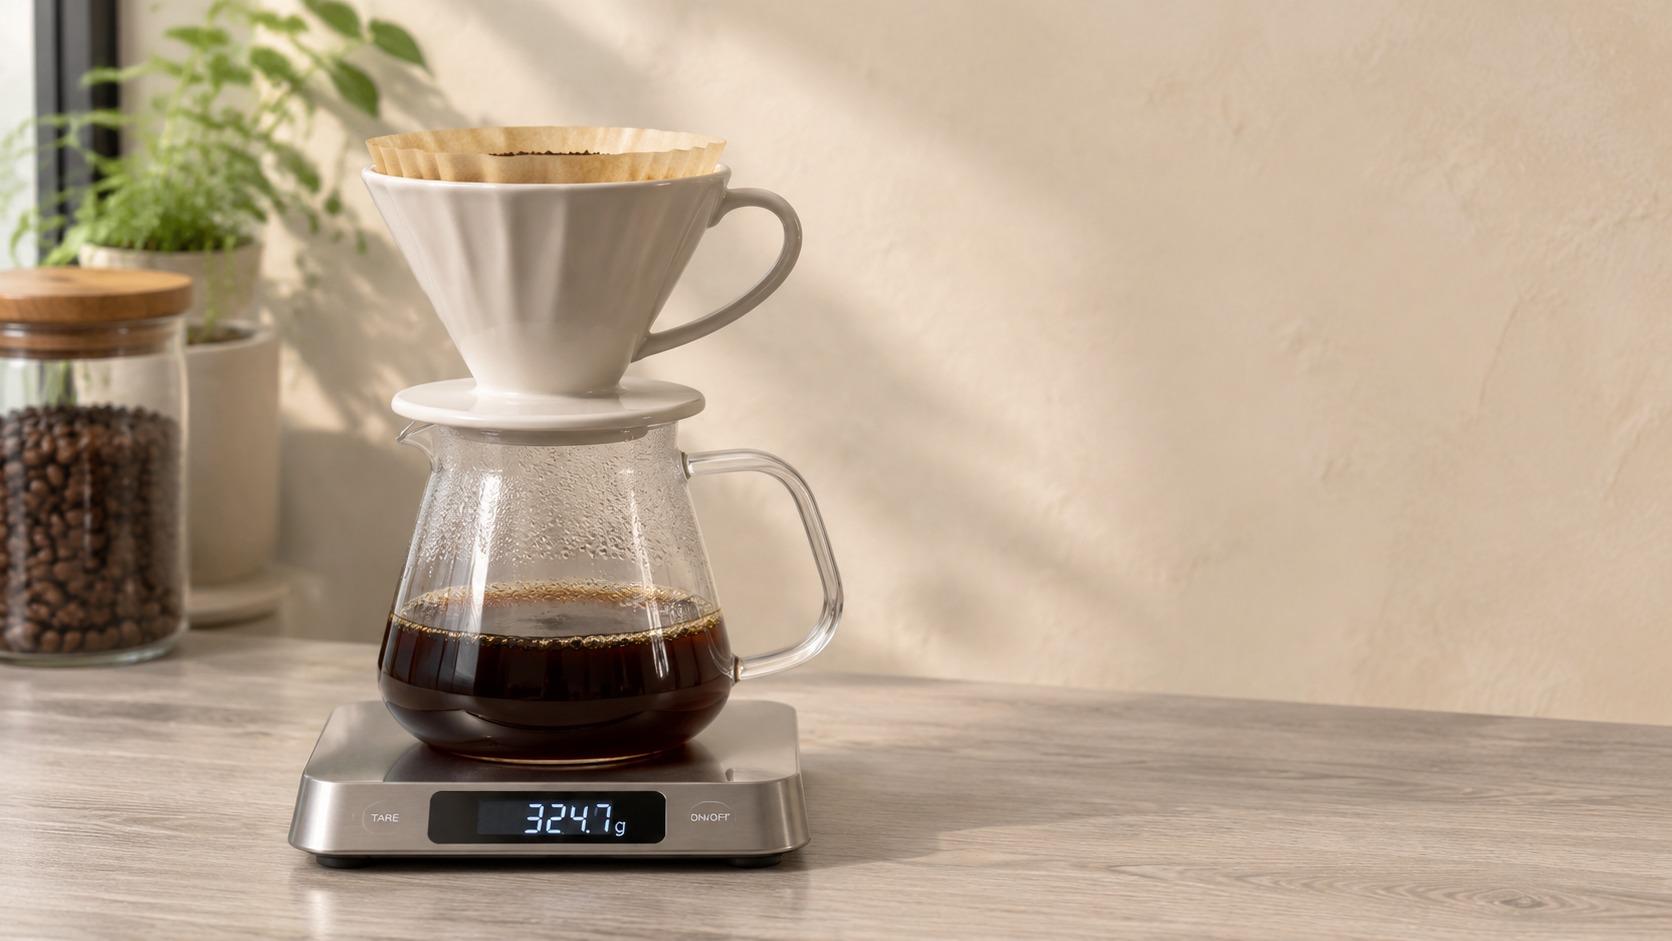
Osserva come la scena si divide lungo l'asse orizzontale:
- Le nervature in ceramica opaca del dripper e il piatto di pesatura in acciaio spazzolato occupano la zona sinistra e centro-sinistra senza essere tagliati dal bordo dell'inquadratura.
- Il bancone in legno di frassino chiaro prosegue con pulizia fino al bordo destro, radicando la scena in modo che non sembri un collage a schermo diviso incollato a posteriori.
- La zona in alto a destra rimane una superficie uniforme di intonaco caldo con una morbida sfumatura tonale, pronta ad accogliere tipografia HTML scura con o senza grazie senza bisogno di un riquadro scuro semitrasparente dietro le parole.
Quando scrivi istruzioni per lo spazio negativo, abbina sempre la frazione spaziale ("the right third", "the upper quarter", "the left half") allo specifico materiale di sfondo che deve occuparla ("uncluttered warm plaster wall", "clear pale overcast sky", "seamless slate-gray studio sweep"). Dire a un modello cosa c'è nello spazio vuoto funziona in modo molto più affidabile rispetto a dire semplicemente "leave empty space".
Citare il testo esatto e controllare la tipografia sulle superfici
GPT Image 2.5 è il modello più solido nel catalogo E2X per il rendering di insegne con più parole, etichette di packaging, copertine di libri e schede UI. Per ottenere scritte pulite al primo passaggio, segui quattro regole meccaniche ogni volta che il tuo prompt contiene del testo:
- Racchiudi sempre i caratteri esatti tra doppie virgolette: Scrivi
"PLATFORM 4 — EXPRESS TO GENEVA"esattamente nella forma maiuscola o mista che desideri visualizzare. - Descrivi il carattere tipografico per famiglia visiva e peso, non tramite file di font proprietari: Usa descrittori come
"condensed bold grotesque sans-serif","high-contrast editorial Didone serif"o"hand-painted gold leaf sign-painter capitals". - Specifica come il testo aderisce al materiale fisico: Indica se le lettere sono
"screen-printed in matte black ink","stamped in recessed gold foil","enameled white on Prussian blue steel"o"backlit acrylic channel letters". - Previeni scritte casuali incomprensibili sullo sfondo: Se la scena include vetrine, barattoli o libri sullo sfondo che non devono riportare parole inventate a caso, chiudi il prompt con
"no other text or logos in the frame".
Ecco il prompt dell'insegna ferroviaria generato su GPT Image 2.5 utilizzando esattamente queste regole:
Vintage enamel railway station platform sign in deep Prussian blue with crisp white sans-serif lettering reading "PLATFORM 4 — EXPRESS TO GENEVA", weathered brass mounting brackets, afternoon sunlight.
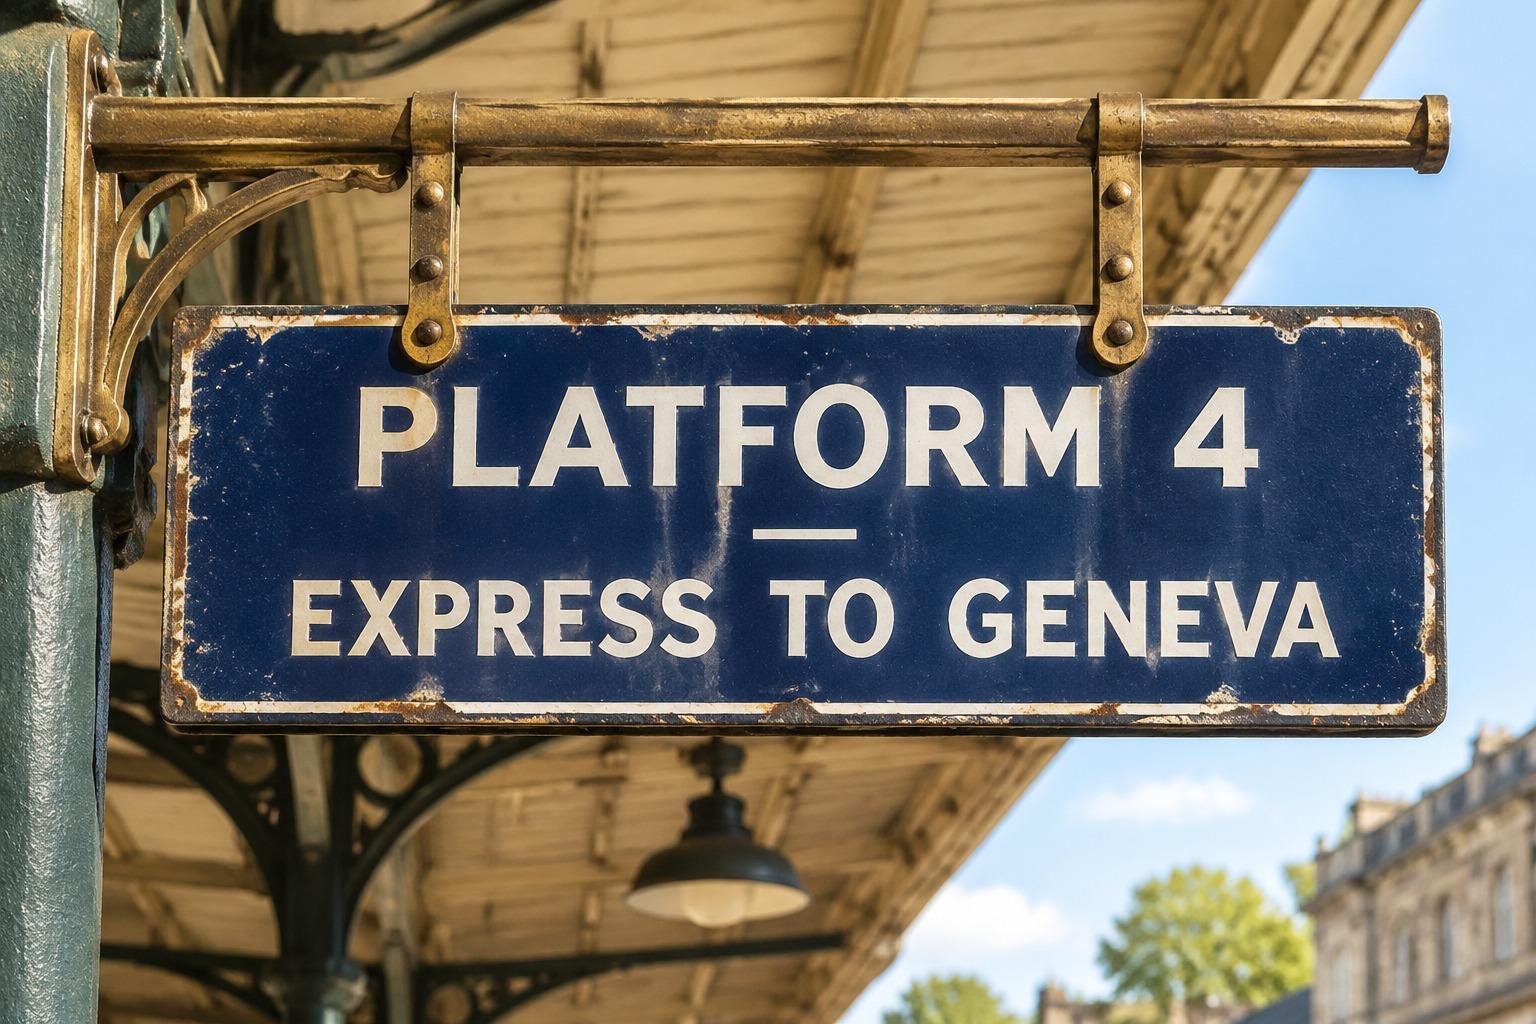
In questo output, il modello preserva la spaziatura attorno al segno di punteggiatura tra PLATFORM 4 ed EXPRESS TO GENEVA, mantiene uniforme lo spessore del tratto bianco sans-serif lungo l'intera targa orizzontale e restituisce sottili riflessi speculari del sole pomeridiano sia sullo smalto blu sia sulle lettere dipinte di bianco. Nel frattempo, le staffe di montaggio in ottone invecchiato agli angoli mostrano dettagli di ossidazione e bulloni senza invadere il bordo interno dell'insegna.
Scegliere tra qualità high, xhigh e max su E2X
Su /models/openai/gpt-image-2.5-sunburst/text-to-image e /models/openai/gpt-image-2.5-sunburst/edit-image, il parametro quality accetta cinque valori: low, medium, high (il valore predefinito dello schema quando omesso), xhigh e max. Su E2X, GPT Image 2.5 è disponibile in due varianti: GPT Image 2.5 Sunburst (openai/gpt-image-2.5-sunburst, che supporta risoluzioni 1K/2K/4K e i livelli di qualità low, medium, high, xhigh, max) e GPT Image 2.5 Flare (openai/gpt-image-2.5-flare, che supporta /models/openai/gpt-image-2.5-flare/text-to-image e /models/openai/gpt-image-2.5-flare/edit-image con risoluzioni 1K/2K/4K e i livelli di qualità low, medium, high).
Prima di decidere quale impostazione passare, è utile capire come E2X tariffa questo parametro. Ogni chiamata parte da una tariffa base di listino di $0.03, che il nostro sconto fisso del 75% riduce a $0.0075. Da lì:
- Ogni impostazione di
quality(low,medium,high,xhighemax) applica esattamente lo stesso moltiplicatore ×7. resolutionapplica un moltiplicatore ×1 a1K($0.0525), ×2 a2K($0.1050) e ×3 a4K($0.1575).
I prezzi e i termini dei prodotti possono variare. Verifica i prezzi correnti di ciascun fornitore prima di prendere una decisione d'acquisto. I prezzi Google Batch o Flex non sono direttamente equivalenti a una richiesta API standard on-demand poiché le condizioni di pianificazione, disponibilità ed elaborazione differiscono; pertanto sono esclusi da questo confronto. Questo è un confronto circoscritto, non un'affermazione che E2X sia l'opzione più economica al mondo in ogni configurazione.
Poiché low, high, xhigh e max costano tutti esattamente gli stessi $0.0525 a 1K ($0.105 a 2K, $0.1575 a 4K), non c'è alcun motivo economico per inviare low o medium. Il vero compromesso ingegneristico tra high, xhigh e max riguarda la latenza di inferenza rispetto alla rifinitura dei dettagli fini:
| Impostazione qualità | Prezzo 1K su E2X | Prezzo 4K su E2X | Caso d'uso ideale |
|---|---|---|---|
high (predefinito) | $0.0525 | $0.1575 | Anteprime interattive veloci, scatti prodotto a soggetto singolo, sfondi puliti con spazio negativo |
xhigh | $0.0525 | $0.1575 | Insegne di negozi, etichette di flaconi cosmetici, composizioni da tavolo multi-oggetto, ritratti con trame fini di pelle o tessuto |
max | $0.0525 | $0.1575 | Poster densi su più righe, sezioni trasversali meccaniche o architettoniche dettagliate, rendering master finali in 2K/4K |
In pratica, usa quality: "high" con resolution: "1K" quando un utente è in attesa interattiva su una tela UI e il prompt non contiene testo a corpo piccolo. Usa quality: "xhigh" a 1K ($0.0525) ogni volta che il prompt include tipografia tra virgolette o più oggetti che interagiscono tra loro. Passa a quality: "max" a 2K ($0.105) o 4K ($0.1575) quando renderizzi il master di produzione finale in una coda di worker in background.
Delta prompting per edit-image contro prompting a scena intera per text-to-image
Scrivere prompt per GPT Image 2.5 edit-image richiede un modello mentale diverso rispetto a text-to-image. Quando passi una o più immagini sorgente in image_urls, la scena visiva esiste già. Se il tuo prompt ridescrive da zero l'intera stanza, l'illuminazione e l'obiettivo della fotocamera, il modello tratta quelle frasi come istruzioni per rigenerare tali regioni, introducendo sottili derive nei volti, nelle texture o nella prospettiva.
Scrivi un prompt edit-image come un delta rigoroso composto da tre elementi:
- Indicizza esplicitamente le immagini sorgente: Quando passi più URL in
image_urls, fai riferimento ad essi come"image 1","image 2"e"image 3". - Indica la modifica esatta: Descrivi solo l'elemento che cambia, includendo il testo sostitutivo tra virgolette se stai aggiornando un'insegna o un'etichetta.
- Blocca tutto il resto: Elenca esplicitamente gli elementi circostanti che devono rimanere invariati.
Confronta un prompt a scena intera per text-to-image con il relativo prompt delta per edit-image:
Full-scene prompt (for openai/gpt-image-2.5-sunburst/text-to-image):
Vintage enamel railway station platform sign in deep Prussian blue with crisp white sans-serif lettering reading "PLATFORM 4 — EXPRESS TO GENEVA", weathered brass mounting brackets, afternoon sunlight.
Delta edit prompt (for openai/gpt-image-2.5-sunburst/edit-image):
In image 1, change the white sans-serif lettering on the Prussian blue enamel sign to read "PLATFORM 9 — NIGHT TRAIN TO MILAN" in the exact same font weight, kerning, and enamel surface gloss. Keep the weathered brass mounting brackets, afternoon sunlight angle, and background masonry completely unchanged.
Invia questa chiamata di modifica delta tramite POST https://api.e2x.ai/v1/jobs/submit, mantenendo aspect_ratio: "auto" affinché l'output rispetti le dimensioni dell'immagine in ingresso:
curl -X POST https://api.e2x.ai/v1/jobs/submit \
  -H "Authorization: Bearer $E2X_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.5-sunburst/edit-image",
    "input": {
      "prompt": "In image 1, change the white sans-serif lettering on the Prussian blue enamel sign to read \"PLATFORM 9 — NIGHT TRAIN TO MILAN\" in the exact same font weight, kerning, and enamel surface gloss. Keep the weathered brass mounting brackets, afternoon sunlight angle, and background masonry completely unchanged.",
      "image_urls": [
        "https://assets.e2x.ai/assets/posts/gpt-image-2-5-prompting-guide/example-2.jpg"
      ],
      "aspect_ratio": "auto",
      "resolution": "2K",
      "quality": "max"
    }
  }'
Ricorda due regole dello schema quando ti sposti tra generazione e modifica su E2X:
openai/gpt-image-2.5-sunburst/edit-imageaccetta prompt fino a 50,000 caratteri (rispetto ai 32,000 sutext-to-image), quindi gli script di localizzazione automatizzati possono passare regole di layout complete senza troncamenti.- Nessuno dei due endpoint GPT Image 2.5 include
background: "transparent". Se uno scontorno di prodotto richiede un canale alfa in una singola chiamata API, indirizza quel job a GPT Image 2 text-to-image o GPT Image 2 edit-image allo stesso prezzo di $0.0525 (1K).
Per benchmark diretti tra modelli, leggi i nostri confronti GPT Image 2.5 vs Nano Banana 2.1 e GPT Image 2.5 vs FLUX.2 Pro e Max, oppure consulta la nostra guida al prompting per Nano Banana. Puoi anche ispezionare gli schemi completi dei parametri nella specifica llms.txt per text-to-image e nella specifica llms.txt per edit-image, o esplorare tutti i modelli nel catalogo E2X.
Domande frequenti
Qual è il miglior ordine delle frasi per un prompt di GPT Image 2.5?
Inizia con il soggetto principale, la sua finitura materiale e la sua posizione nell'inquadratura. Prosegui con la fonte di luce fisica e la direzione delle ombre, poi specifica eventuali testi esatti nell'immagine racchiusi tra doppie virgolette insieme al relativo font e trattamento superficiale, e concludi riservando uno spazio negativo esplicito (nominando sia la regione dell'inquadratura sia la superficie di sfondo sgombra).
Perché GPT Image 2.5 sbaglia a scrivere le parole quando non uso le virgolette?
Quando le parole target sono scritte nel testo senza virgolette, il livello di condizionamento linguistico può trattarle come descrizioni tematiche anziché come stringhe letterali di caratteri. Racchiudere la stringa esatta tra doppie virgolette (reading "PLATFORM 4 — EXPRESS TO GENEVA"), nominare lo stile del font ("crisp white sans-serif lettering") e impostare quality su xhigh o max istruisce il modello a renderizzare esattamente quei glifi.
Dovrei usare sempre la qualità max su GPT Image 2.5 visto che costa quanto high?
Su E2X, low, medium, high, xhigh e max applicano tutti lo stesso moltiplicatore ×7 ($0.0525 a 1K, $0.105 a 2K, $0.1575 a 4K). Usa xhigh o max ogni volta che il prompt contiene tipografia incorporata, texture sottili di pelle o tessuto o vincoli spaziali con più oggetti. Mantieni high quando desideri tempi di risposta più rapidi su bozze semplici a soggetto singolo o fondali puliti.
Come faccio a riservare uno spazio pulito per le sovrapposizioni di testo HTML?
Specifica sia la frazione dell'inquadratura sia l'esatta superficie fisica che deve riempire quella zona vuota, ad esempio "Keep the right third of the frame an uncluttered warm plaster wall for headline copy" oppure "Keep the upper half a clear pale overcast sky with no clouds or objects". Nominare la superficie impedisce al modello di riempire lo spazio con oggetti di scena casuali sullo sfondo.
In cosa deve differire un prompt edit-image da un prompt text-to-image?
Per /models/openai/gpt-image-2.5-sunburst/text-to-image, descrivi l'intera scena da zero (fino a 32,000 caratteri). Per /models/openai/gpt-image-2.5-sunburst/edit-image (fino a 50,000 caratteri), scrivi solo il delta: fai riferimento al file di input tramite numero ("In image 1..."), indica l'elemento esatto o il testo tra virgolette che cambia e istruisci esplicitamente il modello a mantenere invariati tutti gli altri oggetti, l'illuminazione e l'angolazione della fotocamera.