Como criar prompts para o GPT Image 2.5: tipografia, espaço negativo e escolha entre high, xhigh ou max
A maioria dos prompts problemáticos enviados ao GPT Image 2.5 text-to-image falha pelo mesmo motivo: eles são escritos para modelos de difusão de 2022 em vez de uma arquitetura condicionada por linguagem de 2026. Quando você envia palavras da moda separadas por vírgulas ("coffee dripper, 8k, hyperrealistic, octane render, studio lighting, award winning") para um endpoint que aceita 32,000 caracteres de linguagem natural, você deixa 90% das decisões espaciais do quadro para o acaso estatístico.
O GPT Image 2.5 não precisa de adjetivos de qualidade. Ele precisa de um briefing espacial claro escrito em frases declarativas completas, combinado com as configurações corretas de esquema (aspect_ratio, resolution e quality: high, xhigh ou max). E quando você muda de /models/openai/gpt-image-2.5-sunburst/text-to-image para /models/openai/gpt-image-2.5-sunburst/edit-image, as regras se invertem: redescrever a cena inteira em uma chamada de edição causa desvios indesejados, enquanto um prompt delta enxuto trava sua imagem de referência no lugar.
Abaixo está a estrutura exata de prompt em quatro partes que usamos nos pipelines de produção na E2X, completa com reescritas de antes e depois, regras de formatação tipográfica, reserva de espaço negativo e um guia prático para escolher entre high, xhigh e max quando todos os cinco níveis de qualidade custam os mesmos $0.0525 em 1K.
A estrutura de frases em 4 partes que o GPT Image 2.5 obedece melhor
Com um limite de 32,000 caracteres no GPT Image 2.5 text-to-image e 50,000 caracteres no GPT Image 2.5 edit-image, você nunca precisa telegrafar suas instruções em fragmentos curtos. Escreva frases completas na sequência exata em que deseja que a tela seja construída. As primeiras orações ancoram a geometria da câmera e o objeto principal; as orações seguintes refinam a iluminação, a tipografia e as margens vazias.
Siga esta ordem de quatro partes:
- Sujeito + material + posição: Nomeie o meio e o objeto principal, seu acabamento superficial tátil e onde ele fica no quadro (
"Matte ceramic pour-over coffee dripper centered on a brushed steel digital scale on a pale ash wood counter"). - Fonte de luz física + direção: Indique o que cria a luz, de qual ângulo ela chega e como as sombras se projetam (
"afternoon sunlight from camera left casting sharp shadows across the brackets"). - Texto entre aspas + tratamento de fonte/superfície: Quando o quadro incluir placas, rótulos ou elementos de UI, coloque os caracteres exatos entre aspas duplas e descreva o estilo das letras e o substrato material (
"crisp white sans-serif lettering reading \"PLATFORM 4 — EXPRESS TO GENEVA\" on deep Prussian blue enamel"). - Reserva explícita de espaço negativo: Diga ao modelo qual terço ou metade da tela deve permanecer vazio para que sua equipe de design possa sobrepor textos em HTML ou Figma posteriormente (
"Keep the right third of the frame an uncluttered warm plaster wall for headline copy").
Antes e depois: sopa de palavras-chave vs briefing espacial declarativo
Compare o que acontece quando você substitui uma lista genérica de tags pela estrutura de frases em quatro partes em três tarefas comerciais comuns.
Tarefa 1: Banner hero de e-commerce com espaço para texto
Weak prompt (keyword soup):
pour-over coffee maker, digital scale, minimalist kitchen, copy space on right,
product photography, 8k, photorealistic, soft lighting, clean background
Strong prompt (declarative brief):
Matte ceramic pour-over coffee dripper centered on a brushed steel digital scale on a pale ash wood counter. Keep the right third of the frame an uncluttered warm plaster wall for headline copy.
Por que a reescrita funciona: "copy space on right" em uma lista separada por vírgulas raramente impede que um modelo de imagem pendure uma prateleira, planta ou moldura de janela naquele canto. Nomear o material exato da região vazia ("an uncluttered warm plaster wall") dá ao modelo uma superfície concreta para renderizar no terço direito da tela.
Tarefa 2: Sinalização arquitetônica com texto incorporado
Weak prompt (unquoted text and vague style):
vintage blue train station sign that says platform 4 express to geneva,
retro typography, brass brackets, sunny day, ultra detailed
Strong prompt (exact quotes and surface physics):
Vintage enamel railway station platform sign in deep Prussian blue with crisp white sans-serif lettering reading "PLATFORM 4 — EXPRESS TO GENEVA", weathered brass mounting brackets, afternoon sunlight.
Por que a reescrita funciona: Deixar as palavras-alvo em minúsculas e sem aspas (says platform 4 express to geneva) convida o modelo a parafrasear, omitir pontuação ou inventar nomes extras de estações. Colocar "PLATFORM 4 — EXPRESS TO GENEVA" entre aspas duplas e especificar "crisp white sans-serif lettering" trava tanto o uso de maiúsculas quanto a geometria dos glifos.
Tarefa 3: Composição de mesa com múltiplos objetos
Weak prompt (flat inventory list):
desk flatlay with anodized keyboard, walnut desk, orange escape key,
notebook, brass pen, daylight, sharp legends
Strong prompt (spatial hierarchy):
Overhead editorial photograph of an anodized aluminum mechanical keyboard centered on a dark walnut desk. Keycaps in matte charcoal with a single signal-orange Esc key at the top left corner of the board. Closed cream linen notebook resting parallel to the right edge of the keyboard, brass fountain pen centered on the cover. Soft north-window daylight from the upper left, crisp key legends, no other props.
Por que a reescrita funciona: Cada objeto secundário é ancorado em relação ao sujeito principal ("at the top left corner of the board", "parallel to the right edge"), evitando geometrias sobrepostas.
Reservando espaço negativo para títulos e sobreposições de UI
Um dos erros mais caros em pipelines automatizados de anúncios e landing pages é gerar uma composição quadrada centralizada em 16:9 e esperar que um desenvolvedor frontend consiga flutuar texto branco sobre a margem esquerda ou direita. A menos que você reivindique o espaço vazio em seu prompt, o GPT Image 2.5 preencherá toda a largura do quadro com objetos secundários, elementos desfocados no fundo ou gradientes dramáticos de sombra que arruínam o contraste do texto.
Aqui está o prompt do coador de café renderizado no GPT Image 2.5, demonstrando como o modelo responde quando você atribui explicitamente uma superfície de parede ao terço direito do quadro:
Matte ceramic pour-over coffee dripper centered on a brushed steel digital scale on a pale ash wood counter. Keep the right third of the frame an uncluttered warm plaster wall for headline copy.
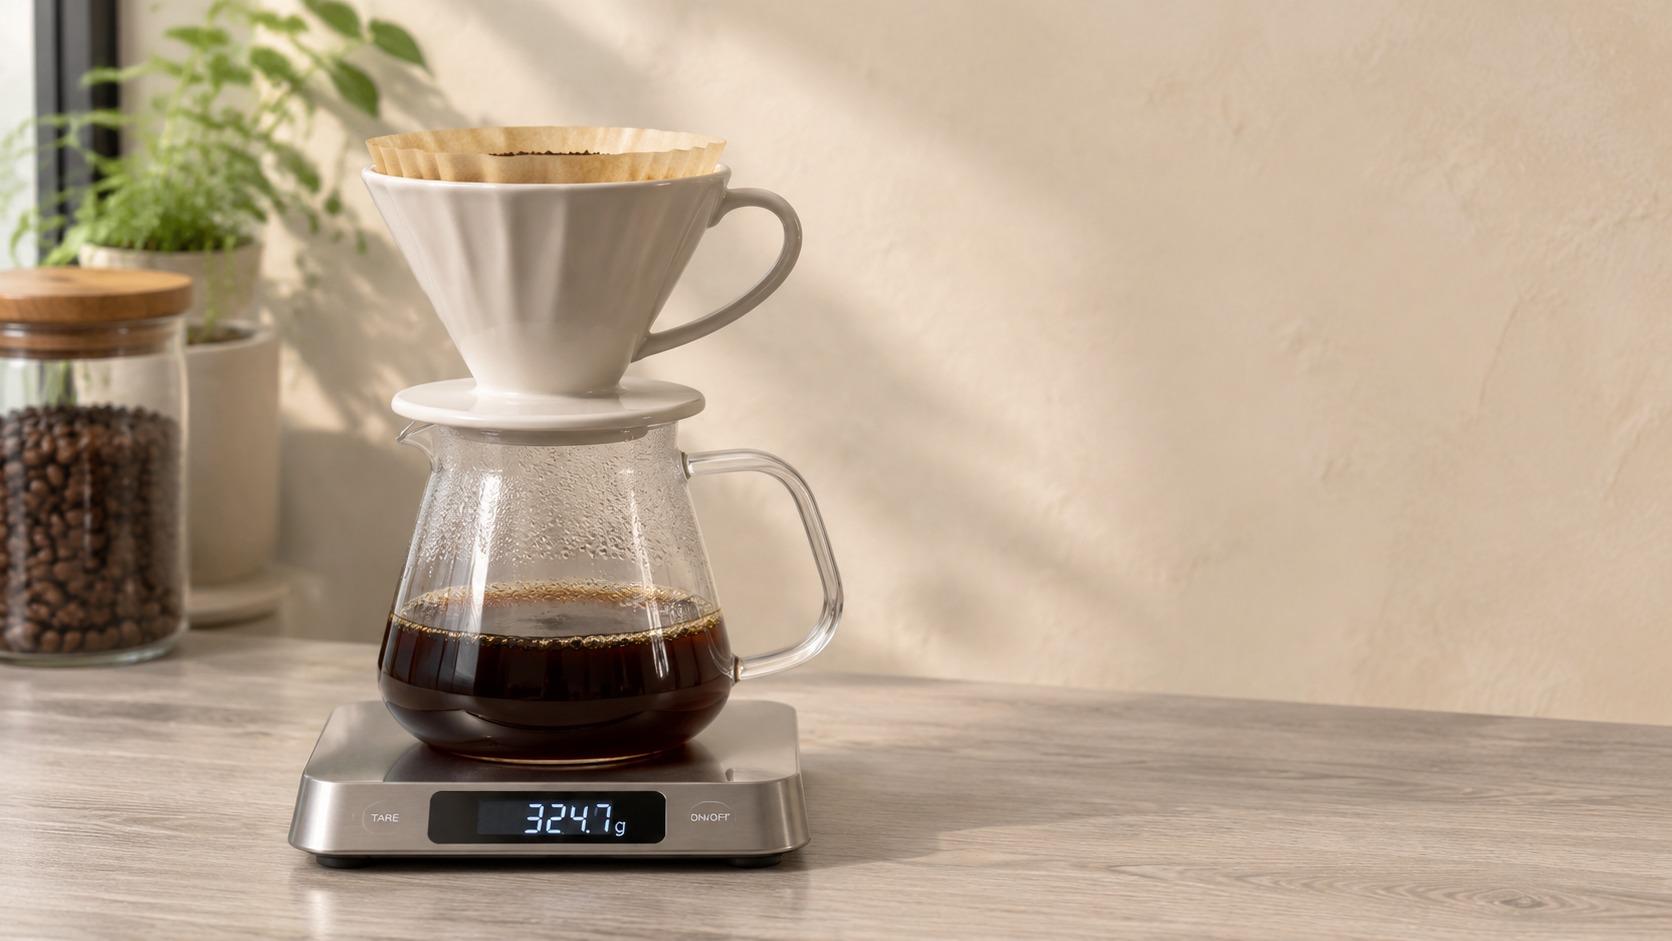
Veja como a cena se divide ao longo do eixo horizontal:
- As nervuras de cerâmica fosca do coador e a plataforma de pesagem de aço escovado ocupam as zonas esquerda e centro-esquerda sem serem cortadas na borda do quadro.
- A bancada de madeira de freixo clara continua de forma limpa até a borda direita, ancorando a cena para que não pareça uma colagem de tela dividida.
- A zona superior direita permanece uma superfície uniforme de gesso quente com transição tonal suave, pronta para receber tipografia HTML escura com ou sem serifa sem precisar de uma caixa escura translúcida atrás das palavras.
Quando você escrever instruções de espaço negativo, sempre combine a fração espacial ("the right third", "the upper quarter", "the left half") com o material de fundo específico que deve ocupá-la ("uncluttered warm plaster wall", "clear pale overcast sky", "seamless slate-gray studio sweep"). Dizer a um modelo o que está no espaço vazio funciona com muito mais confiabilidade do que apenas dizer "leave empty space".
Citando texto exato e controlando a tipografia de superfície
O GPT Image 2.5 é o modelo mais forte no catálogo da E2X para renderizar placas com várias palavras, rótulos de embalagens, capas de livros e cartões de UI. Para obter letras limpas logo na primeira tentativa, siga quatro regras mecânicas sempre que seu prompt contiver texto:
- Sempre coloque os caracteres exatos entre aspas duplas: Escreva
"PLATFORM 4 — EXPRESS TO GENEVA"exatamente no formato em maiúsculas ou misto que você deseja renderizar. - Descreva a família tipográfica pelo estilo visual e peso, e não por arquivos de fontes proprietárias: Use descritores como
"condensed bold grotesque sans-serif","high-contrast editorial Didone serif"ou"hand-painted gold leaf sign-painter capitals". - Especifique como o texto se fixa ao material físico: Indique se as letras são
"screen-printed in matte black ink","stamped in recessed gold foil","enameled white on Prussian blue steel"ou"backlit acrylic channel letters". - Evite palavras aleatórias ilegíveis no fundo: Se a sua cena incluir vitrines ao fundo, potes ou livros que não devam carregar palavras inventadas aleatoriamente, feche seu prompt com
"no other text or logos in the frame".
Aqui está o prompt da placa ferroviária gerado no GPT Image 2.5 usando exatamente essas regras:
Vintage enamel railway station platform sign in deep Prussian blue with crisp white sans-serif lettering reading "PLATFORM 4 — EXPRESS TO GENEVA", weathered brass mounting brackets, afternoon sunlight.
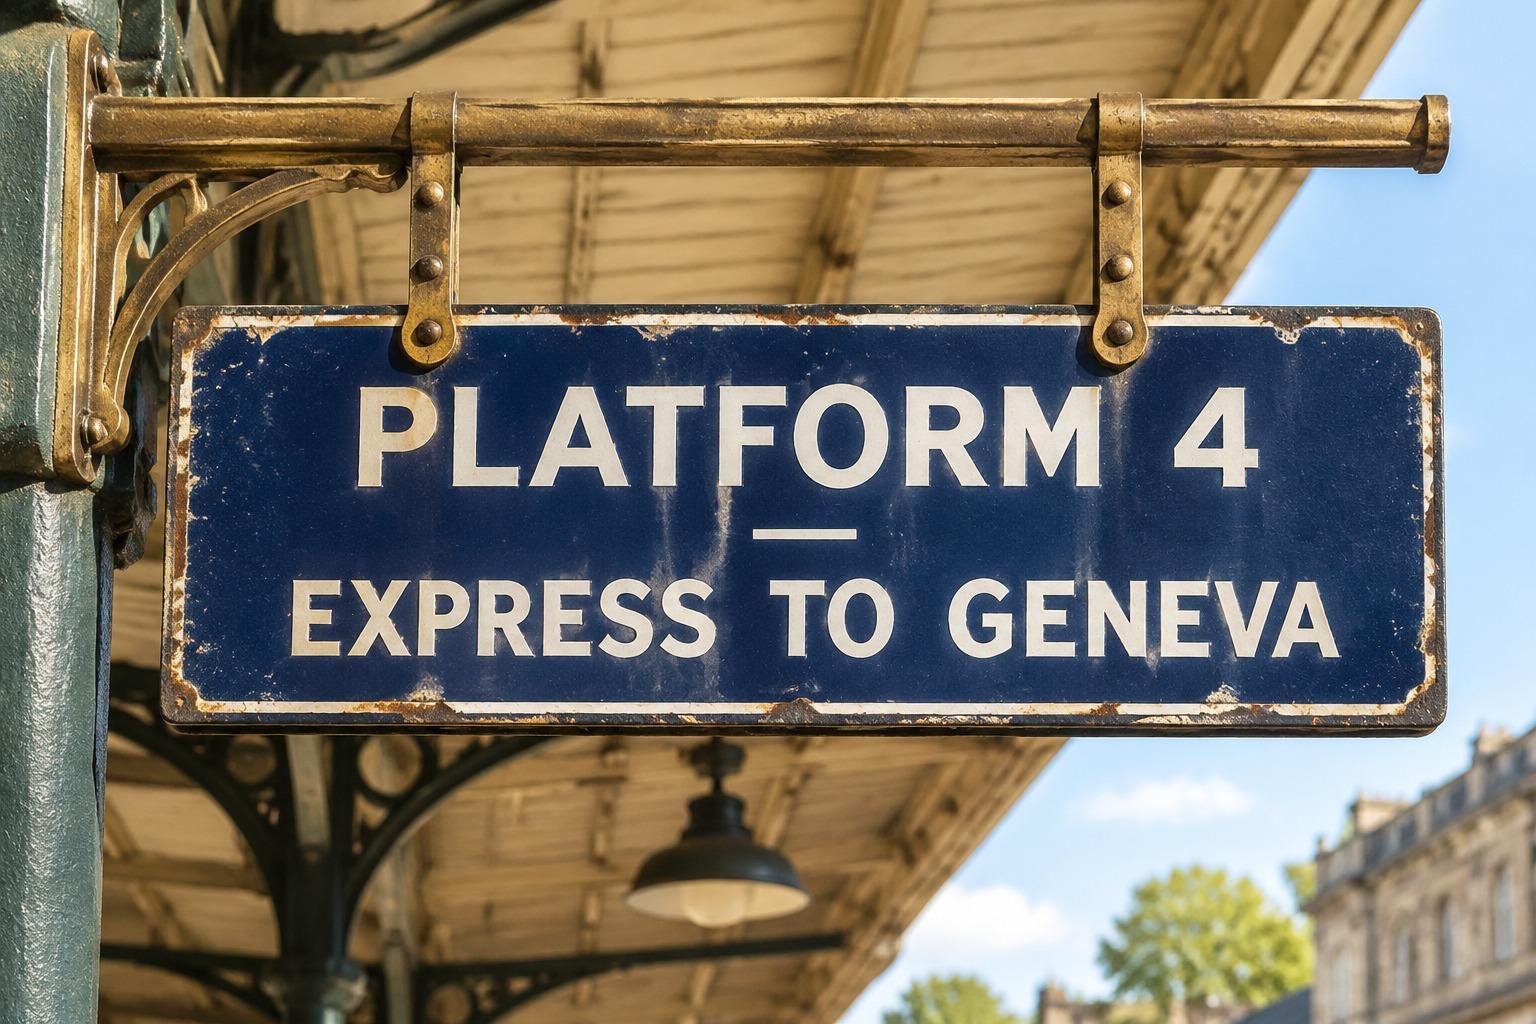
Nesse resultado, o modelo preserva o espaçamento ao redor do sinal de pontuação entre PLATFORM 4 e EXPRESS TO GENEVA, mantém a espessura do traço branco sem serifa uniforme ao longo de toda a placa horizontal e renderiza brilhos especulares sutis do sol da tarde tanto no esmalte azul quanto nas letras pintadas de branco. Enquanto isso, os suportes de montagem de latão envelhecido nos cantos mostram detalhes de oxidação e parafusos sem invadir a borda interna da placa.
Escolhendo entre a qualidade high, xhigh e max na E2X
Em /models/openai/gpt-image-2.5-sunburst/text-to-image e /models/openai/gpt-image-2.5-sunburst/edit-image, o parâmetro quality aceita cinco valores: low, medium, high (o padrão do esquema quando omitido), xhigh e max. Na E2X, o GPT Image 2.5 está disponível em duas variantes: GPT Image 2.5 Sunburst (openai/gpt-image-2.5-sunburst, que suporta resoluções 1K/2K/4K e níveis de qualidade low, medium, high, xhigh, max) e GPT Image 2.5 Flare (openai/gpt-image-2.5-flare, que suporta /models/openai/gpt-image-2.5-flare/text-to-image e /models/openai/gpt-image-2.5-flare/edit-image com resoluções 1K/2K/4K e níveis de qualidade low, medium, high).
Antes de decidir qual configuração enviar, entenda como a E2X cobra esse parâmetro. Cada chamada parte de uma tarifa base de tabela de $0.03, que nosso desconto permanente de 75% reduz para $0.0075. A partir daí:
- Cada configuração de
quality(low,medium,high,xhighemax) aplica exatamente o mesmo multiplicador ×7. resolutionaplica um multiplicador ×1 em1K($0.0525), ×2 em2K($0.1050) e ×3 em4K($0.1575).
Os preços e os termos dos produtos podem mudar. Verifique os preços atuais de cada provedor antes de tomar uma decisão de compra. Os preços de Batch ou Flex do Google não são diretamente equivalentes a uma requisição de API padrão sob demanda, pois as condições de agendamento, disponibilidade e processamento diferem; portanto, são excluídos desta comparação. Esta é uma comparação com escopo definido, e não uma afirmação de que a E2X é a opção mais barata do mundo em todas as configurações.
Como low, high, xhigh e max custam todos exatamente os mesmos $0.0525 em 1K ($0.105 em 2K, $0.1575 em 4K), não há nenhuma razão financeira para enviar low ou medium. O verdadeiro equilíbrio de engenharia entre high, xhigh e max está entre a latência de inferência e o refinamento de detalhes finos:
| Configuração de qualidade | Preço 1K na E2X | Preço 4K na E2X | Melhor caso de uso |
|---|---|---|---|
high (padrão) | $0.0525 | $0.1575 | Prévias interativas rápidas, fotos de produtos de sujeito único, fundos limpos com espaço negativo |
xhigh | $0.0525 | $0.1575 | Placas de fachadas, rótulos de frascos cosméticos, composições de mesa com vários objetos, retratos com textura fina de pele/tecido |
max | $0.0525 | $0.1575 | Pôsteres densos de múltiplas linhas, cortes transversais mecânicos/arquitetônicos detalhados, renderizações master finais em 2K/4K |
Na prática, use quality: "high" com resolution: "1K" quando um usuário estiver aguardando interativamente em uma tela de UI e seu prompt não tiver textos em fonte pequena. Use quality: "xhigh" em 1K ($0.0525) sempre que seu prompt incluir tipografia entre aspas ou múltiplos objetos interagindo. Mude para quality: "max" em 2K ($0.105) ou 4K ($0.1575) ao renderizar o master final de produção em uma fila de workers em segundo plano.
Prompting delta para edit-image vs prompting de cena completa para text-to-image
Criar prompts para o GPT Image 2.5 edit-image exige um modelo mental diferente do text-to-image. Quando você passa uma ou mais imagens de origem em image_urls, a cena visual já existe. Se o seu prompt redescrever o ambiente inteiro, a iluminação e a lente da câmera do zero, o modelo tratará essas frases como instruções para regenerar essas regiões, introduzindo desvios sutis em rostos, texturas ou perspectiva.
Escreva um prompt de edit-image como um delta estrito com três componentes:
- Indexe as imagens de origem explicitamente: Ao passar várias URLs em
image_urls, refira-se a elas como"image 1","image 2"e"image 3". - Indique a modificação exata: Descreva apenas o elemento que muda, incluindo o texto substituto entre aspas se estiver atualizando uma placa ou rótulo.
- Trave todo o resto: Liste explicitamente os elementos ao redor que devem permanecer intocados.
Compare um prompt de cena completa de text-to-image com seu respectivo prompt delta de edit-image:
Full-scene prompt (for openai/gpt-image-2.5-sunburst/text-to-image):
Vintage enamel railway station platform sign in deep Prussian blue with crisp white sans-serif lettering reading "PLATFORM 4 — EXPRESS TO GENEVA", weathered brass mounting brackets, afternoon sunlight.
Delta edit prompt (for openai/gpt-image-2.5-sunburst/edit-image):
In image 1, change the white sans-serif lettering on the Prussian blue enamel sign to read "PLATFORM 9 — NIGHT TRAIN TO MILAN" in the exact same font weight, kerning, and enamel surface gloss. Keep the weathered brass mounting brackets, afternoon sunlight angle, and background masonry completely unchanged.
Envie essa chamada de edição delta via POST https://api.e2x.ai/v1/jobs/submit, mantendo aspect_ratio: "auto" para que a saída corresponda às dimensões da sua imagem de entrada:
curl -X POST https://api.e2x.ai/v1/jobs/submit \
  -H "Authorization: Bearer $E2X_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.5-sunburst/edit-image",
    "input": {
      "prompt": "In image 1, change the white sans-serif lettering on the Prussian blue enamel sign to read \"PLATFORM 9 — NIGHT TRAIN TO MILAN\" in the exact same font weight, kerning, and enamel surface gloss. Keep the weathered brass mounting brackets, afternoon sunlight angle, and background masonry completely unchanged.",
      "image_urls": [
        "https://assets.e2x.ai/assets/posts/gpt-image-2-5-prompting-guide/example-2.jpg"
      ],
      "aspect_ratio": "auto",
      "resolution": "2K",
      "quality": "max"
    }
  }'
Lembre-se de duas regras de esquema ao alternar entre geração e edição na E2X:
openai/gpt-image-2.5-sunburst/edit-imageaceita prompts de até 50,000 caracteres (em comparação com 32,000 notext-to-image), permitindo que scripts automatizados de localização enviem regras completas de layout sem truncamento.- Nenhum dos endpoints do GPT Image 2.5 inclui
background: "transparent". Se um packshot recortado precisar de canal alfa em uma única chamada de API, direcione esse job para o GPT Image 2 text-to-image ou GPT Image 2 edit-image pelo mesmo preço de $0.0525 (1K).
Para comparativos diretos entre modelos, leia nossas análises de GPT Image 2.5 vs Nano Banana 2.1 e GPT Image 2.5 vs FLUX.2 Pro e Max, ou confira nosso guia de prompts para o Nano Banana. Você também pode inspecionar os esquemas brutos de parâmetros na especificação llms.txt de text-to-image e na especificação llms.txt de edit-image, ou navegar por todos os modelos no catálogo da E2X.
Perguntas frequentes
Qual é a melhor ordem de frases para um prompt do GPT Image 2.5?
Comece pelo sujeito principal, seu acabamento de material e sua posição no quadro. Siga com a fonte de luz física e a direção das sombras, depois especifique qualquer texto exato na imagem entre aspas duplas junto com sua fonte e tratamento de superfície, e finalize reservando espaço negativo explícito (nomeando tanto a região do quadro quanto a superfície de fundo limpa).
Por que o GPT Image 2.5 erra a grafia das palavras quando não uso aspas?
Quando as palavras-alvo são escritas soltas na frase sem aspas, a camada de condicionamento de linguagem pode tratá-las como descrições temáticas em vez de sequências literais de caracteres. Colocar a sequência exata entre aspas duplas (reading "PLATFORM 4 — EXPRESS TO GENEVA"), nomear o estilo da fonte ("crisp white sans-serif lettering") e definir quality como xhigh ou max instrui o modelo a renderizar exatamente aqueles glifos.
Devo usar sempre a qualidade max no GPT Image 2.5 já que custa o mesmo que high?
Na E2X, low, medium, high, xhigh e max carregam todos o mesmo multiplicador ×7 ($0.0525 em 1K, $0.105 em 2K, $0.1575 em 4K). Use xhigh ou max sempre que seu prompt contiver tipografia incorporada, texturas finas de pele ou tecido, ou restrições espaciais com múltiplos objetos. Mantenha high quando quiser um tempo de resposta mais rápido em rascunhos simples de sujeito único ou imagens de fundo limpas.
Como reservo espaço limpo para sobreposições de texto em HTML?
Especifique tanto a fração do quadro quanto a superfície física exata que deve preencher aquela zona vazia, como "Keep the right third of the frame an uncluttered warm plaster wall for headline copy" ou "Keep the upper half a clear pale overcast sky with no clouds or objects". Nomear a superfície impede que o modelo preencha o espaço com objetos de fundo aleatórios.
Como um prompt de edit-image deve diferir de um prompt de text-to-image?
Para /models/openai/gpt-image-2.5-sunburst/text-to-image, descreva a cena inteira do zero (até 32,000 caracteres). Para /models/openai/gpt-image-2.5-sunburst/edit-image (até 50,000 caracteres), escreva apenas o delta: referencie o arquivo de entrada pelo número ("In image 1..."), indique o elemento exato ou texto entre aspas que muda e instrua explicitamente o modelo a manter todos os outros objetos, iluminação e ângulos de câmera inalterados.