Непрерывность планов в Gemini Omni 1.1 Flash: какой эндпоинт лечит какой дрейф
Google опубликовал об этой модели два предложения в рамках одного запуска, и указывают они в противоположные стороны.
Первое — в анонсе: продолжая клип, Omni теперь читает «до 10 секунд предыдущего контекста — скачок относительно прежних моделей, которые ссылались только на последнюю секунду». Вдесятеро больше памяти. Второе — в model card от DeepMind, в разделе ограничений: «сохранение полной консистентности на протяжении правок, генерация сцен со сложным движением или отрисовка идеально точного текста остаются сложной задачей».
И то и другое верно, и вместе они описывают работу. Непрерывность здесь — не переключатель, который включают, а набор решений, принимаемых на входе: какой эндпоинт вы вызываете, что вы фиксируете изображением, какие предложения повторяете слово в слово. Стоимость последовательности из четырёх частей — отдельный разговор, и заново мы его не ведём.
Четыре эндпоинта, четыре разные удерживаемые вещи
На E2X gemini-omni-1.1-flash поставляется как четыре возможности по одной цене — $0.18 за секунду в 4K, какую бы вы ни вызвали. Это меняет способ думать о них: выбор между ними никогда не бюджетное решение, только ремесленное.
Что фиксирует каждая:
| Возможность | Что удерживает | Чего не удержит |
|---|---|---|
| text-to-video | Ничего, кроме ваших слов | Всё, что вы не записали |
| image-to-video | Открывающий кадр, в точности | Всё после примерно первой секунды |
| start-end-frame-to-video | Оба конца плана | Путь между ними |
| reference-to-video | Идентичность и облик персонажа | Кадрирование, мизансцену, позицию камеры |
Читайте это как диагностику, а не как список функций: назовите дрейф, который видите, а потом выберите эндпоинт, который его лечит.
План начинается неправильно. Ваш второй ракурс открывается на другой комнате, или персонаж входит уже посреди жеста. Дайте ему кадр: image-to-video берёт неподвижное изображение и стартует с него, так что второй план может открыться на грабе из последнего кадра первого плана или на утверждённом ранее рендере. Это самое дешёвое лечение непрерывности, которое предлагает модель.
План заканчивается неправильно. Движение верное, а приземление нет: рука тянется к двери, а дверь где-то в другом месте. Это start-end-frame-to-video. Вы подаёте start_frame_url и end_frame_url, модель заполняет интервал, и кадр, к которому обязана подойти следующая склейка, выбран вами, а не выдан вам.
Человек меняется. Не кадрирование, не мизансцена — лицо, волосы, куртка. Это reference-to-video, единственная из четырёх, чьё назначение — идентичность. Наш массив image_urls принимает минимум одно и максимум семь изображений; Runware документирует тот же потолок — «up to 7 images», — тогда как справочник Google числа не называет, хотя в его разобранном примере шесть тегов. Считайте семёрку консенсусом третьих сторон, а не опубликованной гарантией.
Видеореференсы ограничены жёстче, и эти числа Google публикует: «Video references support a maximum of 3 clips, up to 3 seconds each», рядом с «Referencing or reasoning across multiple videos is not supported» — три это потолок, к которому подходят, а не цель, которую надо выбрать. Про то, что должно быть на референсном изображении, документация Runware конкретнее гугловской: она рекомендует чистый средний портрет — поясная крупность, нейтральный фон, видимые опознавательные детали, — потому что «полноростовые планы, загруженные фоны или экстремальные ракурсы размывают считывание персонажа моделью».
Что фиксирует seed, а что нет
Сэмплера на этом эндпоинте нет. Документация Google прямолинейна: «System instructions, temperature, top_p, stop sequences, and negative prompts are not supported». Отсутствие поверхности сэмплинга означает один контроль воспроизводимости, и это seed — необязательное целое, которое принимают все четыре наши схемы возможностей.
Стоит знать, откуда взялось это поле, потому что в справочнике Google его нет вовсе. Документация Runware по 1.1 несёт seed и описывает возврат «the randomly generated seed», если вы не подали своё; мы выставляем поле на каждой возможности; Google на странице, которую вы открыли бы первой, молчит. Пользуйтесь, но не считайте это контрактом.
Место, где спотыкаются: seed фиксирует выборку, а не объект. Тот же seed и побайтово идентичный prompt — это повтор. Тот же seed и одно изменённое слово — это новая выборка, свежая, а не сдвинутая. Это противоположность ручке temperature, и это значит, что привычка моделей изображений держать seed, подкручивая prompt, сюда не переносится.
Остаётся ровно две вещи, для которых seed полезен в многоплановой работе, и одна, для которой бесполезен:
- Перерендер зачётного дубля на более высоком уровне. Черновик, найденный дубль, потом тот же prompt и тот же
seedна разрешении сдачи. Ничего не изменилось — ничего не пересэмплируется. - Изоляция одной переменной. Смените предложение про свет, удержите
seed— и то, что сдвинулось, приписывается этому предложению. Не контролируемый эксперимент, но быстрее, чем пересэмплировать вслепую. - Перенос лица между двумя разными планами. Не сработает. Два prompt — это два prompt;
seedне помнит вашего персонажа. Идентичность между планами приходит от референсных изображений, а не от целого числа.
Записывайте seed рядом с prompt в тот момент, когда дубль получился. Истории, из которой его потом можно восстановить, нет.
Lock-блоки: один и тот же абзац, повторённый дословно
Поскольку у вызова text-to-video нет памяти о вашем предыдущем вызове, самая частая инструкция по непрерывности в дикой природе адресована никому: «Keep everything consistent with the previous shot» указывает на план, которого модель никогда не видела.
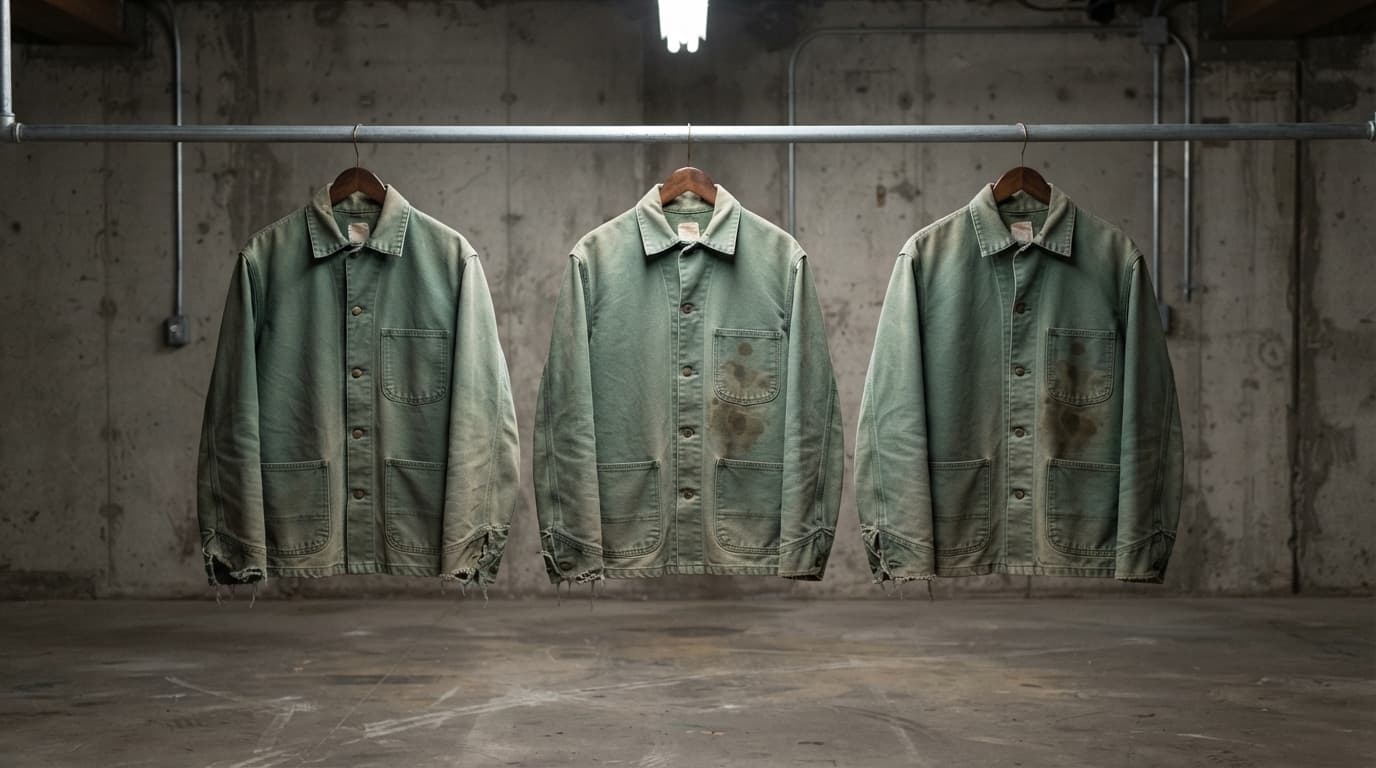
Исправление негламурное. Напишите один блок фактов о внешности и обстановке и вставьте его в каждый prompt последовательности без изменений — не пересказанным, не подтянутым, не переставленным. Новое описание — это новая выборка.
Вот две версии одного и того же второго плана в двухплановой последовательности. Сначала та, которая дрейфует:
Continuing the same scene, a tighter shot of the same man at his
workbench in the garage. Cinematic lighting, moody atmosphere,
highly detailed, professional colour grading. He lifts the machined
part into the light and turns it slowly while his colleague watches
from the right. Keep the characters and the location consistent
with the previous shot. Single continuous shot, no scene cuts.
Sound design: workshop room tone and quiet handling noise.
Посчитайте, что этот prompt оставил незакреплённым, — и получите список того, что вольно измениться: точный зелёный куртки, потрёпан ли обшлаг, есть ли вообще бандана, что висит на перфопанели, откуда падает свет. Ничего из этого не записано, поэтому ничего из этого вам не должны — грамотный план другого дня остаётся корректным ответом на заданное.
Переписанная версия сохраняет действие и тратит слова на факты, а не на прилагательные:
In a single continuous shot, no scene cuts. Medium two-shot in a
cluttered garage workshop, 40mm lens at f/4, both subjects sharp.

[Lock - repeat verbatim in every shot of this sequence]
Man: mid-forties, close-cropped grey hair parted on his left, faded
green canvas work jacket, frayed left cuff, oil stain on the right
pocket, steel watch on his left wrist. Woman: thirties, dark hair
tied back, grey knit sweater, red bandana at her neck, clipboard in
her right hand. Set: steel workbench, pegboard behind with three
wrenches hanging left of centre, one overhead fluorescent tube,
cold white key from above, no window light.

Action: he lifts a machined aluminium part into the light and turns
it once; she does not move. Sound design: fluorescent hum, the part
clicking down onto steel. No dialogue.
Метка в квадратных скобках — для вас, а не для модели: она размечает область, которую вы копируете. Место в блоке заслуживает всё асимметричное или повреждённое: на какую сторону лежит пробор, какой обшлаг потрёпан, на каком запястье часы, в какой руке планшет. Симметрия — это место, где прячется дрейф, потому что зеркально отражённая симметричная деталь выглядит верной в одиночку и неверной в склейке. Названия цветов туда же, и свет тоже: направление, жёсткость и явное отсутствие источника, которого вы не хотите.
Одно, что стоит держать вне блока: печатные этикетки, вывески, читаемый текст на реквизите. Model card перечисляет точный текст среди открытых проблем, так что реквизит, который обязан читаться одинаково в двух планах, — самый ненадёжный из доступных якорей. Якоритесь на форме и пятне.
Продление идёт вперёд, поэтому планируйте назад
Формулировка Google не оставляет зазора: «Продление видео ограничено дописыванием в конец видео; приписывание в начало или продление середины клипа не поддерживается». Продолжения идут шагами по десять секунд «до общей длины 40s», а загруженный клип должен быть «длиной 10 секунд или меньше», прежде чем его можно продлить.
Последствие для планирования крупнее, чем кажется: у цепочки нет отмены. Первый план задаёт палитру, свет и грамматику камеры для всего, что к нему приписано, поэтому ошибка там — это перестраиваемая последовательность, а не перерендериваемый план. И самый рискованный план — трудный жест, каверзное отражение — обычно сидит в середине, ровно там, куда не дотянуться.
Так что структурный выбор надо сделать до первого вызова:
- Одна цепочка продлений покупает настоящее покадровое продолжение и десять секунд контекста, которые модель действительно читает. Стоит это способности исправить что-либо, кроме хвоста.
- Независимые генерации, сшитые в монтажной, каждая с якорем в виде референсного изображения или стартового кадра, стоят вам бесшовного стыка и покупают возможность перекатить третий план тридцать раз, не трогая первый и второй.
Для действия, которое не должно заметно резаться, продлевайте. Для последовательности, в которой склейки и так есть, генерируйте отдельно — и этот же вариант переживёт правку от клиента, а её получает большинство последовательностей.
Этот клип — одна генерация, несущая перекадровку, а не два соединённых плана:
A two-shot in a cluttered garage workshop, 40mm lens at f/4, both
subjects sharp. A man in a faded green work jacket with a torn left
cuff stands at the bench; a woman in a grey knit sweater with a red
bandana tied at her neck stands to his right holding a clipboard.
The camera holds the wide two-shot for four seconds while he lifts
a machined aluminium part into the light and turns it. Then the
camera pushes in and reframes to a tighter two-shot from the same
axis - same jacket, same torn cuff, same bandana, same bench clutter
behind them, same overhead fluorescent light. No cut, no wardrobe
change, no relight. Sound: fluorescent hum and the part clicking
down onto steel.
Точки склейки — это ещё и склейки звука
Аудио генерируется вместе с картинкой, и отказаться от него нельзя. Обычно это проходит по разделу звукового решения; для непрерывности это ограничение, потому что ваша склейка приземляется посреди фонограммы, которую вы не сочиняли и не можете подрезать в источнике.
Отсюда два правила. Описывайте атмосферу идентичными словами по обе стороны склейки, ровно так же, как повторяете блок про костюм: «fluorescent hum» в обоих prompt, а не «fluorescent hum», а потом «the buzz of the overhead light». Комнатный тон, который сдвигается на стыке, игнорировать труднее, чем куртку, сменившую оттенок, потому что уху негде спрятаться за границей плана.
Дальше выбирайте место склейки с учётом звука. Резать посреди жеста — значит требовать от модели воспроизвести тот же вектор движения на другой стороне, ровно тот случай «сложного движения», который отмечает model card. Резать на устоявшейся позе — деталь поставлена, рука неподвижна — значит дать следующей генерации однозначное начальное условие, а звуку естественный шов. Это стоит такта темпа и покупает стык, который держится.
Одно решение принимается до всего этого: соотношение сторон. Модель предлагает 16:9 и 9:16 и больше ничего. Поскольку продление только дописывает, а референсные изображения наследуют кадрирование, в котором сняты, смена ориентации на середине последовательности — не изменение настройки, а обнуление каждого ассета выше по течению. Выбирайте ориентацию с оглядкой на сдачу, на первом плане.
Сколько стоит последовательность из четырёх планов
Инструменты непрерывности на этой модели бесплатны. Вызов reference-to-video с семью изображениями стоит столько же, сколько голый вызов text-to-video; кадры, которые вы передаёте в start-end-frame-to-video, не добавляют ничего. Вы платите за секунды и разрешение.
Четыре восьмисекундных плана — это тридцать две секунды. На верхнем уровне:
| Где | 32 с в 4K |
|---|---|
| E2X | $5.76 |
| Google, по опубликованным токенным ставкам | $9.73 |
| fal | $9.60 |
| Runware | $10.24 |
| WaveSpeed | $12.48 |
Этот разрыв — история про множители, а не про скидку. Обе лестницы поднимаются одинаково от 360p до 1080p; на верхней ступени Google утраивает свою ставку 720p, а мы удваиваем свою, поэтому разброс шире всего ровно там, где сдаются готовые последовательности. Разбор по уровням, включая то, почему верхний уровень — апскейл, лежит в нашем посте про 4K.
Теперь приложите это к тому, как идёт работа над непрерывностью. Никто не берёт четыре плана за четыре генерации. Если третий план требует шести попыток, а четвёртый трёх, это пятнадцать заданий — $21.60 здесь против $36.49 напрямую в 4K. Что и есть сильнейший аргумент за независимые генерации против одной цепочки: перекат стоит одного плана, а не хвоста последовательности. Тесты на непрерывность гоняйте в 360p, шестой части посекундной ставки 4K, и повышайте только победителя.
Где всё ещё едет
Честная версия, раз уж model card даёт нам для неё язык.
Разделение следует из того, что два механизма способны закодировать. Предложение и референсная фотография несут грубые, называемые свойства: силуэт и цвет одежды, длину и цвет волос, геометрию комнаты, палитру, направление и жёсткость света, примерное расположение крупного реквизита. Это lock-блок может проговорить, а референсное изображение — показать.
Чего не несёт ни то ни другое — точность ниже уровня названия: точную геометрию лица между далёкими крупностями, украшения, мелкие фоновые предметы, тонкую фактуру ткани и всё печатное, которое model card отдельно перечисляет как ненадёжное. Google называет закономерность только в общих словах, а сторонние обозреватели описывают, что бьёт она сильнее всего на сменах сцены и движениях камеры, а не внутри удерживаемого плана. Это наше прочтение документации и публикаций, а не измеренное утверждение; стенда, который поставил бы сюда число, мы не собирали.
Практически: последовательности с героическим крупным планом этот крупный план нужно генерировать из набора референсов, а не наследовать от общего, потому что идентичность переживает перекадровку лучше, чем смену крупности. Сама техника лица в одном плане — отдельный пост, а словарь камеры, удерживающий два плана на одной оси, — в посте про камеру.
Никому не стоит продавать на этой модели тридцатиплановый нарратив с обещанием лица, которое никогда не поедет. Продать можно последовательность, где дрейф достаточно мал, чтобы уместиться внутри склейки, — и это достижимо референсами, lock-блоками и точками склейки, выбранными по неподвижности.
Начинайте с таблицы в начале: назовите дрейф, выберите инструмент, напишите блок один раз, повторяйте его точно. Справочник API Google несёт формы тегов для привязки референсов по имени, а страницы возможностей несут актуальные тарифы и схемы.
Цены и условия продуктов меняются. Перед решением о покупке проверяйте актуальные цены у каждого провайдера.
Частые вопросы
Как удержать персонажа консистентным между планами в Gemini Omni 1.1 Flash?
Двумя механизмами сразу. Передайте персонажа референсными изображениями через reference-to-video — наша схема принимает от одного до семи, и Runware документирует тот же потолок — и повторяйте идентичный блок фактов о внешности в каждом prompt, скопированный, а не пересказанный. Референсы несут идентичность; повторяемый текст несёт костюм, реквизит и свет. Model card Google прямо говорит, что полная консистентность между правками всё ещё открытая задача, так что по отдельности ни одного из двух не хватит.
Удерживает ли seed одного и того же персонажа между двумя prompt в Gemini Omni?
Нет. seed фиксирует выборку, а не объект. Два разных prompt — это две разные выборки независимо от seed, а одно изменённое слово в остальном идентичного prompt даёт свежую выборку, а не вариацию. seed отрабатывает своё на перерендере утверждённого дубля в более высоком разрешении и на изоляции одного изменённого предложения. Идентичность между планами приходит от референсных изображений.
Какую возможность Omni выбрать для плана, который обязан закончиться на конкретном кадре?
start-end-frame-to-video. Вы подаёте стартовое и конечное изображение, модель генерирует интервал, и кадр, к которому обязана подойти следующая склейка, выбран вами. На E2X это стоит столько же за секунду, сколько обычный text-to-video, так что ценовых причин избегать этого нет.
Может ли Gemini Omni 1.1 Flash продлить видео назад?
Нет. Документация Google говорит, что продление только дописывает в конец клипа, без способа приписать в начало или продлить середину. Продолжения идут шагами по десять секунд до сорока секунд суммарно, а клип, который вы продлеваете, должен быть десять секунд или короче. Поэтому первая генерация фиксирует облик всего, что идёт после неё, и раннюю ошибку не починить без перестройки цепочки.
Сколько референсных изображений принимает Gemini Omni 1.1 Flash?
Наша схема reference-to-video берёт от одного до семи, и документация Runware называет тот же максимум. Собственный справочник Google числа не публикует, хотя в его разобранном примере в одном prompt привязано шесть тегированных изображений, — так что считайте семёрку консенсусом третьих сторон, а не задокументированной гарантией. Видеореференсы Google ограничивает отдельно: три клипа длиной до трёх секунд каждый.
Где лучше всего резать между двумя сгенерированными планами?
На неподвижности, а не посреди движения. Устоявшаяся поза даёт следующей генерации однозначное начальное условие; склейка внутри жеста просит модель воспроизвести вектор движения — тот самый случай сложного движения, который model card Google перечисляет как известную слабость. А поскольку каждый клип приходит с фонограммой, от которой нельзя отказаться, описывайте атмосферу идентичными словами по обе стороны стыка, иначе комнатный тон сдвинется на склейке.
Можно ли смешивать планы 16:9 и 9:16 в одной последовательности Omni?
Не с пользой. Эти два соотношения — единственные варианты, продление дописывает в той ориентации, с которой началось, а референсные изображения несут кадрирование, в котором сняты, — так что смена ориентации на середине обнуляет каждый ассет выше по течению. Решайте, горизонталь или вертикаль, под формат сдачи до первого плана.
Что дешевле: строить последовательность продлениями или генерировать планы отдельно?
Посекундная ставка одинакова в обоих случаях — на продление скидки нет, — поэтому разница в том, сколько стоит перекат. В цепочке починка раннего плана выбрасывает всё, что к нему приписано. При независимых генерациях с якорями в виде референсных изображений или стартовых кадров плохой план стоит одного плана. На E2X тридцать две секунды 4K стоят $5.76 против $9.73 напрямую у Google, и этот разрыв растёт с каждым выброшенным дублем.