API Text-to-Image GPT Image 2.6 Flare sur E2X
GPT Image 2.6 Flare est le point de terminaison de production texte-vers-image haute vitesse d'OpenAI sur E2X, servi sur openai/gpt-image-2.6-flare/text-to-image. Conçu pour les pipelines créatifs à faible latence et les applications interactives, il s'exécute jusqu'à 2× à 2.5× plus vite que GPT Image 2.5 Flare (~6 secondes en qualité low) tout en bénéficiant de notre remise permanente de 75 % ($0.0525 par image à resolution: "1K" contre $0.211 pour une requête équivalente de niveau élevé sur fal.ai). GPT Image 2.6 Flare prend en charge la génération native de fichiers .gif animés multi-images (output_format: "gif"), la génération de tracés vectoriels .svg évolutifs (output_format: "svg") et trois niveaux de qualité rationalisés (low, medium, high) aux résolutions 1K, 2K et 4K. Comme les trois réglages de qualité partagent le même multiplicateur ×7 sur E2X, vous pouvez demander high en 1K exactement au même prix de $0.0525 que low.
Lorsqu'une charge de travail exige les niveaux de raisonnement plus poussés xhigh ou max pour des plans architecturaux denses ou une typographie micro-gravée, orientez la requête vers GPT Image 2.6 Sunburst text-to-image exactement au même tarif. Si votre flux de travail part d'images de référence existantes, de packshots produits ou d'annotations de mise en page, appelez GPT Image 2.6 Flare edit-image (Sunburst edit-image), qui accepte jusqu'à 16 images de référence via image_urls au même tarif de $0.0525 (1K).
Galerie de démonstration visuelle et GIF animés
Chaque visuel ci-dessous a été généré via le pipeline GPT Image 2.6 et hébergé sur le CDN E2X (assets.e2x.ai), mettant en avant les animations .gif multi-images en boucle de Flare, les rendus commerciaux de produits ultra-nets, les tracés vectoriels .svg évolutifs ainsi qu'une comparaison côte à côte avec Sunburst Max.
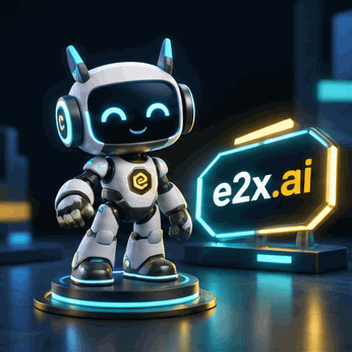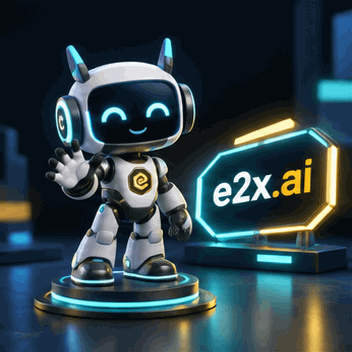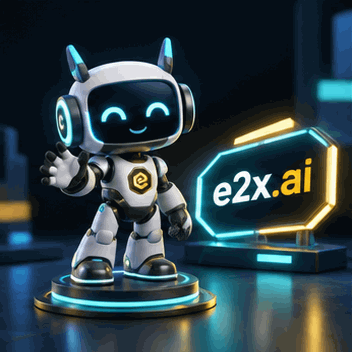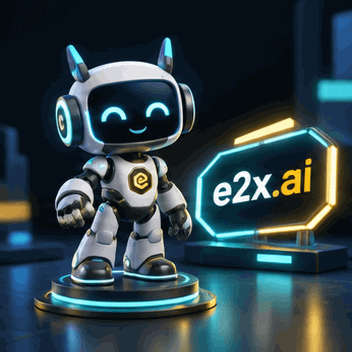
- Point de terminaison :
openai/gpt-image-2.6-flare/text-to-image (output_format: "gif", aspect_ratio: "1:1", frame_count: 8, frame_duration_ms: 150, 352×352)
- Prompt :
"A cute 3D isometric cyber-robot mascot character waving cheerfully beside a glowing cyan and gold neon badge reading \"e2x.ai\" in a sleek dark studio, smooth looping animation"
- Point de terminaison :
openai/gpt-image-2.6-flare/text-to-image (output_format: "gif", aspect_ratio: "16:9", 553×309)
- Prompt :
"Generate an animated GIF of a glowing neon cyberpunk ramen shop sign at night with animated rising steam from a holographic bowl and flickering magenta and cyan rain reflections, crisp neon text reading \"e2x.ai\", looping multi-frame animation"
Prise de vue produit commerciale haute vitesse : casque en fibre de carbone (aspect_ratio: "1:1")
- Point de terminaison :
openai/gpt-image-2.6-flare/text-to-image (output_format: "png", aspect_ratio: "1:1", resolution: "1K", quality: "high")
- Prompt :
"An eye-catching editorial cyberpunk night photograph of a sleek futuristic matte-black carbon-fiber motorcycle helmet resting on a rain-slicked neon street podium in the center of the frame, with bold, crisp, ultra-legible glowing cyan-white LED typography reading \"e2x.ai\" illuminated across the curved iridescent visor. Dramatic electric blue and vibrant magenta anamorphic horizontal lens flares streak across the frame with neon bokeh reflections on the wet asphalt. Photorealistic 8K commercial shot."
- Format de sortie :
output_format: "svg" (aspect_ratio: "1:1", <svg> XML évolutif 1024×1024)
- Prompt :
"Clean geometric vector emblem badge for \"e2x.ai\" featuring a stylized radiant sunburst prism and orbital rings in vibrant gold, cyan, and deep obsidian navy, crisp flat vector paths"
Comparaison côte à côte Sunburst Max vs Flare High (aspect_ratio: "16:9")
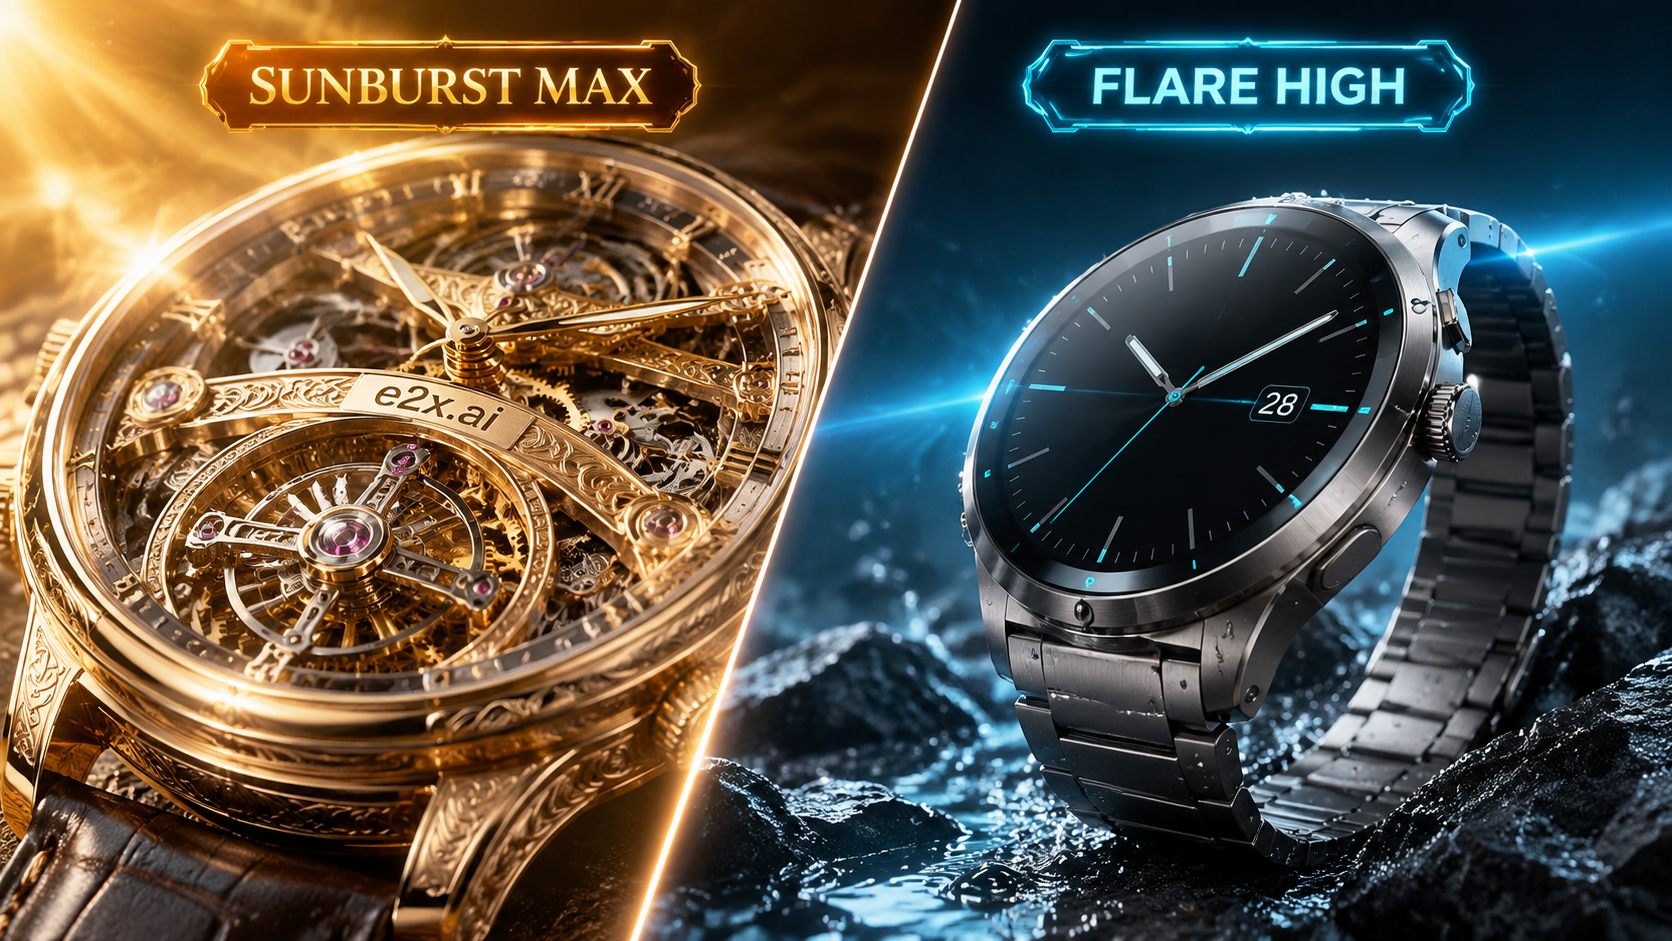
- Comparaison visuelle (
16:9, 1672×941) : détail macro d'un tourbillon ajouré sur Sunburst Max face à une photographie produit en titane à fort contraste sur Flare High.
- Prompt :
"Split-screen visual comparison in a luxury studio: on the left side under a warm golden badge reading \"SUNBURST MAX\", an ultra-intricate macro photograph of an open-worked tourbillon mechanical watch with engraved gold bridges reading \"e2x.ai\" and warm sunburst lighting; on the right side under a sleek cyan badge reading \"FLARE HIGH\", a high-contrast commercial product shot of a matte titanium smartwatch on wet dark basalt with electric cyan lens flare"
Chaque appel à openai/gpt-image-2.6-flare/text-to-image part d'un tarif de base catalogue de $0.03 (30,000 micro-cents), réduit par notre remise globale permanente de 75 % à une base remisée de $0.0075 (7,500 micro-cents), puis multiplié par deux facteurs de schéma :
- Multiplicateur
resolution : 1K (par défaut) vaut ×1, 2K vaut ×2 et 4K vaut ×3.
- Multiplicateur
quality : low, medium (par défaut) et high appliquent tous un multiplicateur ×7.
Comme chaque valeur de quality (low, medium, high) multiplie la base remisée de $0.0075 par 7, resolution est l'unique paramètre qui modifie votre coût par image. Envoyer quality: "low" est facturé exactement $0.0525 en 1K, tout comme high ; choisissez donc low uniquement lorsque vous recherchez la latence de prévisualisation la plus rapide possible (~6 s), et utilisez high par défaut pour vos ressources de production sans frais supplémentaires.
Voici la grille tarifaire vérifiée le 6 novembre 2026 par rapport aux tarifs à la demande de fal.ai :
| Résolution | Multiplicateur | Prix catalogue E2X ($0.03 × 7) | Prix E2X (-75 %) | fal.ai (niveau high) | Économie E2X |
|---|
1K (par défaut) | ×1 × 7 | $0.21 | $0.0525 | $0.211 | 75 % moins cher |
2K | ×2 × 7 | $0.42 | $0.1050 | $0.222 | 53 % moins cher |
4K | ×3 × 7 | $0.63 | $0.1575 | $0.401 | 61 % moins cher |
Cette courbe façonne l'organisation d'un pipeline itératif. Maintenez resolution sur 1K ($0.0525) pendant que vous testez la composition, l'éclairage et le lettrage entre guillemets en qualité high. Dix itérations en 1K plus un seul rendu maître en 4K ($0.1575) reviennent à $0.6825 au total, contre $1.7325 si vous aviez exécuté les onze appels en 4K.
Les prix et les conditions des produits peuvent évoluer. Vérifiez la tarification actuelle de chaque fournisseur avant de prendre une décision d'achat. La tarification Google Batch ou Flex n'est pas directement équivalente à une requête API standard à la demande car la planification, la disponibilité et les conditions de traitement diffèrent ; elle est donc exclue de cette comparaison. Il s'agit d'une comparaison ciblée et non d'une affirmation selon laquelle E2X serait l'option la moins chère au monde dans toutes les configurations.
Ce qui change dans GPT Image 2.6 Flare par rapport à Sunburst et 2.5
Le tarif est identique entre GPT Image 2.6 Flare, GPT Image 2.6 Sunburst et GPT Image 2.5 Flare ($0.0525 en 1K, $0.105 en 2K, $0.1575 en 4K) ; votre choix repose donc sur quatre évolutions architecturales de la version 2.6 :
- Sorties
.gif animées et .svg vectorielles natives (output_format). En plus de png (par défaut), jpeg et webp, openai/gpt-image-2.6-flare/text-to-image accepte output_format: "gif" et output_format: "svg". Choisir "gif" génère des animations multi-images en boucle directement à partir d'un prompt texte (les schémas amont prennent en charge de 2 à 16 images et une durée de 20 à 2 000 ms par image, en alignant les dimensions sur des multiples de 16). Choisir "svg" produit des graphiques vectoriels XML <svg> propres et évolutifs pour les icônes, badges et illustrations d'interface.
- Inférence 2× à 2.5× plus rapide sur 3 niveaux de qualité (
low, medium, high). GPT Image 2.6 Flare se concentre sur la génération à haut débit (~6 secondes en qualité low) sur les niveaux low, medium (par défaut) et high. Lorsque vous avez besoin des niveaux xhigh ou max pour des écorchés mécaniques complexes ou des affiches denses à plusieurs paragraphes, passez sur GPT Image 2.6 Sunburst exactement au même tarif de $0.0525 (1K).
- 15 formats d'image fixes et planification spatiale. GPT Image 2.6 Flare prend en charge 15 ratios d'aspect (
1:1, 1:2, 2:1, 1:3, 3:1, 2:3, 3:2, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 9:21, 21:9), avec 1:1 par défaut, appuyé par une planification spatiale préalable au dessin (complexity : low, medium, high).
- Jusqu'à 16 images de référence sur
edit-image. La route associée GPT Image 2.6 Flare edit-image étend image_urls de 10 à 16 images de référence avec des prompts delta de 50 000 caractères, la retouche par masque (mask_image) et le guidage par annotations visuelles (markup_image).
Soumettre une tâche de génération via l'API E2X
Chaque modèle sur E2X utilise la même file d'attente asynchrone. Envoyez une charge utile JSON via POST à https://api.e2x.ai/v1/jobs/submit avec votre jeton Bearer et interrogez https://api.e2x.ai/v1/jobs/{jobId} jusqu'à ce que le statut atteigne completed, ou transmettez une webhookUrl dans la requête initiale.
Seul prompt est obligatoire (jusqu'à 32 000 caractères). Voici un exemple curl qui génère une mascotte .gif animée en résolution 1K et qualité high ($0.0525) :
curl -X POST https://api.e2x.ai/v1/jobs/submit \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.6-flare/text-to-image",
    "input": {
      "prompt": "A cute 3D isometric cyber-robot mascot character waving cheerfully beside a glowing cyan and gold neon badge reading \"e2x.ai\" in a sleek dark studio, smooth looping animation",
      "aspect_ratio": "1:1",
      "resolution": "1K",
      "quality": "high",
      "output_format": "gif"
    }
  }'
Pour une génération matricielle haute résolution ou vectorielle .svg, réglez output_format sur "png", "webp" ou "svg" et passez resolution à 2K ($0.105) ou 4K ($0.1575) dans votre code Node.js :
const headers = {
  Authorization: `Bearer ${process.env.E2X_API_KEY}`,
  "Content-Type": "application/json",
};

const submitRes = await fetch("https://api.e2x.ai/v1/jobs/submit", {
  method: "POST",
  headers,
  body: JSON.stringify({
    model: "openai/gpt-image-2.6-flare/text-to-image",
    input: {
      prompt: 'Editorial cyberpunk night photograph of a matte-black carbon-fiber motorcycle helmet on a neon street podium with glowing cyan-white LED typography reading "e2x.ai" across the visor, electric blue anamorphic lens flare.',
      aspect_ratio: "16:9",
      resolution: "2K",
      quality: "high",
      output_format: "png",
    },
  }),
});

const { data: submitted } = await submitRes.json();

for (let poll = 0; poll < 120; poll++) {
  await new Promise((r) => setTimeout(r, 3000));
  const statusRes = await fetch(
    `https://api.e2x.ai/v1/jobs/${submitted.jobId}`,
    { headers }
  );
  const { data: job } = await statusRes.json();

  if (job.status === "completed") {
    console.log("Generated asset URL:", job.outputs[0].url);
    break;
  }
  if (job.status === "failed" || job.status === "cancelled") {
    throw new Error(job.error?.message || `Job ended with status ${job.status}`);
  }
}
Deux détails d'implémentation à garder à l'esprit : les valeurs de resolution doivent être en majuscules (1K, 2K, 4K), et les URL renvoyées dans data.outputs doivent être copiées dans votre propre compartiment de stockage si vous prévoyez de les servir à long terme. Le schéma complet est publié dans notre spécification de modèle lisible par machine, et les bibliothèques clientes officielles sont répertoriées sur la page des SDK E2X.
Choisir le bon modèle text-to-image sur E2X
Sélectionnez parmi nos points de terminaison OpenAI et Google selon que votre pipeline privilégie la vitesse, les détails xhigh/max, la synthèse native .gif et .svg, les détourages PNG transparents ou les bannières 4K économiques :
| Modèle | Prix 1K | Prix 4K | Résolution max. | Formats de sortie | Cas d'usage idéal |
|---|
| GPT Image 2.6 Flare | $0.0525 | $0.1575 | 4K | png, jpeg, webp, gif, svg | Génération rapide à 3 niveaux (low, medium, high), GIF animés, SVG vectoriels, flux d'interface interactifs |
| GPT Image 2.6 Sunburst | $0.0525 | $0.1575 | 4K | png, jpeg, webp, gif, svg | Qualité phare à 5 niveaux (xhigh et max sans surcoût) pour typographie dense et détails macro |
| GPT Image 2.5 Flare | $0.0525 | $0.1575 | 4K | png, jpeg, webp | Flux 2.5 existants nécessitant aspect_ratio: "auto" |
| GPT Image 2 | $0.0525 | $0.1575 | 4K | png, jpeg, webp | Détourages PNG transparents natifs (background: "transparent") au même prix |
| Nano Banana 2.1 | $0.0300 | $0.0900 | 4K | png, jpeg, webp | Tarif 4K le plus bas ($0.09) et formats bannières extrêmes 8:1 / 1:8 |
| Nano Banana 2 Lite | $0.0238 | — | 1K | png, jpeg, webp | Génération 1K en lot à grand volume pour moins de 2,5 centimes |
Comparez chaque fonctionnalité côte à côte dans la catégorie text-to-image ou parcourez le catalogue complet des modèles E2X.
Contraintes et notes opérationnelles
- Limites de débit et concurrence : le point de terminaison autorise jusqu'à 100 requêtes par minute, 5 000 requêtes par heure, 50 000 requêtes par jour et 100 tâches simultanées par compte.
- Temps de traitement : les aperçus 1K de niveau
low peuvent s'achever en ~6 secondes, tandis que la qualité high, la génération .gif multi-images et les étapes de mise à l'échelle 2K/4K prennent en moyenne de 15 à 60 secondes. Utilisez des webhooks ou un intervalle d'interrogation de 3 secondes en production.
- Limites de ratios d'aspect : les 15 ratios pris en charge vont des cadres horizontaux
3:1 et 21:9 aux cadres verticaux 1:3 et 9:21 (1:1, 1:2, 2:1, 1:3, 3:1, 2:3, 3:2, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 9:21, 21:9). Si une mise en page exige des bannières 4:1 ou 8:1, orientez cette tâche vers Nano Banana 2.1.
- Métadonnées de provenance : les sorties de la famille d'images OpenAI intègrent les métadonnées de provenance C2PA standard et des marqueurs d'attribution au niveau des pixels que les plateformes sociales lisent pour afficher les étiquettes de génération par IA.
Conseils de rédaction de prompts pour GPT Image 2.6 Flare
Avec une limite de 32 000 caractères, rédigez des phrases déclaratives directes ordonnées du sujet principal vers l'éclairage et les indications de format :
- Sujet et finition de surface en premier : nommez l'objet central, sa texture matérielle et l'angle de prise de vue ("matte-black carbon-fiber motorcycle helmet centered on a rain-slicked neon street podium").
- Texte exact entre guillemets : encadrez le texte des badges, les enseignes de magasins ou les étiquettes d'interface par des guillemets doubles et demandez
quality: "high" pour que le lettrage soit net et sans dérive de caractères.
- Boucles de mouvement pour
output_format: "gif" : précisez un objet d'ancrage fixe accompagné d'une action cyclique continue ("waving cheerfully beside a glowing neon badge, smooth looping animation") pour obtenir des boucles GIF multi-images fluides.
- Structure vectorielle pour
output_format: "svg" : demandez des formes géométriques plates, des contours nets et des palettes de couleurs unies ("clean geometric vector emblem badge, crisp flat vector paths") lors de l'export de SVG évolutifs.
Pour une analyse détaillée de la façon dont les modèles OpenAI et Google interprètent la structure des prompts, consultez notre guide de sélection de générateur d'images et notre guide d'automatisation de pipeline de génération d'images.
Foire aux questions
Combien coûte GPT Image 2.6 Flare text-to-image sur E2X ?
Avec notre remise de 75 %, GPT Image 2.6 Flare coûte $0.0525 par image à resolution: "1K" (par défaut), $0.105 par image à resolution: "2K" et $0.1575 par image à resolution: "4K", que vous sélectionniez la qualité low, medium ou high ou le format de sortie png, jpeg, webp, gif ou svg.
Le tarif de base catalogue est de $0.03 par requête, que notre remise globale de 75 % abaisse à $0.0075. Chaque réglage quality (low, medium, high) applique un multiplicateur ×7 ($0.0075 × 7 = $0.0525), et resolution multiplie le tout (1K = ×1, 2K = ×2, 4K = ×3).
Passer la qualité de low ou medium à high coûte-t-il plus cher ?
Non. Les trois niveaux de qualité (low, medium, high) portent le même multiplicateur ×7 sur E2X ($0.0525 en 1K). Seul le paramètre resolution (1K, 2K, 4K) modifie votre facture par image. Utilisez low lorsque vous souhaitez des brouillons rapides en ~6 secondes, et high pour les rendus finaux. Si vous avez besoin des niveaux xhigh ou max, utilisez GPT Image 2.6 Sunburst exactement au même tarif.
Définissez "output_format": "gif" dans la charge utile d'entrée pour synthétiser un GIF animé multi-images en boucle à partir de votre prompt texte, ou définissez "output_format": "svg" pour produire des graphiques vectoriels XML <svg> propres. Les formats matriciels standard ("png", "jpeg", "webp") sont également pris en charge.
En quoi GPT Image 2.6 Flare diffère-t-il de GPT Image 2.6 Sunburst ?
GPT Image 2.6 Flare est optimisé pour la vitesse et la production à haut volume sur trois niveaux de qualité (low, medium, high), s'exécutant jusqu'à 2× à 2.5× plus vite que 2.5 Flare. GPT Image 2.6 Sunburst ajoute les niveaux xhigh et max pour un raisonnement spatial plus poussé et une micro-typographie dense. Les deux modèles coûtent exactement le même prix de $0.0525 en 1K sur E2X.
Il accepte 15 ratios d'aspect fixes, avec 1:1 par défaut lorsqu'il est omis : 1:1, 1:2, 2:1, 1:3, 3:1, 2:3, 3:2, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 9:21 et 21:9.
Quelles sont la longueur maximale de prompt et la limite d'images de référence ?
Le champ prompt accepte jusqu'à 32 000 caractères sur openai/gpt-image-2.6-flare/text-to-image. Si vous avez besoin de jusqu'à 50 000 caractères accompagnés de jusqu'à 16 images de référence (image_urls), utilisez le point de terminaison associé GPT Image 2.6 Flare edit-image.
 Image
 openaiNouveau