API de Texto para Imagem do GPT Image 2.6 Flare na E2X
O GPT Image 2.6 Flare é o endpoint de produção de texto para imagem de alta velocidade da OpenAI na E2X, servido em openai/gpt-image-2.6-flare/text-to-image. Construído para pipelines criativos de baixa latência e aplicações interativas, ele roda até 2×–2.5× mais rápido que o GPT Image 2.5 Flare (~6 segundos na qualidade low) mantendo nosso desconto permanente de 75% ($0.0525 por imagem em resolution: "1K" contra $0.211 pela requisição equivalente de nível alto na fal.ai). O GPT Image 2.6 Flare suporta geração nativa de .gif animado multiframe (output_format: "gif"), geração de caminhos vetoriais escaláveis .svg (output_format: "svg") e três níveis de qualidade otimizados (low, medium, high) nas resoluções 1K, 2K e 4K. Como todas as três configurações de qualidade compartilham o mesmo multiplicador ×7 na E2X, você pode solicitar high em 1K exatamente pelos mesmos $0.0525 de low.
Quando uma carga de trabalho exigir os níveis de raciocínio mais pesados xhigh ou max para plantas arquitetônicas densas ou tipografia microgravada, direcione a requisição para GPT Image 2.6 Sunburst text-to-image exatamente pelo mesmo preço. Se o seu fluxo de trabalho começa com imagens de referência existentes, packshots de produtos ou anotações de layout, chame GPT Image 2.6 Flare edit-image (Sunburst edit-image), que aceita até 16 imagens de referência via image_urls pela mesma tarifa de $0.0525 (1K).
Galeria de amostras visuais e GIFs animados
Cada visual abaixo foi gerado pelo pipeline do GPT Image 2.6 e hospedado na CDN da E2X (assets.e2x.ai), demonstrando as animações .gif multiframe em loop do Flare, renderizações comerciais nítidas de produtos, caminhos vetoriais .svg escaláveis e uma comparação lado a lado com o Sunburst Max.
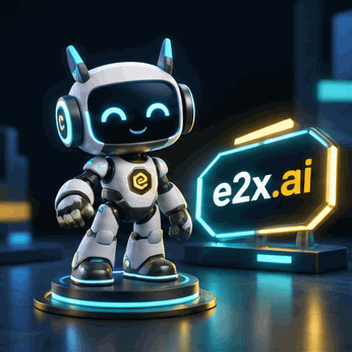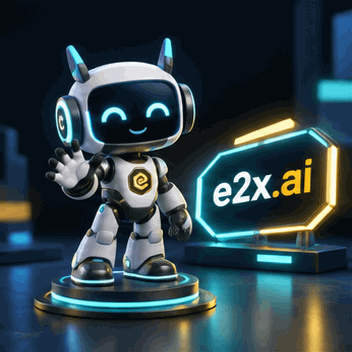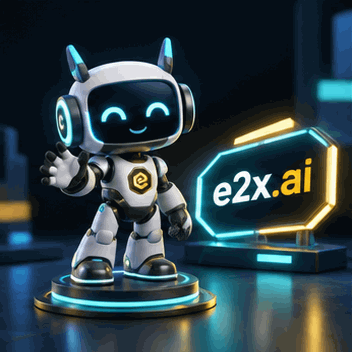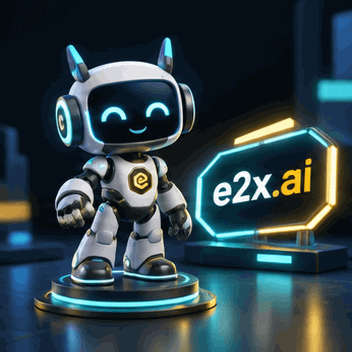
- Endpoint:
openai/gpt-image-2.6-flare/text-to-image (output_format: "gif", aspect_ratio: "1:1", frame_count: 8, frame_duration_ms: 150, 352×352)
- Prompt:
"A cute 3D isometric cyber-robot mascot character waving cheerfully beside a glowing cyan and gold neon badge reading \"e2x.ai\" in a sleek dark studio, smooth looping animation"
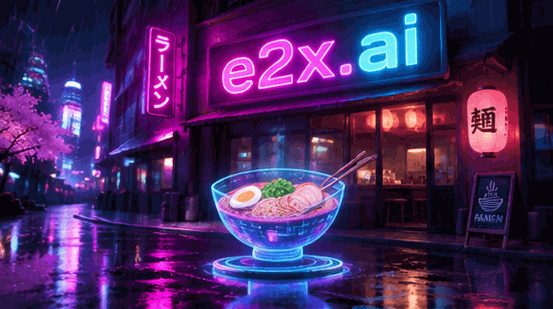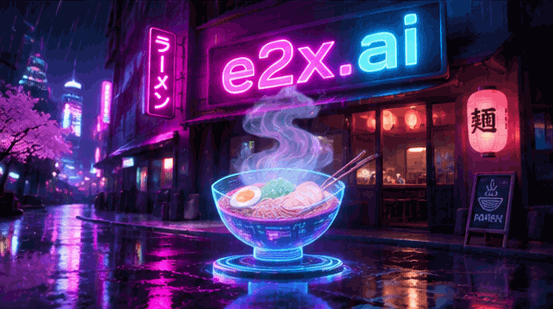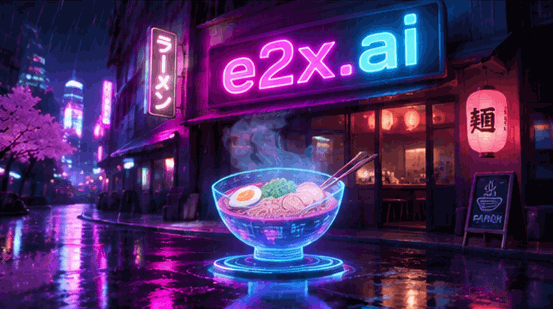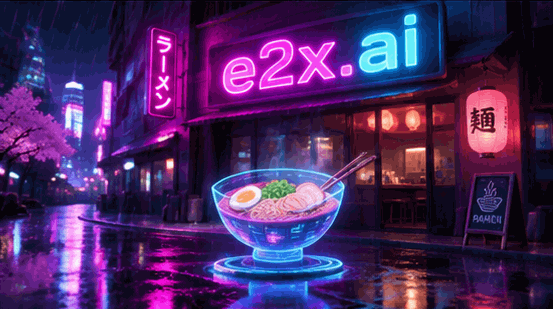
- Endpoint:
openai/gpt-image-2.6-flare/text-to-image (output_format: "gif", aspect_ratio: "16:9", 553×309)
- Prompt:
"Generate an animated GIF of a glowing neon cyberpunk ramen shop sign at night with animated rising steam from a holographic bowl and flickering magenta and cyan rain reflections, crisp neon text reading \"e2x.ai\", looping multi-frame animation"
Foto comercial de produto em alta velocidade: capacete de fibra de carbono (aspect_ratio: "1:1")
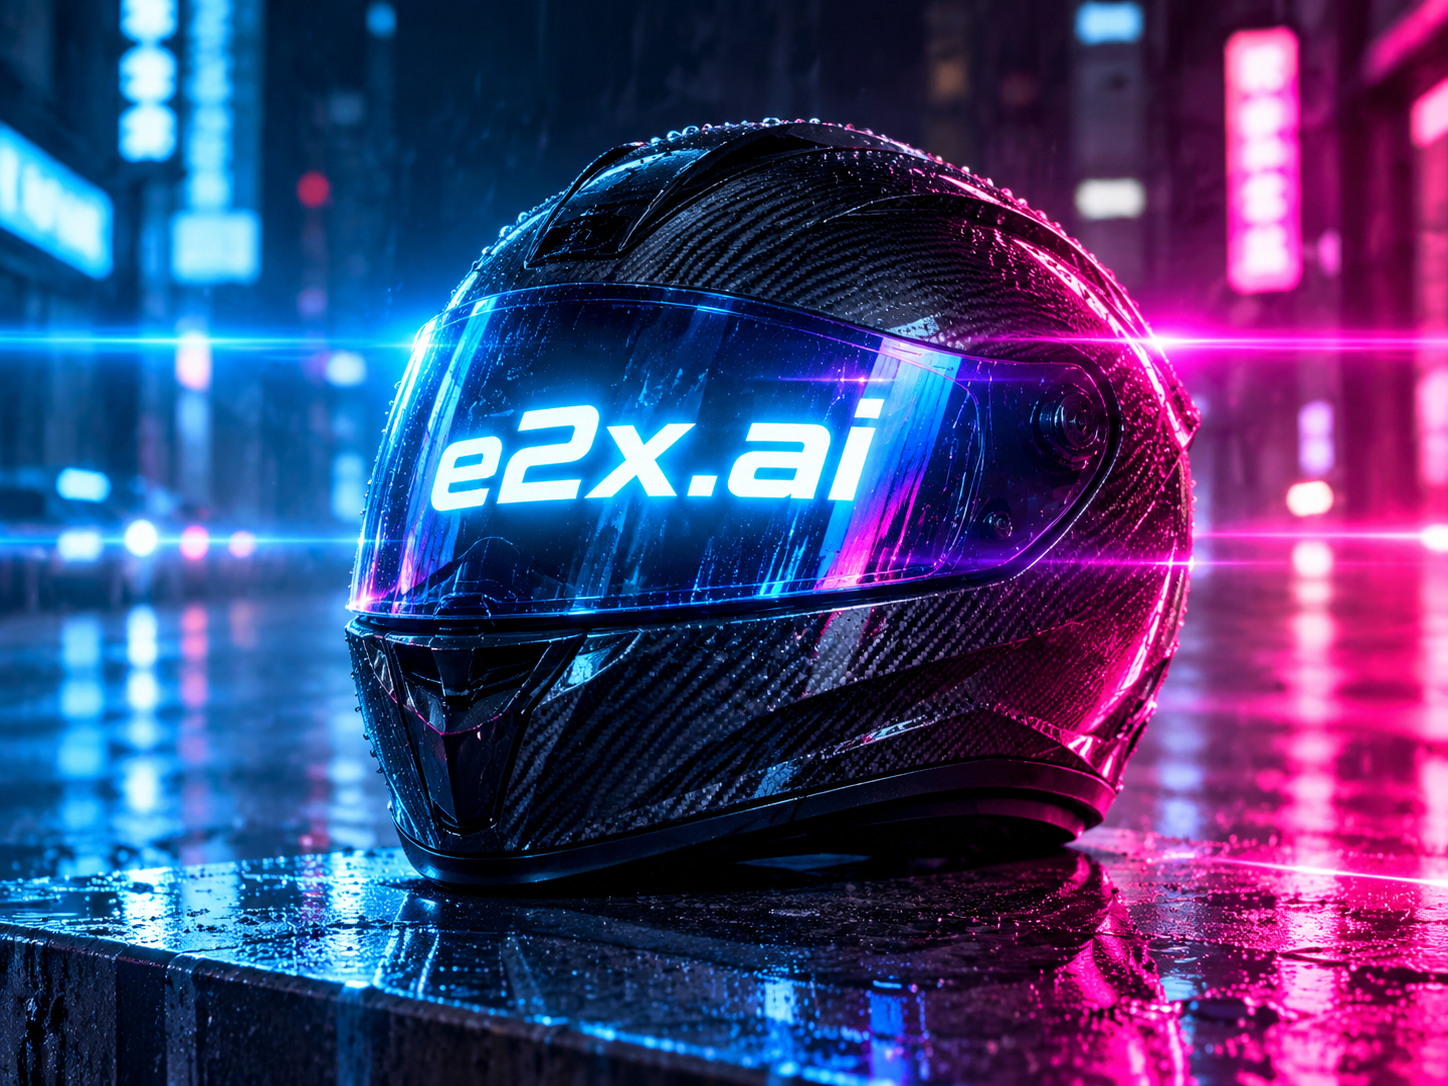
- Endpoint:
openai/gpt-image-2.6-flare/text-to-image (output_format: "png", aspect_ratio: "1:1", resolution: "1K", quality: "high")
- Prompt:
"An eye-catching editorial cyberpunk night photograph of a sleek futuristic matte-black carbon-fiber motorcycle helmet resting on a rain-slicked neon street podium in the center of the frame, with bold, crisp, ultra-legible glowing cyan-white LED typography reading \"e2x.ai\" illuminated across the curved iridescent visor. Dramatic electric blue and vibrant magenta anamorphic horizontal lens flares streak across the frame with neon bokeh reflections on the wet asphalt. Photorealistic 8K commercial shot."
- Formato de saída:
output_format: "svg" (aspect_ratio: "1:1", 1024×1024 XML <svg> escalável)
- Prompt:
"Clean geometric vector emblem badge for \"e2x.ai\" featuring a stylized radiant sunburst prism and orbital rings in vibrant gold, cyan, and deep obsidian navy, crisp flat vector paths"
Comparação lado a lado entre Sunburst Max e Flare High (aspect_ratio: "16:9")
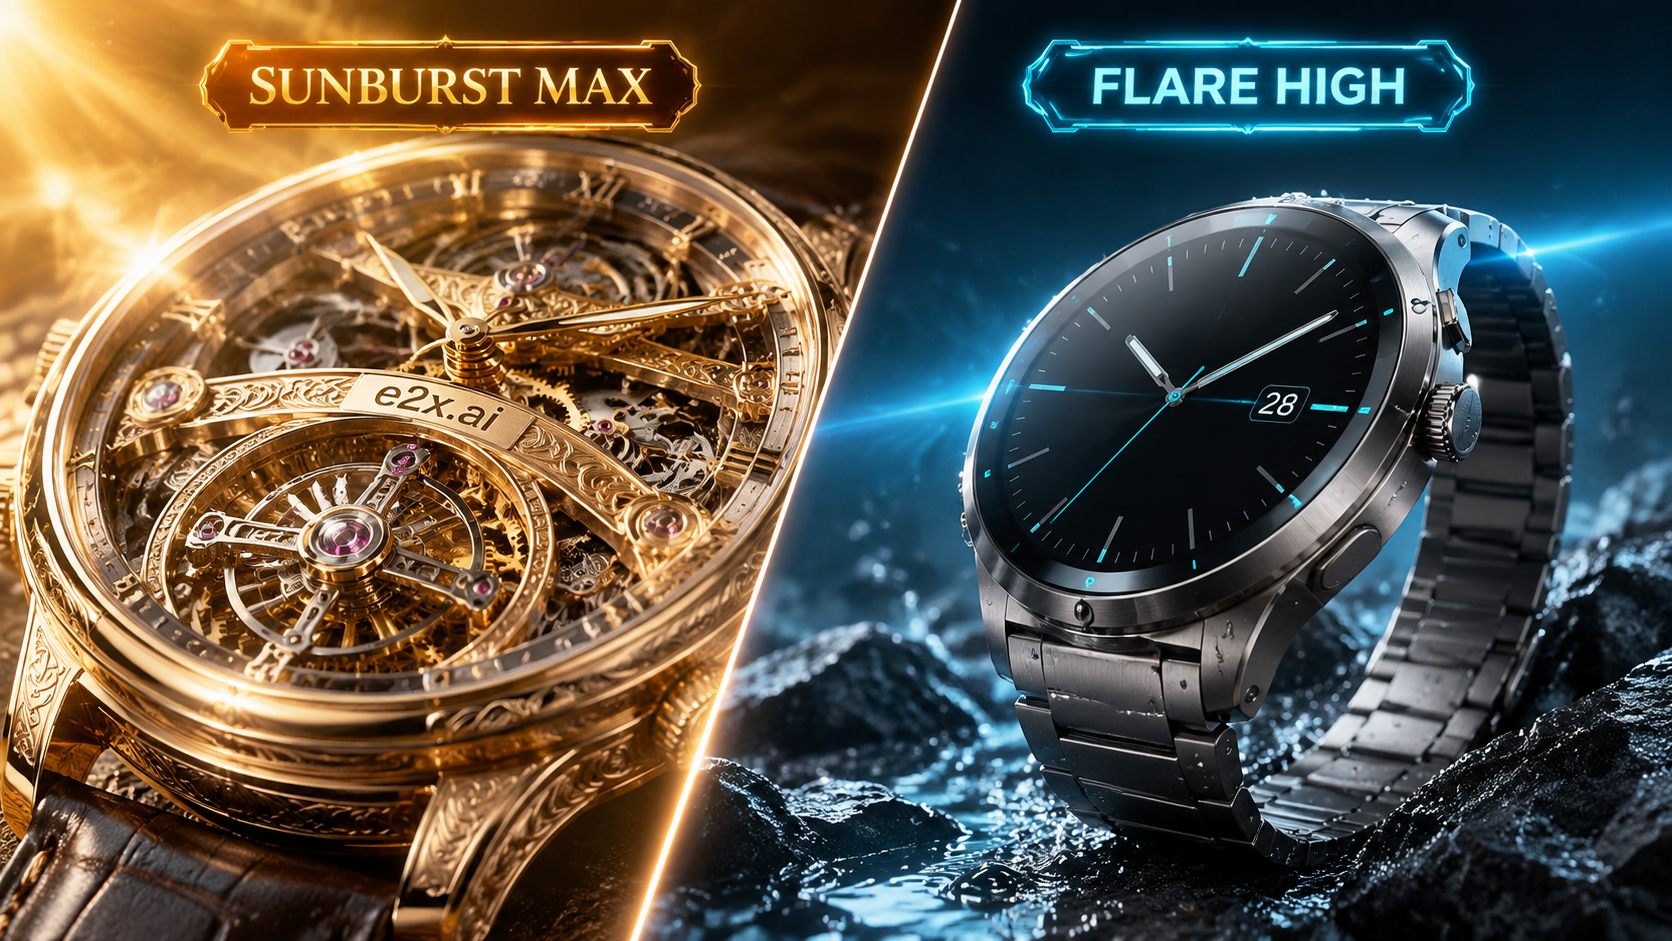
- Comparação visual (
16:9, 1672×941): Detalhe macro de turbilhão vazado no Sunburst Max vs fotografia comercial de produto em titânio de alto contraste no Flare High.
- Prompt:
"Split-screen visual comparison in a luxury studio: on the left side under a warm golden badge reading \"SUNBURST MAX\", an ultra-intricate macro photograph of an open-worked tourbillon mechanical watch with engraved gold bridges reading \"e2x.ai\" and warm sunburst lighting; on the right side under a sleek cyan badge reading \"FLARE HIGH\", a high-contrast commercial product shot of a matte titanium smartwatch on wet dark basalt with electric cyan lens flare"
Como os multiplicadores de resolução e qualidade afetam sua fatura
Cada chamada para openai/gpt-image-2.6-flare/text-to-image parte de uma tarifa base de tabela de $0.03 (30,000 microcentavos), reduzida pelo nosso desconto global permanente de 75% para uma base com desconto de $0.0075 (7,500 microcentavos), e depois multiplica por dois fatores do esquema:
- Multiplicador de
resolution: 1K (padrão) é ×1, 2K é ×2 e 4K é ×3.
- Multiplicador de
quality: low, medium (padrão) e high possuem todos um multiplicador ×7.
Como todo valor de quality (low, medium, high) multiplica a base com desconto de $0.0075 por 7, resolution é o único parâmetro que altera seu custo por imagem. Enviar quality: "low" cobra os mesmos $0.0525 em 1K que high, portanto você deve escolher low apenas quando quiser a menor latência possível de pré-visualização (~6 s), e usar high como padrão para ativos de produção sem custo adicional.
Confira a tabela de tarifas verificada em 6 de novembro de 2026 em comparação com as taxas sob demanda da fal.ai:
| Resolução | Multiplicador | Preço de tabela E2X ($0.03 × 7) | Preço E2X (75% off) | fal.ai (nível alto) | Economia na E2X |
|---|
1K (padrão) | ×1 × 7 | $0.21 | $0.0525 | $0.211 | 75% menor |
2K | ×2 × 7 | $0.42 | $0.1050 | $0.222 | 53% menor |
4K | ×3 × 7 | $0.63 | $0.1575 | $0.401 | 61% menor |
Essa curva define como você deve estruturar um pipeline iterativo. Mantenha resolution em 1K ($0.0525) enquanto testa composição, iluminação e textos entre aspas em high. Dez iterações em 1K mais uma única renderização mestre em 4K ($0.1575) somam $0.6825 no total, contra $1.7325 se você executasse todas as onze chamadas em 4K.
Os preços e os termos dos produtos podem mudar. Verifique os preços atuais de cada provedor antes de tomar uma decisão de compra. Os preços do Google Batch ou Flex não são diretamente equivalentes a uma solicitação de API padrão sob demanda, pois as condições de agendamento, disponibilidade e processamento diferem; portanto, estão excluídos desta comparação. Esta é uma comparação com escopo definido, e não uma afirmação de que a E2X é a opção mais barata do mundo em todas as configurações.
O que mudou no GPT Image 2.6 Flare em relação ao Sunburst e ao 2.5
O preço é idêntico entre GPT Image 2.6 Flare, GPT Image 2.6 Sunburst e GPT Image 2.5 Flare ($0.0525 em 1K, $0.105 em 2K, $0.1575 em 4K), então sua escolha se resume a quatro atualizações arquiteturais na versão 2.6:
- Saída nativa de
.gif animado e .svg vetorial (output_format). Além de png (padrão), jpeg e webp, openai/gpt-image-2.6-flare/text-to-image aceita output_format: "gif" e output_format: "svg". Definir "gif" gera animações multiframe em loop diretamente a partir de um prompt de texto (os esquemas suportam de 2 a 16 quadros e duração de 20 a 2,000 ms por quadro, ajustando as dimensões a múltiplos de 16). Definir "svg" gera gráficos de caminhos vetoriais XML <svg> limpos e escaláveis para ícones, emblemas e ilustrações de UI.
- Inferência 2×–2.5× mais rápida em 3 níveis de qualidade (
low, medium, high). O GPT Image 2.6 Flare foca na geração de alta vazão (~6 segundos na qualidade low) entre low, medium (padrão) e high. Quando você precisar dos níveis de qualidade xhigh ou max para cortes mecânicos complexos ou pôsteres densos com vários parágrafos, mude para o GPT Image 2.6 Sunburst exatamente pelo mesmo preço de $0.0525 (1K).
- 15 proporções fixas e planejamento espacial. O GPT Image 2.6 Flare suporta 15 proporções de tela (
1:1, 1:2, 2:1, 1:3, 3:1, 2:3, 3:2, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 9:21, 21:9), tendo 1:1 como padrão, apoiado por planejamento espacial pré-desenho (complexity: low, medium, high).
- Até 16 imagens de referência no
edit-image. A rota complementar GPT Image 2.6 Flare edit-image expande image_urls de 10 para 16 imagens de referência com prompts de edição de 50,000 caracteres, inpainting com máscara (mask_image) e orientação por markup visual (markup_image).
Enviando um job de geração via API da E2X
Todos os modelos na E2X usam a mesma fila assíncrona de jobs. Envie um payload JSON via POST para https://api.e2x.ai/v1/jobs/submit usando seu token Bearer e consulte https://api.e2x.ai/v1/jobs/{jobId} até que o status atinja completed, ou passe um webhookUrl no payload de envio.
Apenas prompt é obrigatório (até 32,000 caracteres). Aqui está um exemplo em curl que gera um mascote em .gif animado na resolução 1K e qualidade high ($0.0525):
curl -X POST https://api.e2x.ai/v1/jobs/submit \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.6-flare/text-to-image",
    "input": {
      "prompt": "A cute 3D isometric cyber-robot mascot character waving cheerfully beside a glowing cyan and gold neon badge reading \"e2x.ai\" in a sleek dark studio, smooth looping animation",
      "aspect_ratio": "1:1",
      "resolution": "1K",
      "quality": "high",
      "output_format": "gif"
    }
  }'
Para geração raster de alta resolução ou vetorial .svg, defina output_format como "png", "webp" ou "svg" e aumente resolution para 2K ($0.105) ou 4K ($0.1575) no seu código Node.js:
const headers = {
  Authorization: `Bearer ${process.env.E2X_API_KEY}`,
  "Content-Type": "application/json",
};

const submitRes = await fetch("https://api.e2x.ai/v1/jobs/submit", {
  method: "POST",
  headers,
  body: JSON.stringify({
    model: "openai/gpt-image-2.6-flare/text-to-image",
    input: {
      prompt: 'Editorial cyberpunk night photograph of a matte-black carbon-fiber motorcycle helmet on a neon street podium with glowing cyan-white LED typography reading "e2x.ai" across the visor, electric blue anamorphic lens flare.',
      aspect_ratio: "16:9",
      resolution: "2K",
      quality: "high",
      output_format: "png",
    },
  }),
});

const { data: submitted } = await submitRes.json();

for (let poll = 0; poll < 120; poll++) {
  await new Promise((r) => setTimeout(r, 3000));
  const statusRes = await fetch(
    `https://api.e2x.ai/v1/jobs/${submitted.jobId}`,
    { headers }
  );
  const { data: job } = await statusRes.json();

  if (job.status === "completed") {
    console.log("Generated asset URL:", job.outputs[0].url);
    break;
  }
  if (job.status === "failed" || job.status === "cancelled") {
    throw new Error(job.error?.message || `Job ended with status ${job.status}`);
  }
}
Duas notas de implementação importantes: os valores de resolution devem estar em letras maiúsculas (1K, 2K, 4K), e as URLs de saída retornadas em data.outputs devem ser copiadas para o seu próprio bucket de armazenamento caso você planeje servi-las no longo prazo. O esquema completo está publicado em nossa especificação do modelo legível por máquina, e as bibliotecas clientes oficiais estão listadas na página de SDKs da E2X.
Escolhendo o modelo certo de texto para imagem na E2X
Escolha entre nossos endpoints da OpenAI e do Google com base na prioridade do seu pipeline: velocidade, detalhes xhigh/max, síntese nativa .gif e .svg, recortes PNG transparentes ou banners 4K econômicos:
| Modelo | Preço 1K | Preço 4K | Resolução máx. | Formatos de saída | Melhor indicação |
|---|
| GPT Image 2.6 Flare | $0.0525 | $0.1575 | 4K | png, jpeg, webp, gif, svg | Geração de alta velocidade em 3 níveis (low, medium, high), GIFs animados, SVGs vetoriais, feeds de UI interativos |
| GPT Image 2.6 Sunburst | $0.0525 | $0.1575 | 4K | png, jpeg, webp, gif, svg | Qualidade principal de 5 níveis (xhigh e max sem custo extra) para tipografia densa e detalhes macro |
| GPT Image 2.5 Flare | $0.0525 | $0.1575 | 4K | png, jpeg, webp | Fluxos legados 2.5 que exigem aspect_ratio: "auto" |
| GPT Image 2 | $0.0525 | $0.1575 | 4K | png, jpeg, webp | Recortes PNG transparentes nativos (background: "transparent") pelo mesmo preço |
| Nano Banana 2.1 | $0.0300 | $0.0900 | 4K | png, jpeg, webp | Menor preço 4K ($0.09) e proporções extremas de banner 8:1 / 1:8 |
| Nano Banana 2 Lite | $0.0238 | — | 1K | png, jpeg, webp | Geração em lote 1K de alto volume por menos de 2.5 centavos |
Compare cada recurso lado a lado na categoria de texto para imagem ou navegue pelo catálogo completo de modelos da E2X.
Limites e notas operacionais
- Limites de taxa e concorrência: O endpoint permite até 100 requisições por minuto, 5,000 requisições por hora, 50,000 requisições por dia e 100 jobs simultâneos por conta.
- Tempo de processamento: Pré-visualizações 1K no nível
low podem ser concluídas em ~6 segundos, enquanto a qualidade high, a geração de .gif multiframe e as etapas de upscaling 2K/4K levam em média de 15 a 60 segundos. Use webhooks ou um intervalo de polling de 3 segundos em produção.
- Limites de proporção de tela: As 15 proporções suportadas vão de quadros horizontais
3:1 e 21:9 a quadros verticais 1:3 e 9:21 (1:1, 1:2, 2:1, 1:3, 3:1, 2:3, 3:2, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 9:21, 21:9). Se um layout exigir cabeçalhos em faixa 4:1 ou 8:1, direcione esse job para o Nano Banana 2.1.
- Metadados de proveniência: As saídas da família de imagens da OpenAI carregam metadados de proveniência C2PA padrão e marcadores de atribuição em nível de pixel que as plataformas sociais leem para exibir rótulos de geração por IA.
Dicas de prompt para o GPT Image 2.6 Flare
Com um limite de 32,000 caracteres, escreva frases declarativas diretas ordenadas do sujeito principal até a iluminação e as indicações de formato:
- Sujeito e acabamento de superfície primeiro: Nomeie o objeto central, a textura do material e o ângulo da câmera ("capacete de motocicleta de fibra de carbono preto fosco centralizado sobre um pódio de rua neon molhado pela chuva").
- Texto exato entre aspas: Coloque textos de emblemas, placas de lojas ou rótulos de UI entre aspas duplas e solicite
quality: "high" para que as letras sejam renderizadas com nitidez sem desvio de caracteres.
- Loops de movimento para
output_format: "gif": Especifique um objeto âncora estacionário mais uma ação cíclica contínua ("acenando alegremente ao lado de um emblema neon brilhante, animação fluida em loop") para obter loops GIF multiframe limpos.
- Estrutura vetorial para
output_format: "svg": Peça formas geométricas planas, contornos limpos e paletas de cores sólidas ("emblema vetorial geométrico limpo, caminhos vetoriais planos e nítidos") ao exportar SVGs escaláveis.
Para uma análise mais aprofundada de como os modelos da OpenAI e do Google interpretam a estrutura do prompt, veja nosso guia de seleção de geradores de imagens e nosso guia de pipeline de geração automatizada de imagens.
Perguntas frequentes
Quanto custa o texto para imagem do GPT Image 2.6 Flare na E2X?
Com nosso desconto de 75%, o GPT Image 2.6 Flare custa $0.0525 por imagem em resolution: "1K" (o padrão), $0.105 por imagem em resolution: "2K" e $0.1575 por imagem em resolution: "4K", independentemente de você selecionar a qualidade low, medium ou high ou o formato de saída png, jpeg, webp, gif ou svg.
Como o preço de $0.0525 é calculado a partir da tarifa base?
A tarifa base de tabela é de $0.03 por requisição, que nosso desconto global de 75% reduz para $0.0075. Cada configuração de quality (low, medium, high) aplica um multiplicador ×7 ($0.0075 × 7 = $0.0525), e resolution multiplica sobre esse valor (1K = ×1, 2K = ×2, 4K = ×3).
Mudar a qualidade de low ou medium para high custa mais caro?
Não. Todos os três níveis de qualidade (low, medium, high) possuem o mesmo multiplicador ×7 na E2X ($0.0525 em 1K). Apenas resolution (1K, 2K, 4K) altera o valor cobrado por imagem. Use low quando quiser rascunhos rápidos em ~6 segundos e use high para as renderizações finais. Se você precisar dos níveis de qualidade xhigh ou max, use o GPT Image 2.6 Sunburst exatamente pela mesma tarifa.
Defina "output_format": "gif" no payload de entrada para sintetizar um GIF animado multiframe em loop a partir do seu prompt de texto, ou defina "output_format": "svg" para gerar gráficos de caminhos vetoriais XML <svg> limpos. Os formatos raster padrão ("png", "jpeg", "webp") também são suportados.
Qual é a diferença entre o GPT Image 2.6 Flare e o GPT Image 2.6 Sunburst?
O GPT Image 2.6 Flare é ajustado para velocidade e produção de alto volume em três níveis de qualidade (low, medium, high), rodando até 2×–2.5× mais rápido que o 2.5 Flare. O GPT Image 2.6 Sunburst adiciona os níveis de qualidade xhigh e max para raciocínio espacial mais pesado e microtipografia densa. Ambos os modelos custam exatamente os mesmos $0.0525 em 1K na E2X.
Quais proporções de tela o GPT Image 2.6 Flare suporta?
Ele aceita 15 proporções fixas, usando 1:1 como padrão quando omitido: 1:1, 1:2, 2:1, 1:3, 3:1, 2:3, 3:2, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 9:21 e 21:9.
Qual é o tamanho máximo do prompt e o limite de imagens de referência?
O campo prompt aceita até 32,000 caracteres em openai/gpt-image-2.6-flare/text-to-image. Se você precisar de até 50,000 caracteres junto com até 16 imagens de referência (image_urls), use o endpoint complementar GPT Image 2.6 Flare edit-image.
 Imagem
 openaiNovo