Как писать промпты для GPT Image 2.5: типографика, негативное пространство и выбор high, xhigh или max
Большинство неудачных промптов, отправляемых в GPT Image 2.5 text-to-image, не работают по одной и той же причине: они написаны для диффузионных моделей 2022 года, а не для языковой архитектуры 2026 года. Когда вы передаете список шаблонных тегов через запятую ("coffee dripper, 8k, hyperrealistic, octane render, studio lighting, award winning") в эндпоинт, принимающий до 32 000 символов связного текста, вы оставляете 90% пространственных решений в кадре на волю статистической случайности.
GPT Image 2.5 не нуждается в абстрактных прилагательных качества. Ей нужен четкий пространственный бриф, написанный полными повествовательными предложениями, в паре с правильными параметрами схемы (aspect_ratio, resolution и quality: high, xhigh или max). А когда вы переключаетесь с /models/openai/gpt-image-2.5-sunburst/text-to-image на /models/openai/gpt-image-2.5-sunburst/edit-image, правила меняются на противоположные: повторное описание всей сцены при вызове редактирования приводит к нежелательному дрейфу деталей, тогда как лаконичный дельта-промпт надежно фиксирует ваше референсное изображение.
Ниже приведена точная четырехчастная структура промпта, которую мы используем в продакшен-пайплайнах на E2X, с примерами переработки «до и после», правилами оформления типографики, резервированием негативного пространства и практическим руководством по выбору между high, xhigh и max, когда все пять уровней качества стоят одинаковые $0.0525 в разрешении 1K.
Четырехчастная структура предложений, которой GPT Image 2.5 подчиняется лучше всего
При лимите в 32 000 символов в GPT Image 2.5 text-to-image и 50 000 символов в GPT Image 2.5 edit-image вам больше не нужно сжимать инструкции в обрывочные фразы. Пишите полными предложениями в той последовательности, в которой должен выстраиваться холст. Первые фразы задают геометрию камеры и главный объект, а последующие уточняют освещение, типографику и свободные поля.
Следуйте этому порядку из четырех частей:
- Объект + материал + позиция: назовите тип изображения и главный предмет, тактильную текстуру его поверхности и то, где именно он расположен в кадре (
"Matte ceramic pour-over coffee dripper centered on a brushed steel digital scale on a pale ash wood counter"). - Физический источник света + направление: укажите, что создает свет, под каким углом он падает и как ложатся тени (
"afternoon sunlight from camera left casting sharp shadows across the brackets"). - Текст в кавычках + обработка шрифта и поверхности: когда в кадре присутствуют вывески, этикетки или элементы UI, заключите точные символы в двойные кавычки и опишите стиль шрифта и материал подложки (
"crisp white sans-serif lettering reading \"PLATFORM 4 — EXPRESS TO GENEVA\" on deep Prussian blue enamel"). - Явное резервирование негативного пространства: укажите модели, какая треть или половина холста должна остаться пустой, чтобы ваша дизайн-команда могла позже наложить поверх HTML-текст или верстку в Figma (
"Keep the right third of the frame an uncluttered warm plaster wall for headline copy").
До и после: «суп из ключевых слов» против повествовательного пространственного брифа
Сравните, что происходит, когда вы заменяете общий список тегов на четырехчастную структуру предложений в трех типичных коммерческих задачах.
Задача 1: Главный баннер интернет-магазина с местом под текст
Weak prompt (keyword soup):
pour-over coffee maker, digital scale, minimalist kitchen, copy space on right,
product photography, 8k, photorealistic, soft lighting, clean background
Strong prompt (declarative brief):
Matte ceramic pour-over coffee dripper centered on a brushed steel digital scale on a pale ash wood counter. Keep the right third of the frame an uncluttered warm plaster wall for headline copy.
Почему переписанный вариант работает: тег "copy space on right" в списке через запятую редко останавливает генеративную модель от того, чтобы повесить в этом углу полку, растение или оконную раму. Указание конкретного материала пустой области ("an uncluttered warm plaster wall") дает модели четкую физическую поверхность, которую нужно отрендерить в правой трети холста.
Задача 2: Архитектурная вывеска со встроенным текстом
Weak prompt (unquoted text and vague style):
vintage blue train station sign that says platform 4 express to geneva,
retro typography, brass brackets, sunny day, ultra detailed
Strong prompt (exact quotes and surface physics):
Vintage enamel railway station platform sign in deep Prussian blue with crisp white sans-serif lettering reading "PLATFORM 4 — EXPRESS TO GENEVA", weathered brass mounting brackets, afternoon sunlight.
Почему переписанный вариант работает: если оставить целевые слова строчными и без кавычек (says platform 4 express to geneva), модель может перефразировать надпись, пропустить знаки препинания или выдумать лишние названия станций. Заключение строки "PLATFORM 4 — EXPRESS TO GENEVA" в двойные кавычки и указание "crisp white sans-serif lettering" жестко фиксируют как регистр букв, так и геометрию глифов.
Задача 3: Предметная раскладка с несколькими объектами на столе
Weak prompt (flat inventory list):
desk flatlay with anodized keyboard, walnut desk, orange escape key,
notebook, brass pen, daylight, sharp legends
Strong prompt (spatial hierarchy):
Overhead editorial photograph of an anodized aluminum mechanical keyboard centered on a dark walnut desk. Keycaps in matte charcoal with a single signal-orange Esc key at the top left corner of the board. Closed cream linen notebook resting parallel to the right edge of the keyboard, brass fountain pen centered on the cover. Soft north-window daylight from the upper left, crisp key legends, no other props.
Почему переписанный вариант работает: каждый второстепенный предмет привязан относительно главного объекта ("at the top left corner of the board", "parallel to the right edge"), что предотвращает наложение и пересечение геометрии.
Резервирование негативного пространства для заголовков и элементов UI
Одна из самых дорогостоящих ошибок в автоматизированных пайплайнах рекламы и лендингов — генерация центрированной композиции в формате 16:9 в надежде, что фронтенд-разработчик сможет разместить белый текст поверх левого или правого поля. Если вы явно не забронируете пустое место в промпте, GPT Image 2.5 заполнит всю ширину кадра второстепенным реквизитом, пестрым боке или драматичными градиентами теней, которые разрушат контрастность текста.
Вот результат рендеринга промпта с воронкой для кофе пуровер в GPT Image 2.5, демонстрирующий, как модель реагирует, когда вы явно назначаете поверхность стены для правой трети кадра:
Matte ceramic pour-over coffee dripper centered on a brushed steel digital scale on a pale ash wood counter. Keep the right third of the frame an uncluttered warm plaster wall for headline copy.
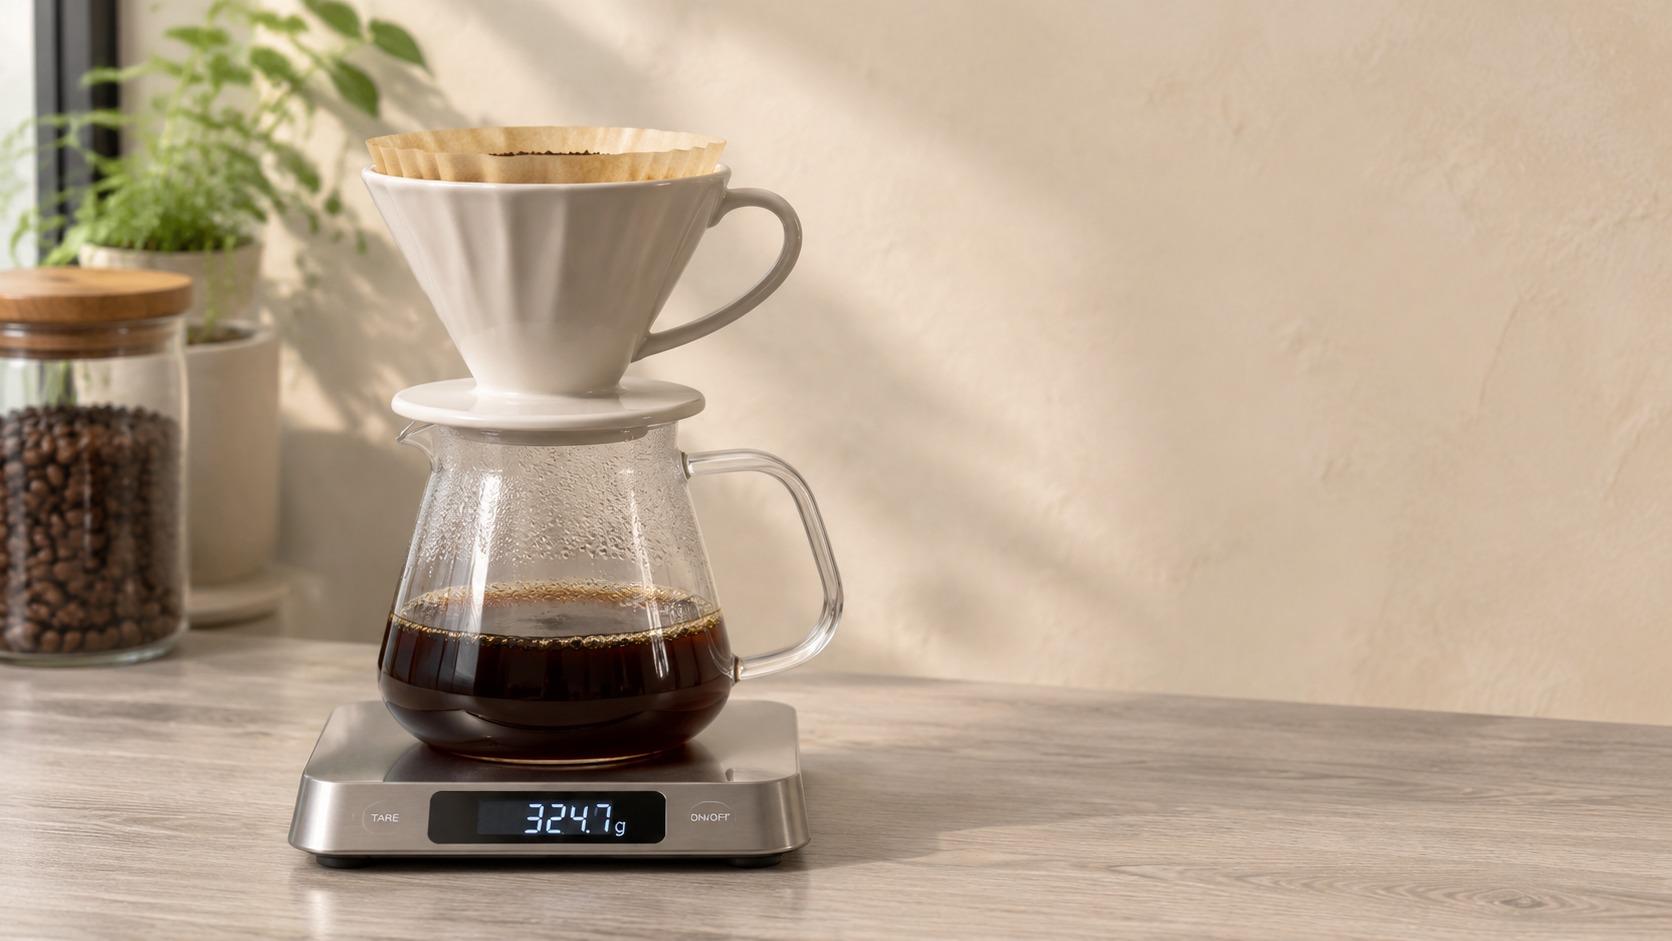
Посмотрите, как сцена распределяется по горизонтальной оси:
- Матовые керамические ребра воронки и платформа весов из шлифованной стали занимают левую и центрально-левую зоны, не обрезаясь у края кадра.
- Столешница из светлого ясеня плавно продолжается до правой границы, заземляя сцену, благодаря чему кадр не выглядит как склеенный из двух половин коллаж.
- Верхняя правая зона остается однородной теплой оштукатуренной поверхностью с мягким тональным переходом, готовой принять темную антикву или гротеск в HTML без необходимости подкладывать под слова полупрозрачную темную плашку.
Когда вы пишете инструкции для негативного пространства, всегда сочетайте пространственную долю ("the right third", "the upper quarter", "the left half") с конкретным материалом фона, который должен ее заполнять ("uncluttered warm plaster wall", "clear pale overcast sky", "seamless slate-gray studio sweep"). Объяснить модели, что именно находится на пустом месте, работает гораздо надежнее, чем просто написать "leave empty space".
Точное цитирование текста и управление типографикой на поверхностях
GPT Image 2.5 — самая сильная модель в каталоге E2X для рендеринга многословных вывесок, этикеток упаковки, книжных обложек и карточек UI. Чтобы получать чистые надписи с первой попытки, соблюдайте четыре механических правила всякий раз, когда ваш промпт содержит текст:
- Всегда заключайте точные символы в двойные кавычки: пишите
"PLATFORM 4 — EXPRESS TO GENEVA"именно в том верхнем или смешанном регистре, который вы хотите получить на рендере. - Описывайте гарнитуру через визуальное семейство и насыщенность, а не названия закрытых шрифтовых файлов: используйте формулировки вроде
"condensed bold grotesque sans-serif","high-contrast editorial Didone serif"или"hand-painted gold leaf sign-painter capitals". - Указывайте, как текст взаимодействует с физическим материалом: уточните, как нанесены буквы —
"screen-printed in matte black ink","stamped in recessed gold foil","enameled white on Prussian blue steel"или"backlit acrylic channel letters". - Предотвращайте появление случайного фонового мусора: если ваша сцена включает фоновые витрины, баночки или книги, на которых не должно быть выдуманных слов, завершите промпт фразой
"no other text or logos in the frame".
Вот результат генерации железнодорожной вывески в GPT Image 2.5 с применением этих правил:
Vintage enamel railway station platform sign in deep Prussian blue with crisp white sans-serif lettering reading "PLATFORM 4 — EXPRESS TO GENEVA", weathered brass mounting brackets, afternoon sunlight.
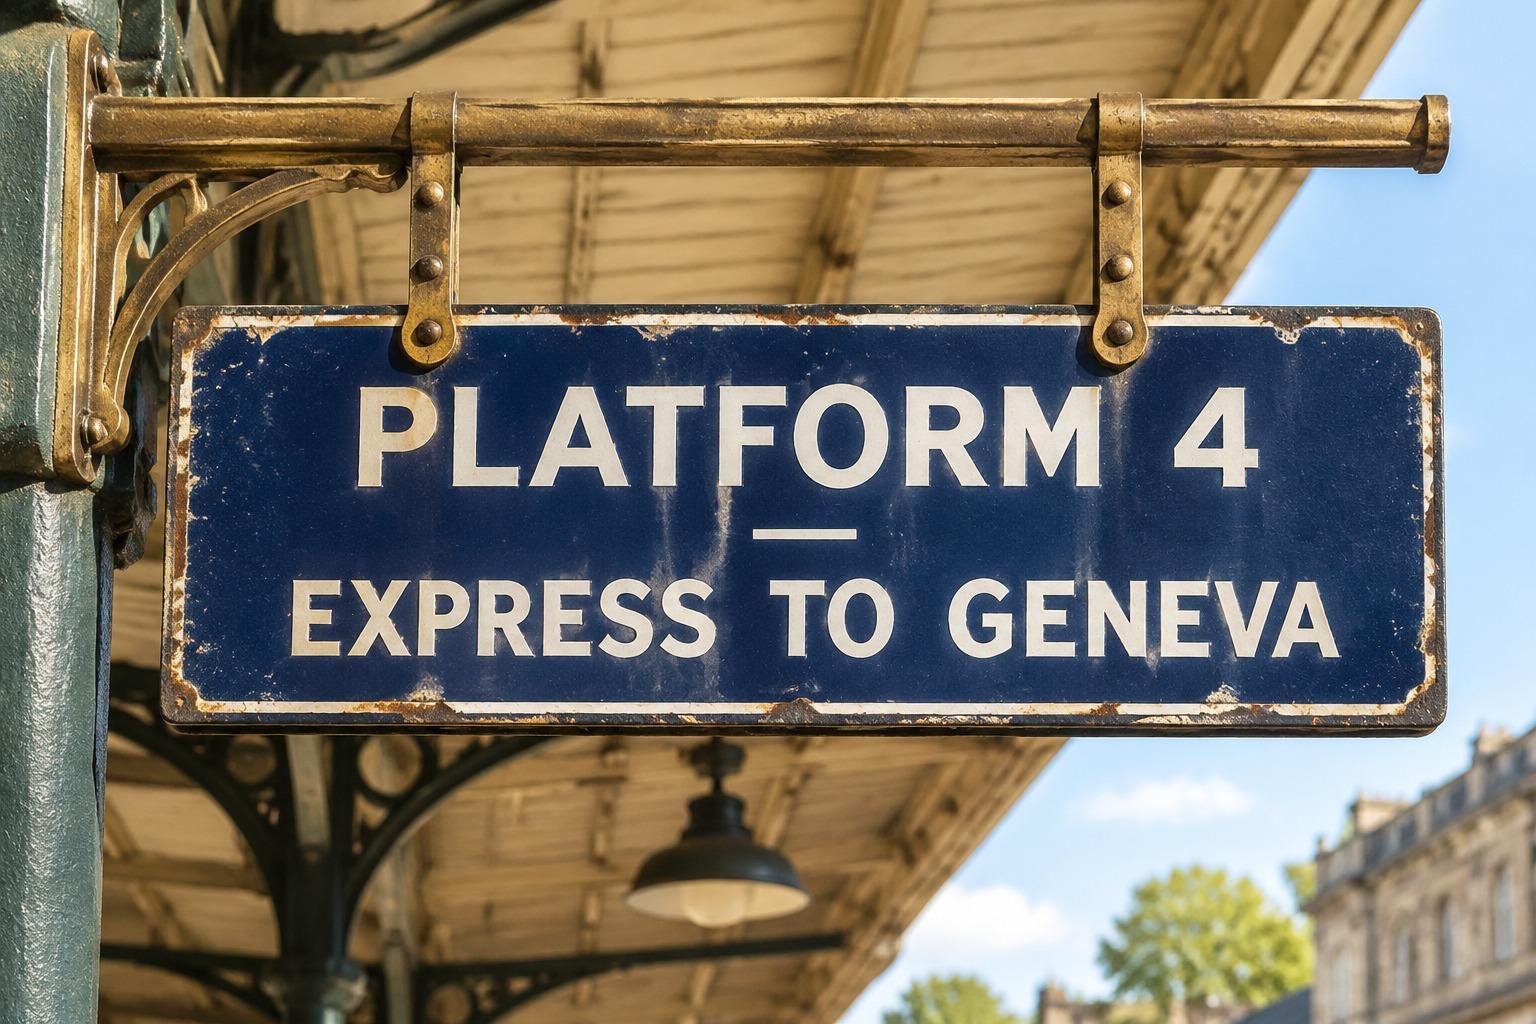
В этом рендере модель сохраняет отступы вокруг тире между PLATFORM 4 и EXPRESS TO GENEVA, выдерживает одинаковую толщину белого штриха без засечек по всей длине горизонтальной таблички и отрисовывает деликатные дневные блики как на синей эмалевой глазури, так и на белых окрашенных буквах. В то же время состаренные латунные крепежные кронштейны по углам демонстрируют следы окисления и проработку болтов, не залезая на внутреннюю рамку вывески.
Выбор между уровнями качества high, xhigh и max на E2X
В эндпоинтах /models/openai/gpt-image-2.5-sunburst/text-to-image и /models/openai/gpt-image-2.5-sunburst/edit-image параметр quality принимает пять значений: low, medium, high (значение схемы по умолчанию, если параметр опущен), xhigh и max. На E2X модель GPT Image 2.5 доступна в двух вариантах: GPT Image 2.5 Sunburst (openai/gpt-image-2.5-sunburst, поддерживающий разрешения 1K/2K/4K и уровни качества low, medium, high, xhigh, max) и GPT Image 2.5 Flare (openai/gpt-image-2.5-flare, поддерживающий /models/openai/gpt-image-2.5-flare/text-to-image и /models/openai/gpt-image-2.5-flare/edit-image с разрешениями 1K/2K/4K и уровнями качества low, medium, high).
Прежде чем решить, какую настройку передавать, разберемся, как E2X тарифицирует этот параметр. Каждый вызов начинается с базовой ставки прайс-листа $0.03, которую наша постоянная скидка 75% снижает до $0.0075. Далее:
- Любая настройка
quality(low,medium,high,xhighиmax) применяет один и тот же множитель ×7. - Параметр
resolutionприменяет множитель ×1 для1K($0.0525), ×2 для2K($0.1050) и ×3 для4K($0.1575).
Цены и условия предоставления продуктов могут меняться. Перед принятием решения о покупке проверяйте актуальные тарифы каждого провайдера. Пакетные тарифы Google Batch или Flex не являются прямым эквивалентом стандартного API-запроса по требованию (on-demand), поскольку условия планирования, доступности и обработки отличаются; по этой причине они исключены из данного сравнения. Это специализированное сравнение в рамках заданных условий, а не утверждение, что E2X является самым дешевым вариантом в мире в любой конфигурации.
Поскольку low, high, xhigh и max стоят одни и те же $0.0525 в 1K ($0.105 в 2K, $0.1575 в 4K), нет никакого финансового смысла отправлять low или medium. Ваш реальный инженерный компромисс при выборе между high, xhigh и max заключается в балансе между временем генерации (latency) и глубиной проработки мелких деталей:
| Настройка качества | Цена 1K на E2X | Цена 4K на E2X | Лучший сценарий использования |
|---|---|---|---|
high (по умолчанию) | $0.0525 | $0.1575 | Быстрые интерактивные превью, предметные снимки с одним объектом, чистые фоны с негативным пространством |
xhigh | $0.0525 | $0.1575 | Вывески витрин, этикетки косметических флаконов, настольные композиции с несколькими предметами, портреты с мелкой текстурой кожи и ткани |
max | $0.0525 | $0.1575 | Насыщенные многострочные постеры, детальные механические и архитектурные разрезы, финальные мастер-рендеры в 2K/4K |
На практике используйте quality: "high" с resolution: "1K", когда пользователь интерактивно ждет результат на холсте интерфейса, а в вашем промпте нет мелкого текста. Используйте quality: "xhigh" в 1K ($0.0525) всякий раз, когда промпт включает типографику в кавычках или несколько взаимодействующих объектов. Переключайтесь на quality: "max" в 2K ($0.105) или 4K ($0.1575) при рендеринге финального продакшен-мастера в фоновой очереди воркеров.
Дельта-промптинг для edit-image против описания полной сцены для text-to-image
Составление промптов для GPT Image 2.5 edit-image требует иной ментальной модели, чем работа с text-to-image. Когда вы передаете одно или несколько исходных изображений в image_urls, визуальная сцена уже существует. Если ваш промпт заново описывает всю комнату, освещение и объектив камеры с нуля, модель воспринимает эти предложения как инструкцию перегенерировать указанные области, что приводит к нежелательному дрейфу лиц, текстур или перспективы.
Пишите промпт для edit-image как строгую дельту (список изменений) из трех компонентов:
- Явно указывайте индекс исходного изображения: передавая несколько URL в
image_urls, ссылайтесь на них как на"image 1","image 2"и"image 3". - Формулируйте точную модификацию: описывайте только тот элемент, который меняется, включая новый текст в кавычках, если вы обновляете вывеску или этикетку.
- Зафиксируйте все остальное: явно перечислите окружающие элементы, которые должны остаться нетронутыми.
Сравните промпт полной сцены для text-to-image с соответствующим дельта-промптом для edit-image:
Full-scene prompt (for openai/gpt-image-2.5-sunburst/text-to-image):
Vintage enamel railway station platform sign in deep Prussian blue with crisp white sans-serif lettering reading "PLATFORM 4 — EXPRESS TO GENEVA", weathered brass mounting brackets, afternoon sunlight.
Delta edit prompt (for openai/gpt-image-2.5-sunburst/edit-image):
In image 1, change the white sans-serif lettering on the Prussian blue enamel sign to read "PLATFORM 9 — NIGHT TRAIN TO MILAN" in the exact same font weight, kerning, and enamel surface gloss. Keep the weathered brass mounting brackets, afternoon sunlight angle, and background masonry completely unchanged.
Отправьте этот запрос на дельта-редактирование через POST https://api.e2x.ai/v1/jobs/submit, оставив aspect_ratio: "auto", чтобы выходной файл точно соответствовал пропорциям входного изображения:
curl -X POST https://api.e2x.ai/v1/jobs/submit \
  -H "Authorization: Bearer $E2X_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.5-sunburst/edit-image",
    "input": {
      "prompt": "In image 1, change the white sans-serif lettering on the Prussian blue enamel sign to read \"PLATFORM 9 — NIGHT TRAIN TO MILAN\" in the exact same font weight, kerning, and enamel surface gloss. Keep the weathered brass mounting brackets, afternoon sunlight angle, and background masonry completely unchanged.",
      "image_urls": [
        "https://assets.e2x.ai/assets/posts/gpt-image-2-5-prompting-guide/example-2.jpg"
      ],
      "aspect_ratio": "auto",
      "resolution": "2K",
      "quality": "max"
    }
  }'
Помните о двух правилах схемы при переходе между генерацией и редактированием на E2X:
- Эндпоинт
openai/gpt-image-2.5-sunburst/edit-imageпринимает промпты длиной до 50 000 символов (по сравнению с 32 000 уtext-to-image), поэтому скрипты автоматической локализации могут передавать полные правила верстки без обрезки текста. - Ни один из эндпоинтов GPT Image 2.5 не включает параметр
background: "transparent". Если предметному снимку требуется вырезка с альфа-каналом за один API-вызов, направьте эту задачу в GPT Image 2 text-to-image или GPT Image 2 edit-image по той же цене $0.0525 (1K).
Чтобы изучить прямые сравнения моделей, прочитайте наши обзоры GPT Image 2.5 против Nano Banana 2.1 и GPT Image 2.5 против FLUX.2 Pro и Max, или загляните в наше руководство по промптингу для Nano Banana. Вы также можете просмотреть спецификации параметров в файлах llms.txt для text-to-image и llms.txt для edit-image, либо изучить все доступные модели в каталоге E2X.
Часто задаваемые вопросы
Какой порядок предложений лучше всего подходит для промпта GPT Image 2.5?
Начинайте с главного объекта, материала его поверхности и расположения в кадре. Далее укажите физический источник света и направление теней, затем задайте точный встроенный текст в двойных кавычках вместе со стилем шрифта и характером поверхности, а в конце явно зарезервируйте негативное пространство (назвав как долю кадра, так и чистую фоновую поверхность).
Почему GPT Image 2.5 допускает опечатки в словах, когда я не использую кавычки?
Когда целевые слова написаны внутри строки без кавычек, языковой слой кондиционирования может воспринять их как тематическое описание сцены, а не как буквальную последовательность символов. Заключение точной строки в двойные кавычки (reading "PLATFORM 4 — EXPRESS TO GENEVA"), указание стиля шрифта ("crisp white sans-serif lettering") и установка quality в значение xhigh или max дают модели четкую команду отрисовать именно эти глифы.
Стоит ли всегда использовать качество max в GPT Image 2.5, раз оно стоит столько же, сколько high?
На платформе E2X значения low, medium, high, xhigh и max имеют один и тот же множитель ×7 ($0.0525 в 1K, $0.105 в 2K, $0.1575 в 4K). Используйте xhigh или max всякий раз, когда ваш промпт содержит встроенную типографику, тонкие текстуры кожи или ткани либо сложные пространственные связи между несколькими предметами. Оставайтесь на уровне high, когда вам важна более высокая скорость отклика на простых черновиках с одним объектом или чистых фоновых подложках.
Как зарезервировать чистое место под наложение HTML-текста?
Укажите одновременно долю кадра и конкретную физическую поверхность, которая должна заполнить эту пустую зону, например: "Keep the right third of the frame an uncluttered warm plaster wall for headline copy" или "Keep the upper half a clear pale overcast sky with no clouds or objects". Указание конкретной поверхности не дает модели заполнить пространство случайным фоновым реквизитом.
Чем промпт для edit-image должен отличаться от промпта для text-to-image?
Для /models/openai/gpt-image-2.5-sunburst/text-to-image описывайте всю сцену с нуля (до 32 000 символов). Для /models/openai/gpt-image-2.5-sunburst/edit-image (до 50 000 символов) пишите только дельту изменений: сошлитесь на входной файл по номеру ("In image 1..."), укажите точный изменяемый элемент или текст в кавычках и явно прикажите модели оставить все остальные объекты, освещение и ракурс камеры без изменений.