API Text-to-Image di GPT Image 2.6 Flare su E2X
GPT Image 2.6 Flare è l'endpoint text-to-image di produzione ad alta velocità di OpenAI su E2X, disponibile su openai/gpt-image-2.6-flare/text-to-image. Progettato per pipeline creative a bassa latenza e applicazioni interattive, gira fino a 2×–2.5× più velocemente rispetto a GPT Image 2.5 Flare (~6 secondi a qualità low) mantenendo il nostro sconto fisso del 75% ($0.0525 per immagine a resolution: "1K" contro $0.211 per la richiesta equivalente di fascia alta su fal.ai). GPT Image 2.6 Flare supporta la generazione nativa di .gif animate multi-frame (output_format: "gif"), la generazione di tracciati vettoriali scalabili .svg (output_format: "svg") e tre livelli di qualità ottimizzati (low, medium, high) alle risoluzioni 1K, 2K e 4K. Poiché tutte le tre impostazioni di qualità condividono lo stesso moltiplicatore ×7 su E2X, puoi richiedere high in 1K esattamente agli stessi $0.0525 di low.
Quando un carico di lavoro richiede i livelli di ragionamento più spinti xhigh o max per progetti architettonici densi o tipografia micro-incisa, indirizza la richiesta a GPT Image 2.6 Sunburst text-to-image esattamente allo stesso prezzo. Se il tuo flusso di lavoro parte da immagini di riferimento esistenti, packshot di prodotto o annotazioni di layout, chiama GPT Image 2.6 Flare edit-image (Sunburst edit-image), che accetta fino a 16 immagini di riferimento tramite image_urls alla stessa tariffa di $0.0525 (1K).
Galleria di esempi visivi e GIF animate
Ogni contenuto visivo qui sotto è stato generato tramite la pipeline GPT Image 2.6 e ospitato sulla CDN di E2X (assets.e2x.ai), mostrando le animazioni .gif multi-frame in loop di Flare, rendering commerciali nitidi di prodotti, tracciati vettoriali .svg scalabili e un confronto affiancato con Sunburst Max.
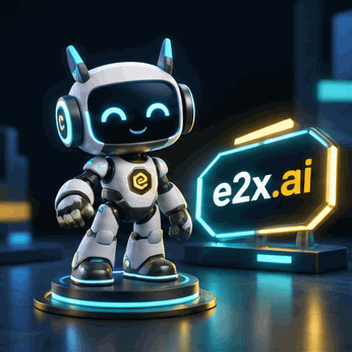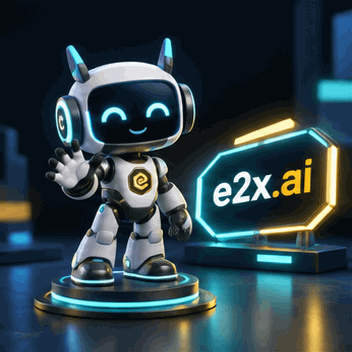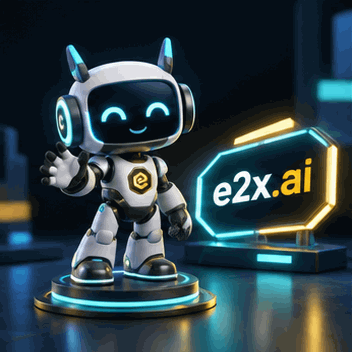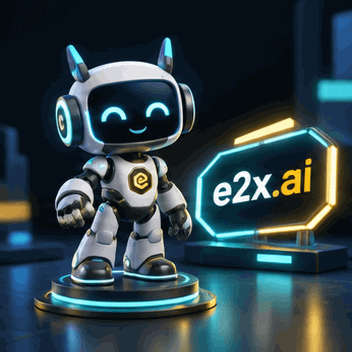
- Endpoint:
openai/gpt-image-2.6-flare/text-to-image (output_format: "gif", aspect_ratio: "1:1", frame_count: 8, frame_duration_ms: 150, 352×352)
- Prompt:
"A cute 3D isometric cyber-robot mascot character waving cheerfully beside a glowing cyan and gold neon badge reading \"e2x.ai\" in a sleek dark studio, smooth looping animation"
- Endpoint:
openai/gpt-image-2.6-flare/text-to-image (output_format: "gif", aspect_ratio: "16:9", 553×309)
- Prompt:
"Generate an animated GIF of a glowing neon cyberpunk ramen shop sign at night with animated rising steam from a holographic bowl and flickering magenta and cyan rain reflections, crisp neon text reading \"e2x.ai\", looping multi-frame animation"
Scatto commerciale di prodotto ad alta velocità: casco in fibra di carbonio (aspect_ratio: "1:1")
- Endpoint:
openai/gpt-image-2.6-flare/text-to-image (output_format: "png", aspect_ratio: "1:1", resolution: "1K", quality: "high")
- Prompt:
"An eye-catching editorial cyberpunk night photograph of a sleek futuristic matte-black carbon-fiber motorcycle helmet resting on a rain-slicked neon street podium in the center of the frame, with bold, crisp, ultra-legible glowing cyan-white LED typography reading \"e2x.ai\" illuminated across the curved iridescent visor. Dramatic electric blue and vibrant magenta anamorphic horizontal lens flares streak across the frame with neon bokeh reflections on the wet asphalt. Photorealistic 8K commercial shot."
- Formato di output:
output_format: "svg" (aspect_ratio: "1:1", 1024×1024 XML <svg> scalabile)
- Prompt:
"Clean geometric vector emblem badge for \"e2x.ai\" featuring a stylized radiant sunburst prism and orbital rings in vibrant gold, cyan, and deep obsidian navy, crisp flat vector paths"
Confronto affiancato tra Sunburst Max e Flare High (aspect_ratio: "16:9")
- Confronto visivo (
16:9, 1672×941): Dettaglio macro del tourbillon scheletrato su Sunburst Max contro fotografia commerciale di prodotto in titanio ad alto contrasto su Flare High.
- Prompt:
"Split-screen visual comparison in a luxury studio: on the left side under a warm golden badge reading \"SUNBURST MAX\", an ultra-intricate macro photograph of an open-worked tourbillon mechanical watch with engraved gold bridges reading \"e2x.ai\" and warm sunburst lighting; on the right side under a sleek cyan badge reading \"FLARE HIGH\", a high-contrast commercial product shot of a matte titanium smartwatch on wet dark basalt with electric cyan lens flare"
Come i moltiplicatori di risoluzione e qualità influiscono sulla fatturazione
Ogni chiamata a openai/gpt-image-2.6-flare/text-to-image parte da una tariffa base di listino di $0.03 (30,000 micro-centesimi), ridotta dal nostro sconto globale fisso del 75% a una base scontata di $0.0075 (7,500 micro-centesimi), e viene poi moltiplicata per due fattori dello schema:
- Moltiplicatore
resolution: 1K (predefinito) è ×1, 2K è ×2 e 4K è ×3.
- Moltiplicatore
quality: low, medium (predefinito) e high applicano tutti un moltiplicatore ×7.
Poiché ogni valore di quality (low, medium, high) moltiplica per 7 la base scontata di $0.0075, resolution è l'unico parametro che modifica il costo per immagine. L'invio di quality: "low" costa gli stessi $0.0525 in 1K di high, quindi conviene scegliere low solo quando desideri la latenza di anteprima più bassa possibile (~6 s) e usare high come impostazione predefinita per gli asset di produzione senza costi aggiuntivi.
Ecco la tabella tariffaria verificata il 6 novembre 2026 rispetto alle tariffe on-demand di fal.ai:
| Risoluzione | Moltiplicatore | Prezzo di listino E2X ($0.03 × 7) | Prezzo E2X (-75%) | fal.ai (fascia alta) | Risparmio su E2X |
|---|
1K (predefinito) | ×1 × 7 | $0.21 | $0.0525 | $0.211 | 75% in meno |
2K | ×2 × 7 | $0.42 | $0.1050 | $0.222 | 53% in meno |
4K | ×3 × 7 | $0.63 | $0.1575 | $0.401 | 61% in meno |
Questa curva definisce il modo ottimale per strutturare una pipeline iterativa. Mantieni resolution a 1K ($0.0525) mentre testi composizione, illuminazione e scritte tra virgolette a high. Dieci iterazioni in 1K più un singolo rendering master in 4K ($0.1575) costano in totale $0.6825, rispetto a $1.7325 se eseguissi tutte le undici chiamate in 4K.
I prezzi e i termini dei prodotti possono variare. Verifica i prezzi attuali di ciascun fornitore prima di prendere una decisione d'acquisto. I prezzi Google Batch o Flex non sono direttamente equivalenti a una richiesta API standard on-demand poiché le condizioni di pianificazione, disponibilità ed elaborazione differiscono; sono pertanto esclusi da questo confronto. Questo è un confronto circoscritto, non un'affermazione che E2X sia l'opzione più economica al mondo in ogni configurazione.
Cosa cambia in GPT Image 2.6 Flare rispetto a Sunburst e 2.5
Il prezzo è identico tra GPT Image 2.6 Flare, GPT Image 2.6 Sunburst e GPT Image 2.5 Flare ($0.0525 in 1K, $0.105 in 2K, $0.1575 in 4K), quindi la scelta dipende da quattro aggiornamenti architetturali della versione 2.6:
- Output nativo
.gif animato e .svg vettoriale (output_format). Oltre a png (predefinito), jpeg e webp, openai/gpt-image-2.6-flare/text-to-image accetta output_format: "gif" e output_format: "svg". Impostando "gif" vengono generate animazioni multi-frame in loop direttamente da un prompt di testo (gli schemi supportano da 2 a 16 fotogrammi e durate da 20 a 2,000 ms per fotogramma, allineando le dimensioni a multipli di 16). Impostando "svg" vengono generati tracciati grafici vettoriali XML <svg> puliti e scalabili per icone, badge e illustrazioni UI.
- Inferenza 2×–2.5× più veloce su 3 livelli di qualità (
low, medium, high). GPT Image 2.6 Flare punta sulla generazione ad alto throughput (~6 secondi a qualità low) tra low, medium (predefinito) e high. Quando hai bisogno dei livelli di qualità xhigh o max per spaccati meccanici complessi o poster densi multi-paragrafo, passa a GPT Image 2.6 Sunburst esattamente allo stesso prezzo di $0.0525 (1K).
- 15 rapporti d'aspetto fissi e pianificazione spaziale. GPT Image 2.6 Flare supporta 15 rapporti d'aspetto (
1:1, 1:2, 2:1, 1:3, 3:1, 2:3, 3:2, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 9:21, 21:9), con 1:1 come predefinito, supportati dalla pianificazione spaziale pre-disegno (complexity: low, medium, high).
- Fino a 16 immagini di riferimento su
edit-image. La rotta complementare GPT Image 2.6 Flare edit-image espande image_urls da 10 a 16 immagini di riferimento con prompt di modifica da 50,000 caratteri, inpainting con maschera (mask_image) e guida tramite markup visivo (markup_image).
Invio di un job di generazione tramite l'API E2X
Ogni modello su E2X utilizza la stessa coda di job asincrona. Invia un payload JSON tramite POST a https://api.e2x.ai/v1/jobs/submit usando il tuo token Bearer ed esegui il polling su https://api.e2x.ai/v1/jobs/{jobId} finché lo stato non raggiunge completed, oppure passa un webhookUrl nel payload di invio.
Solo prompt è obbligatorio (fino a 32,000 caratteri). Ecco un esempio curl che genera una mascotte .gif animata a risoluzione 1K e qualità high ($0.0525):
curl -X POST https://api.e2x.ai/v1/jobs/submit \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "openai/gpt-image-2.6-flare/text-to-image",
    "input": {
      "prompt": "A cute 3D isometric cyber-robot mascot character waving cheerfully beside a glowing cyan and gold neon badge reading \"e2x.ai\" in a sleek dark studio, smooth looping animation",
      "aspect_ratio": "1:1",
      "resolution": "1K",
      "quality": "high",
      "output_format": "gif"
    }
  }'
Per la generazione raster ad alta risoluzione o vettoriale .svg, imposta output_format su "png", "webp" o "svg" e porta resolution a 2K ($0.105) o 4K ($0.1575) nel tuo codice Node.js:
const headers = {
  Authorization: `Bearer ${process.env.E2X_API_KEY}`,
  "Content-Type": "application/json",
};

const submitRes = await fetch("https://api.e2x.ai/v1/jobs/submit", {
  method: "POST",
  headers,
  body: JSON.stringify({
    model: "openai/gpt-image-2.6-flare/text-to-image",
    input: {
      prompt: 'Editorial cyberpunk night photograph of a matte-black carbon-fiber motorcycle helmet on a neon street podium with glowing cyan-white LED typography reading "e2x.ai" across the visor, electric blue anamorphic lens flare.',
      aspect_ratio: "16:9",
      resolution: "2K",
      quality: "high",
      output_format: "png",
    },
  }),
});

const { data: submitted } = await submitRes.json();

for (let poll = 0; poll < 120; poll++) {
  await new Promise((r) => setTimeout(r, 3000));
  const statusRes = await fetch(
    `https://api.e2x.ai/v1/jobs/${submitted.jobId}`,
    { headers }
  );
  const { data: job } = await statusRes.json();

  if (job.status === "completed") {
    console.log("Generated asset URL:", job.outputs[0].url);
    break;
  }
  if (job.status === "failed" || job.status === "cancelled") {
    throw new Error(job.error?.message || `Job ended with status ${job.status}`);
  }
}
Due note implementative da tenere a mente: i valori di resolution devono essere in maiuscolo (1K, 2K, 4K) e gli URL di output restituiti in data.outputs devono essere copiati nel tuo bucket di archiviazione se prevedi di servirli a lungo termine. Lo schema completo è pubblicato nella nostra specifica del modello leggibile dalla macchina e le librerie client ufficiali sono elencate nella pagina degli SDK E2X.
Come scegliere il modello text-to-image giusto su E2X
Scegli tra i nostri endpoint OpenAI e Google in base al fatto che la tua pipeline dia priorità alla velocità, al dettaglio xhigh/max, alla sintesi nativa .gif e .svg, ai ritagli PNG trasparenti o ai banner 4K economici:
| Modello | Prezzo 1K | Prezzo 4K | Risoluzione max | Formati di output | Caso d'uso ideale |
|---|
| GPT Image 2.6 Flare | $0.0525 | $0.1575 | 4K | png, jpeg, webp, gif, svg | Generazione ad alta velocità su 3 livelli (low, medium, high), GIF animate, SVG vettoriali, feed UI interattivi |
| GPT Image 2.6 Sunburst | $0.0525 | $0.1575 | 4K | png, jpeg, webp, gif, svg | Qualità di punta a 5 livelli (xhigh e max senza costi extra) per tipografia densa e dettaglio macro |
| GPT Image 2.5 Flare | $0.0525 | $0.1575 | 4K | png, jpeg, webp | Flussi legacy 2.5 che richiedono aspect_ratio: "auto" |
| GPT Image 2 | $0.0525 | $0.1575 | 4K | png, jpeg, webp | Ritagli PNG trasparenti nativi (background: "transparent") allo stesso prezzo |
| Nano Banana 2.1 | $0.0300 | $0.0900 | 4K | png, jpeg, webp | Prezzo 4K più basso ($0.09) e rapporti banner estremi 8:1 / 1:8 |
| Nano Banana 2 Lite | $0.0238 | — | 1K | png, jpeg, webp | Generazione batch 1K ad alto volume a meno di 2.5 centesimi |
Confronta ogni capacità fianco a fianco nella categoria text-to-image o esplora l'intero catalogo modelli E2X.
Limiti e note operative
- Rate limit e concorrenza: L'endpoint consente fino a 100 richieste al minuto, 5,000 richieste all'ora, 50,000 richieste al giorno e 100 job concorrenti per account.
- Tempo di elaborazione: Le anteprime 1K di livello
low possono completarsi in ~6 secondi, mentre la qualità high, la generazione .gif multi-frame e i passaggi di upscaling 2K/4K richiedono in media dai 15 ai 60 secondi. Usa webhook o un intervallo di polling di 3 secondi in produzione.
- Limiti dei rapporti d'aspetto: I 15 rapporti supportati spaziano dai formati orizzontali
3:1 e 21:9 ai formati verticali 1:3 e 9:21 (1:1, 1:2, 2:1, 1:3, 3:1, 2:3, 3:2, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 9:21, 21:9). Se un layout richiede intestazioni a nastro 4:1 o 8:1, indirizza quel job a Nano Banana 2.1.
- Metadati di provenienza: Gli output della famiglia di immagini OpenAI includono metadati di provenienza C2PA standard e marcatori di attribuzione a livello di pixel che le piattaforme social leggono per mostrare le etichette di generazione IA.
Consigli di prompting per GPT Image 2.6 Flare
Con un limite di 32,000 caratteri, scrivi frasi dichiarative dirette ordinate dal soggetto principale fino all'illuminazione e alle indicazioni di formato:
- Soggetto e finitura superficiale per primi: Indica l'oggetto centrale, la texture del materiale e l'angolazione della fotocamera ("casco da moto in fibra di carbonio nero opaco centrato su un podio stradale al neon bagnato dalla pioggia").
- Testo esatto tra virgolette: Racchiudi il testo dei badge, le insegne dei negozi o le etichette UI tra doppie virgolette e richiedi
quality: "high" affinché i caratteri vengano renderizzati in modo nitido senza alterazioni.
- Loop di movimento per
output_format: "gif": Specifica un oggetto di ancoraggio fisso più un'azione ciclica continua ("che saluta allegramente accanto a un badge al neon luminoso, animazione fluida in loop") per ottenere loop GIF multi-frame puliti.
- Struttura vettoriale per
output_format: "svg": Richiedi forme geometriche piatte, contorni puliti e palette di colori a tinta unita ("badge emblema vettoriale geometrico pulito, tracciati vettoriali piatti e nitidi") quando esporti file SVG scalabili.
Per un approfondimento su come i modelli OpenAI e Google interpretano la struttura del prompt, consulta la nostra guida alla scelta del generatore di immagini e la nostra guida alle pipeline di generazione automatizzata di immagini.
Domande frequenti
Quanto costa GPT Image 2.6 Flare text-to-image su E2X?
Con il nostro sconto del 75%, GPT Image 2.6 Flare costa $0.0525 per immagine a resolution: "1K" (il valore predefinito), $0.105 per immagine a resolution: "2K" e $0.1575 per immagine a resolution: "4K", indipendentemente dal fatto che tu scelga la qualità low, medium o high oppure il formato di output png, jpeg, webp, gif o svg.
Come viene calcolato il prezzo di $0.0525 a partire dalla tariffa base?
La tariffa base di listino è di $0.03 per richiesta, che il nostro sconto globale del 75% riduce a $0.0075. Ogni impostazione di quality (low, medium, high) applica un moltiplicatore ×7 ($0.0075 × 7 = $0.0525), e resolution moltiplica ulteriormente l'importo (1K = ×1, 2K = ×2, 4K = ×3).
Passare dalla qualità low o medium a high costa di più?
No. Tutti i tre livelli di qualità (low, medium, high) hanno lo stesso moltiplicatore ×7 su E2X ($0.0525 in 1K). Solo resolution (1K, 2K, 4K) modifica il costo per immagine. Usa low quando desideri bozze rapide in ~6 secondi e usa high per i rendering finali. Se hai bisogno dei livelli di qualità xhigh o max, utilizza GPT Image 2.6 Sunburst esattamente alla stessa tariffa.
Come posso generare GIF animate e SVG vettoriali con GPT Image 2.6 Flare?
Imposta "output_format": "gif" nel payload di input per sintetizzare una GIF animata multi-frame in loop dal tuo prompt di testo, oppure imposta "output_format": "svg" per generare tracciati grafici vettoriali XML <svg> puliti. Sono supportati anche i formati raster standard ("png", "jpeg", "webp").
In cosa differisce GPT Image 2.6 Flare da GPT Image 2.6 Sunburst?
GPT Image 2.6 Flare è ottimizzato per la velocità e la produzione ad alto volume su tre livelli di qualità (low, medium, high), girando fino a 2×–2.5× più velocemente di 2.5 Flare. GPT Image 2.6 Sunburst aggiunge i livelli di qualità xhigh e max per un ragionamento spaziale più profondo e micro-tipografia densa. Entrambi i modelli costano esattamente gli stessi $0.0525 in 1K su E2X.
Quali rapporti d'aspetto supporta GPT Image 2.6 Flare?
Accetta 15 rapporti d'aspetto fissi, con 1:1 come predefinito se omesso: 1:1, 1:2, 2:1, 1:3, 3:1, 2:3, 3:2, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 9:21 e 21:9.
Qual è la lunghezza massima del prompt e il limite di immagini di riferimento?
Il campo prompt accetta fino a 32,000 caratteri su openai/gpt-image-2.6-flare/text-to-image. Se hai bisogno di fino a 50,000 caratteri insieme a un massimo di 16 immagini di riferimento (image_urls), utilizza l'endpoint complementare GPT Image 2.6 Flare edit-image.
 Immagine
 openaiNuovo