Gemini Omni 1.1 Flash のショットの連続性 — どのエンドポイントがどの漂流を直すか
Google は同じローンチでこのモデルについて 2 つの文を公開しており、それらは反対の方向を指しています。
ひとつめは発表にあります。Omni はクリップを継続するとき、いまや 「最大 10 秒分の直前の文脈 — 最後の 1 秒しか参照しなかった従来のモデルからの飛躍」 を読みます。記憶が 10 倍です。ふたつめは DeepMind のモデルカードの、限界の項にあります。「編集の全体を通して完全な一貫性を維持すること、複雑な動きを含むシーンを生成すること、完全に正確なテキストを描画することは、依然として課題として残っています」。
どちらも本当のことで、2 つ合わせるとこの仕事が describe されます。ここでの連続性は、有効にするスイッチではなく、入力のところで下す一連の選択です。どのエンドポイントを呼ぶか、画像で何を留めるか、どの文を一言一句そのまま繰り返すか。4 つに分けたシーケンスの費用は別の議論であり、ここで蒸し返すことはしません。
4 つのエンドポイント、止めておくものが 4 通り
E2X では gemini-omni-1.1-flash が 4 つの機能としてひとつの価格で出荷されています。どれを呼んでも 4K で 1 秒あたり $0.18 です。それは考え方を変えます。この 4 つのあいだの選択は、決して予算の判断ではなく、手仕事の判断だけになるのです。
それぞれが何を留めるかです。
| 機能 | 止めておくもの | 止めておかないもの |
|---|---|---|
| text-to-video | あなたの言葉だけ | 書き留めなかったものすべて |
| image-to-video | 冒頭のフレームを、正確に | おおよそ最初の 1 秒より後のすべて |
| start-end-frame-to-video | ショットの両端 | その 2 点のあいだの道筋 |
| reference-to-video | 被写体の同一性と見た目 | フレーミング、立ち位置、カメラ位置 |
これは機能の一覧ではなく診断の表として読んでください。目にしている漂流を名指しして、それに対処するエンドポイントを選ぶのです。
ショットの始まりが違う。 2 つめのアングルが別の部屋で始まる、あるいはキャラクターが動作の途中の状態で歩いてくる。フレームを与えてください。image-to-video は静止画を受け取ってそこから始めるので、ショット 2 はショット 1 の最後のフレームからの切り出し、あるいは先に承認済みの静止画レンダリングから始められます。このモデルが提供するなかで最も安い連続性の対処です。
ショットの終わりが違う。 動きは正しいのに着地が正しくない。手がドアに伸びるのに、ドアが別の場所にある。それが start-end-frame-to-video です。start_frame_url と end_frame_url を渡すと、モデルがそのあいだを埋め、次のカットが合わせなければならないフレームは、渡されたものではなくあなたが選んだものになります。
人が変わる。 フレーミングでも立ち位置でもなく、顔、髪、ジャケットが変わる。それが reference-to-video で、4 つのなかで唯一、同一性を目的にしたものです。当社の image_urls の配列は最小 1、最大 7 を受け付けます。Runware も同じ上限をドキュメント化しており — 「最大 7 枚の画像」 — 一方 Google のリファレンスは数を明記していませんが、その実例は 6 つのタグを走らせています。7 は公開された保証ではなく、第三者のあいだの合意として扱ってください。
映像の参照はもっと厳しく制限されており、そちらの数字は Google が公開しています。「映像の参照は最大 3 本のクリップ、それぞれ最大 3 秒まで対応します」、そして 「複数の映像をまたいで参照したり推論したりすることには対応していません」。3 は埋めるべき目標ではなく、近づいていく上限です。参照画像に何を入れるべきかについては、Runware のドキュメントが Google のものより具体的で、きれいなミドルショットのポートレート — 腰から上のフレーミング、無地の背景、識別できる細部が見えていること — を勧めています。「全身のショット、雑然とした背景、極端なアングルは、キャラクターについてのモデルの読み取りを薄めます」 からです。
seed が留めるもの、留めないもの
このエンドポイントにサンプラーはありません。Google のドキュメントは素っ気ないほど明快です。「システム指示、temperature、top_p、停止シーケンス、そしてネガティブ prompt には対応していません」。サンプリングの面がないということは、再現性の制御はひとつだけということであり、それが seed です。当社の 4 つの機能のスキーマがすべて受け付ける、任意の整数です。
このフィールドがどこから来たのかは知っておく価値があります。Google のリファレンスにはまったく載っていないからです。Runware の 1.1 のドキュメントは seed を持ち、渡さなかった場合には 「ランダムに生成された seed」 を返すと述べています。当社はこのフィールドをすべての機能で露出しています。そして Google は、あなたが最初に確認するであろうページで、何も言っていません。使ってください。ただし契約として扱わないでください。
人がつまずくのはここです。seed が留めるのはサンプルであって、被写体ではありません。同じ seed とバイト単位で同一の prompt なら、それは繰り返しです。同じ seed で 1 語だけ編集すれば、それは新しい抽選です。押し引きではなく、新しくサンプリングし直しているのです。これは temperature のつまみとは正反対であり、seed を保ったまま prompt を調整するという画像モデルの習慣は、ここへは移せないということを意味します。
その結果、複数ショットの仕事において seed が有用なのはちょうど 2 つのことに対してで、3 つめには役立ちません。
- 本番のテイクを上のティアでレンダリングし直すとき。 下書きしてテイクを見つけ、それから同じ prompt と seed を納品解像度で回します。何も変わっていないので、何も再サンプリングされません。
- 変数をひとつだけ切り分けるとき。 照明の文を変え、seed を保てば、動いたものはその文に帰属できます。統制された実験ではありませんが、当てずっぽうに再サンプリングするより速いです。
- 2 つの異なるショットのあいだで顔を持ち運ぶとき。 これはできません。2 つの prompt は 2 つの prompt であり、seed はあなたのキャラクターを覚えていません。ショットをまたいだ同一性は、整数ではなく参照画像から来ます。
テイクがうまくいったその瞬間に、prompt の隣に seed を書き留めてください。あとからそれを復元できる履歴はありません。
ロックブロック — 同じ段落を、一言一句そのまま繰り返す
text-to-video の呼び出しは前回の呼び出しの記憶を持たないので、世に出回っている最もよくある連続性の指示は、誰に向けても発せられていません。「Keep everything consistent with the previous shot」は、モデルが一度も見たことのないショットを指しているのです。
対処は地味です。外見と場のセットに関する事実をひとつのブロックに書き、それをシーケンスのすべての prompt に、変えずに貼り付けてください。言い換えず、引き締めず、並べ替えずに。新しい記述は、新しい抽選です。
2 ショットからなるシーケンスの、同じ 2 つめのショットの 2 通りの版です。まず漂流するほうから。
Continuing the same scene, a tighter shot of the same man at his
workbench in the garage. Cinematic lighting, moody atmosphere,
highly detailed, professional colour grading. He lifts the machined
part into the light and turns it slowly while his colleague watches
from the right. Keep the characters and the location consistent
with the previous shot. Single continuous shot, no scene cuts.
Sound design: workshop room tone and quiet handling noise.
この prompt が留めていないものを数えれば、そのまま自由に変わってよいものの一覧になります。ジャケットの正確な緑、袖口がほつれているかどうか、そもそもバンダナがあるかどうか、有孔ボードに何が掛かっているか、光がどこから来るか。どれも書き留められていないので、どれもあなたに約束されてはいません。別の午後を撮った有能なショットは、頼まれたことに対する正しい答えなのです。
書き直しは動作を保ち、形容詞ではなく事実に言葉を使います。
In a single continuous shot, no scene cuts. Medium two-shot in a
cluttered garage workshop, 40mm lens at f/4, both subjects sharp.

[Lock - repeat verbatim in every shot of this sequence]
Man: mid-forties, close-cropped grey hair parted on his left, faded
green canvas work jacket, frayed left cuff, oil stain on the right
pocket, steel watch on his left wrist. Woman: thirties, dark hair
tied back, grey knit sweater, red bandana at her neck, clipboard in
her right hand. Set: steel workbench, pegboard behind with three
wrenches hanging left of centre, one overhead fluorescent tube,
cold white key from above, no window light.

Action: he lifts a machined aluminium part into the light and turns
it once; she does not move. Sound design: fluorescent hum, the part
clicking down onto steel. No dialogue.
角かっこのラベルはモデルではなくあなたのためのもので、コピーする範囲を示しています。ブロックに載る資格があるのは、非対称なもの、あるいは傷んでいるものです。髪をどちら側で分けているか、どちらの袖口がほつれているか、どちらの手首に時計があるか、どちらの手がクリップボードを持っているか。対称性は漂流が隠れる場所です。左右が入れ替わった対称的な細部は、単体では正しく見えて、カットのなかでは間違って見えるからです。色の名前もそこに属しますし、光もそうです。方向、硬さ、そして望まない光源が明示的に存在しないことも。
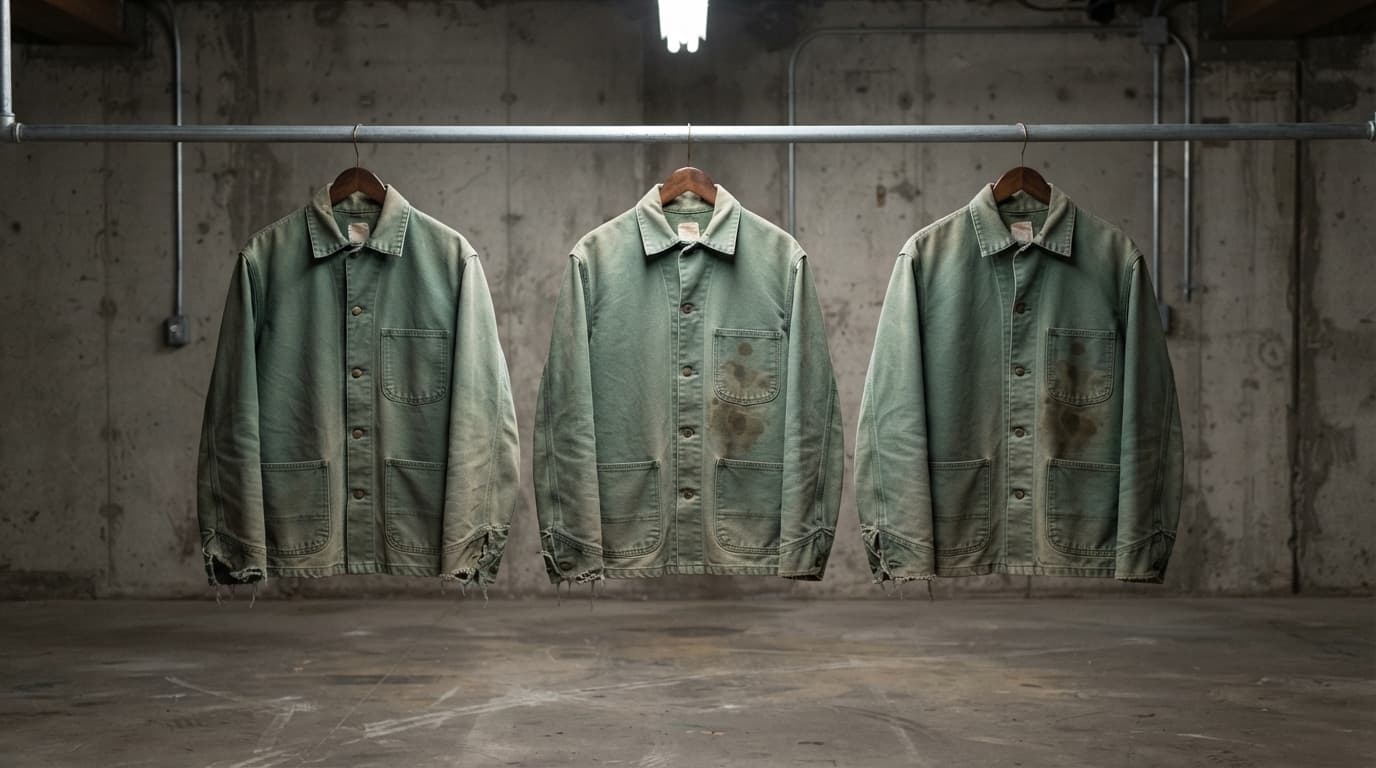
ブロックから外しておくべきものがひとつあります。印刷されたラベル、看板、小道具の上の読めるテキストです。モデルカードは正確なテキストを未解決の問題に挙げているので、2 つのショットで同じに読めなければならない小道具は、使える錨のなかで最も当てにならないものです。代わりに形と染みに錨を下ろしてください。
延長は前へ進むので、逆から計画する
Google の言い回しに余地はありません。「映像の延長は、映像の末尾に追記することに限られます。前に足したり、クリップの途中を延長したりすることには対応していません」。継続は 10 秒刻みで 「合計 40 秒まで」 走り、アップロードしたクリップは延長する前に 「長さが 10 秒以下」 でなければなりません。
計画上の帰結は見た目より大きいものです。連鎖には取り消しがありません。ショット 1 は、そこに追記されるすべてについてパレット、光、カメラの文法を決めるので、そこでの誤りは、撮り直すべきショットではなく、作り直すべきシーケンスになります。そして最も危ないショット — 難しい動作、やっかいな反射 — はたいてい真ん中に座っており、それはまさに手の届かない場所です。
ですから最初の呼び出しの前に、構造上の選択をひとつしなければなりません。
- ひとつの延長の連鎖は、本物のフレームからフレームへの継続と、モデルが実際に読む 10 秒の文脈を買ってくれます。その代わり、末尾以外を直す能力を失います。
- 編集ソフトでつなぐ独立した生成は、参照画像か開始フレームでそれぞれを錨づけするもので、継ぎ目のない接合を失う代わりに、ショット 1 と 2 に触れずにショット 3 を 30 回引き直せる能力を買えます。
目に見えてカットしてはいけないアクションなら、延長してください。どのみちカットが入るシーケンスなら、別々に生成してください。そちらはクライアントの指摘を生き延びる選択肢でもあり、たいていのシーケンスには指摘がひとつは付きます。
このクリップは、2 つのショットをつないだものではなく、1 回の生成がリフレームを抱えたものです。
A two-shot in a cluttered garage workshop, 40mm lens at f/4, both
subjects sharp. A man in a faded green work jacket with a torn left
cuff stands at the bench; a woman in a grey knit sweater with a red
bandana tied at her neck stands to his right holding a clipboard.
The camera holds the wide two-shot for four seconds while he lifts
a machined aluminium part into the light and turns it. Then the
camera pushes in and reframes to a tighter two-shot from the same
axis - same jacket, same torn cuff, same bandana, same bench clutter
behind them, same overhead fluorescent light. No cut, no wardrobe
change, no relight. Sound: fluorescent hum and the part clicking
down onto steel.
カット点は音のカット点でもある
音声は絵と一緒に生成され、それを断るスイッチはありません。ふつうこれはサウンドデザインの項目に分類されますが、連続性にとっては制約です。あなたのカットは、自分で作曲したのでもなく、音源のところで刈り込むこともできないサウンドトラックの真ん中に着地するからです。
そこから 2 つのルールが出てきます。カットの両側で、環境音を同一の言葉で describe してください。衣装のブロックを繰り返すのと同じやり方です。両方の prompt で「fluorescent hum」であって、片方が「fluorescent hum」でもう片方が「the buzz of the overhead light」ではいけません。継ぎ目でずれるルームトーンは、色味のずれるジャケットより無視しにくいものです。耳には、その裏に隠れられるショットの境界がないからです。
そして、どこでカットするかを音を意識して選んでください。動作の途中でカットすることは、向こう側で同じモーションベクトルを再現することをモデルに要求します。それこそがモデルカードが指摘する 「complex motion」 の場合です。落ち着いたポーズ — 部品が置かれ、手が止まっている — でカットすれば、次の生成には曖昧さのない開始条件が、音声には自然な継ぎ目が与えられます。テンポの一拍を犠牲にして、保つ接合を買うのです。
このすべての前に決めておくべき事柄がひとつあります。アスペクト比です。モデルが提供するのは 16:9 と 9:16 だけで、他はありません。延長は追記しかできず、参照画像は撮られたときのフレーミングを引き継ぐので、シーケンスの途中で向きを切り替えることは設定の変更ではありません。それより上流のすべての素材を無効にします。ショット 1 の時点で、納品を意識して向きを選んでください。
4 ショットのシーケンスの費用
このモデルの連続性のための道具立ては無料です。7 枚の画像を伴う reference-to-video の呼び出しは、素の text-to-video の呼び出しと同じ費用ですし、start-end-frame-to-video に渡すフレームは何も足しません。払うのは秒数と解像度に対してです。
8 秒のショット 4 つで 32 秒です。最上位のティアでは次のようになります。
| どこで | 4K で 32 秒 |
|---|---|
| E2X | $5.76 |
| Google、公開されているトークン料金から | $9.73 |
| fal | $9.60 |
| Runware | $10.24 |
| WaveSpeed | $12.48 |
この差は値引きの話ではなく、倍率の話です。どちらのはしごも 360p から 1080p までは同じように上りますが、一番上の段で Google は 720p の料金を 3 倍にし、当社は 2 倍にするので、開きは完成したシーケンスが納品されるまさにその場所で最大になります。ティアごとの計算と、最上位のティアがアップスケールである理由は、当社の 4K の記事にあります。
ではそれを、連続性の仕事の進み方に当てはめてみましょう。4 つのショットを 4 回の生成で決められる人はいません。ショット 3 に 6 回、ショット 4 に 3 回かかれば、それで 15 本のジョブになります。4K で当社は $21.60、直接なら $36.49 です。これは、ひとつの連鎖よりも独立した生成のほうが良いという最も強い論拠です。引き直しにかかるのは 1 ショットぶんであって、シーケンスの末尾ぶんではありません。連続性のテストは、1 秒あたり 4K の 6 分の 1 の料金で済む 360p で回し、良いテイクを昇格させてください。
それでも滑るところ
正直な版です。モデルカードがそのための言葉を与えてくれているので。
この分かれ目は、2 つの仕組みが符号化できるものから出てきます。文と参照写真は、粗く名指しできる性質を運びます。シルエットと衣服の色、髪の長さと色、部屋のジオメトリ、パレット、光の方向と硬さ、大きな小道具のおおよその配置。それらはロックブロックが述べられるものであり、参照画像が見せられるものです。
どちらも運ばないのは、名前のレベルより細かい精度です。離れたフレーミングどうしのあいだの正確な顔のジオメトリ、装身具、小さな背景の物体、細かい生地のディテール、そして印刷されたものすべて。最後のものはモデルカードが別途、当てにならないと挙げています。Google はこのパターンを一般的な言葉でしか名指ししておらず、第三者のレビュアーたちは、それが最も強く現れるのは保たれたショットのなかではなく、シーンの切り替わりとカメラの動きだと describe しています。これはドキュメントと報道についての当社の読みであって、計測された主張ではありません。当社は、それに数字を付けられるような装置を回していません。
実務的には、ヒーローのクローズアップを含むシーケンスでは、そのクローズアップを引きから引き継ぐのではなく、参照のセットから生成する必要があります。同一性は、スケールの変化よりリフレームのほうをよく生き延びるからです。単一ショットの顔の技法そのものはそれ自体が 1 本の記事であり、2 つのショットを同じ軸に保つカメラの語彙はカメラの記事にあります。
このモデルで 30 ショットの物語を売り込んで、決して動かない顔を約束すべき人はいません。売れるのは、漂流がカットのなかに収まる程度に小さいシーケンスです。参照、ロックブロック、そして静止を基準に選んだカット点で、そこには手が届きます。
冒頭の表から始めてください。漂流を名指しし、道具を選び、ブロックを一度書き、それを正確に繰り返す。Google の API リファレンスには参照を名前で束ねるためのタグの形式があり、機能のページには現在の料金とスキーマがあります。
価格と製品の条件は変わります。購入の判断をする前に、各プロバイダーの現在の価格を確認してください。
よくある質問
Gemini Omni 1.1 Flash でショットをまたいでキャラクターを一貫させるにはどうしますか?
2 つの仕組みを組み合わせます。reference-to-video を通してキャラクターを参照画像として渡し — 当社のスキーマは 1 枚から 7 枚を受け付け、Runware も同じ上限をドキュメント化しています — そして外見の事実をまとめた同一のブロックを、言い換えではなくコピーして、すべての prompt で繰り返してください。参照が同一性を運び、繰り返されたテキストが衣装、小道具、光を運びます。Google のモデルカードは、編集をまたいだ完全な一貫性はいまだ未解決だと明言しているので、どちらか一方だけでは足りません。
seed は 2 つの Gemini Omni の prompt のあいだで同じキャラクターを保ちますか?
いいえ。seed が留めるのはサンプルであって、被写体ではありません。異なる 2 つの prompt は、seed が何であれ 2 つの異なる抽選ですし、それ以外は同一の prompt で 1 語編集することも、変奏ではなく新しいサンプルです。seed が元を取るのは、承認済みのテイクをより高い解像度でレンダリングし直すときと、変更した文をひとつだけ切り分けるときです。ショットをまたいだ同一性は参照画像から来ます。
特定のフレームで終わらなければならないショットには、Omni のどの機能を使うべきですか?
start-end-frame-to-video です。開始と終了の画像を渡すと、モデルがそのあいだを生成し、次のカットが合わせなければならないフレームは、あなたが選んだものになります。E2X では素の text-to-video と 1 秒あたりの料金が同じなので、これを避ける価格上の理由はありません。
Gemini Omni 1.1 Flash は映像を後ろ向きに延長できますか?
いいえ。Google のドキュメントは、延長はクリップの末尾に追記することしかできず、前に足したり途中を延長したりする手段はないと述べています。継続は 10 秒刻みで合計 40 秒まで走り、延長するクリップ自体は 10 秒以下でなければなりません。ですから最初の生成が、それ以降のすべてについて見た目を決めてしまい、早い段階の誤りは連鎖を作り直さないかぎり修復できません。
Gemini Omni 1.1 Flash は参照画像を何枚まで受け付けますか?
当社の reference-to-video のスキーマは 1 枚から 7 枚を受け取り、Runware のドキュメントも同じ上限を述べています。Google 自身のリファレンスは数を公開していませんが、その実例はひとつの prompt で 6 枚のタグ付き画像を束ねています。ですから 7 は、ドキュメント化された保証ではなく第三者のあいだの合意として扱ってください。映像の参照は Google によって別途、それぞれ最大 3 秒のクリップ 3 本までに制限されています。
生成した 2 つのショットのあいだで、カットに最も良い場所はどこですか?
動きの途中ではなく、静止しているところです。落ち着いたポーズは、次の生成に曖昧さのない開始条件を与えます。動作のなかでカットすることは、Google のモデルカードが既知の弱点として挙げている complex motion の場合そのものであり、モーションベクトルの再現をモデルに求めることになります。そして、どのクリップも断れないサウンドトラックを伴って届くので、継ぎ目の両側で環境音を同一の言葉で describe してください。さもないとカットのところでルームトーンがずれます。
ひとつの Omni のシーケンスで 16:9 と 9:16 のショットを混ぜられますか?
有用なかたちではできません。選べる比はこの 2 つだけですし、延長は始まったときの向きで追記し、参照画像は撮られたときのフレーミングを運ぶので、途中で向きを変えると上流のすべての素材が無効になります。ショット 1 の前に、納品フォーマットに照らして横位置か縦位置かを決めてください。
シーケンスを組み立てるには、延長と別々の生成のどちらが安いですか?
1 秒あたりの料金はどちらでも同じで、延長に割引はありません。ですから違いは、引き直しにいくらかかるかです。連鎖では、早い段階のショットを直すと、それに追記したすべてが捨てられます。参照画像や開始フレームで錨づけした独立した生成なら、失敗したショットの費用は 1 ショットぶんです。E2X では 4K の 32 秒が $5.76、Google から直接なら $9.73 で、その差は捨てるテイクが増えるたびに広がります。